Inicio
» Dominios
»
Guía paso a paso: Automatización del monitoreo semanal de la competencia mediante agentes de IA
Guía paso a paso: Automatización del monitoreo semanal de la competencia mediante agentes de IA
El monitoreo de la competencia suele fallar por una razón sencilla: la investigación está dispersa entre demasiadas pestañas, demasiadas personas y demasiadas definiciones de lo que constituye un cambio significativo. Una persona revisa las páginas de precios, otra observa las notas de la versión, alguien más escanea las noticias del sector y, para el viernes, el equipo tiene una pila de enlaces pero ninguna respuesta fiable a la pregunta que importa: ¿qué cambió esta semana y es relevante?
Un agente de IA puede reducir ese trabajo manual, pero el agente es solo una parte del sistema. Un flujo de trabajo semanal fiable también necesita una lista de fuentes, un formato de evidencia, una línea base de la semana anterior, un programador y un paso de revisión humana. Si omite estos elementos, puede automatizar el ruido con la misma eficiencia que la información valiosa.
Esta guía construye el flujo de trabajo desde las decisiones más fáciles hasta las más técnicas. La implementación concreta utiliza el SDK actual de Agentes de OpenAI y GitHub Actions porque su documentación oficial admite búsqueda web, salidas estructuradas, trazabilidad y flujos de trabajo programados. La arquitectura en sí es neutral en cuanto al proveedor: puede reemplazar cualquiera de los componentes si otro entorno de ejecución de agentes o programador se ajusta mejor a su pila tecnológica.
¿Qué debe hacer realmente un agente de monitoreo semanal de la competencia?
Como mínimo, el sistema debe responder a cuatro preguntas: qué cambió, de dónde provino la evidencia, cómo difiere el cambio del último estado conocido y si una persona debería prestar atención. "Agente de IA" aquí significa un flujo de trabajo basado en LLM que tiene instrucciones y herramientas y puede ejecutar una secuencia de acciones hacia un objetivo. El SDK actual de Agentes de OpenAI describe los agentes de esa misma manera general: un modelo configurado con instrucciones, herramientas y comportamiento de tiempo de ejecución opcional, como barreras de seguridad (guardrails) y salidas estructuradas. Consulte la documentación oficial del SDK de Agentes de OpenAI.
No diseñe la primera versión para "monitorear todo". Comience con un alcance pequeño que aún pueda auditar manualmente. Una vez que confíe en el flujo de trabajo, amplíelo.
Paso 1: Defina los competidores, las señales y las preguntas semanales
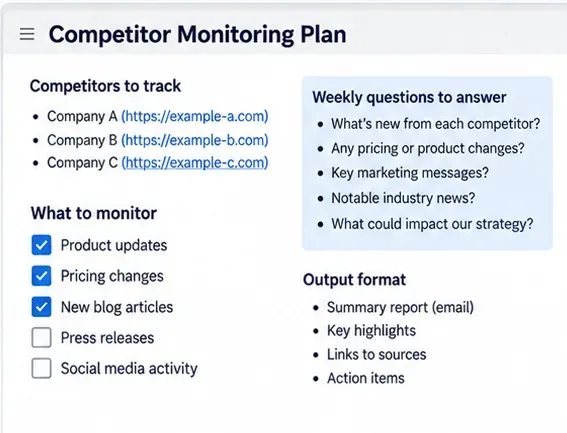
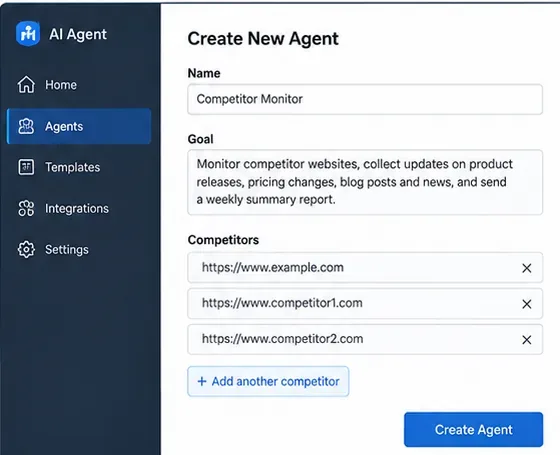
Cree un resumen de monitoreo antes de escribir cualquier código de agente. Para cada competidor, decida qué cambios vale la pena informar. Las señales típicas incluyen cambios públicos en los precios, lanzamientos de productos, notas de la versión, nuevas integraciones, cambios de posicionamiento, actualizaciones importantes de documentación, asociaciones públicas, anuncios ejecutivos y patrones importantes de contratación. La lista exacta debe coincidir con las decisiones que su equipo toma realmente.
Un resumen útil separa las señales de las preguntas. "La página de precios cambió" es una señal. "¿El nuevo plan hace al competidor más atractivo para equipos pequeños?" es una pregunta analítica. El agente debe recopilar la primera y razonar sobre la segunda solo después de tener evidencia.
Ilustración conceptual generada por IA de un resumen de monitoreo; no es una captura de pantalla de un producto real.
Para una primera ejecución semanal, escriba una oración que defina el éxito. Por ejemplo: "Para el lunes por la mañana, produzca un resumen vinculado a fuentes de cambios materiales de los últimos siete días para cinco competidores nombrados, sin afirmaciones no respaldadas". Esa oración se convierte en una prueba de aceptación práctica más adelante.
Paso 2: Construya un registro de fuentes en lugar de depender de búsquedas abiertas
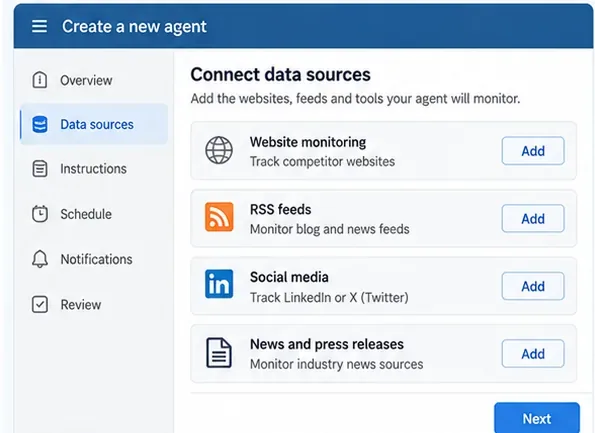
La búsqueda web es útil para el descubrimiento, pero un sistema de monitoreo no debe depender únicamente de las clasificaciones de búsqueda. Construya un pequeño registro de fuentes con campos como competidor, tipo de fuente, URL, prioridad, frecuencia de actualización esperada y qué pregunta puede responder la fuente.
Señal
Fuente preferida
Por qué es útil
Precios
Páginas oficiales de precios y planes
La fuente más cercana a la oferta comercial actual
Cambios de producto
Notas de la versión, registro de cambios, blog de producto
Generalmente proporciona fechas y contexto de funciones
Posicionamiento
Página de inicio, páginas de producto, páginas de campañas
Muestra cómo la empresa presenta el producto
Noticias corporativas
Sala de prensa y blog de la empresa
Útil para asociaciones, financiación, liderazgo y lanzamientos
Contexto de mercado
Fuentes de noticias públicas reputables
Añade contexto independiente a las afirmaciones de primera mano
Prefiera páginas públicas, feeds oficiales, APIs documentadas y fuentes a las que esté autorizado a acceder. No diseñe el agente para eludir inicios de sesión, muros de pago, restricciones de robots o controles de acceso. Para plataformas sociales, prefiera APIs oficiales o feeds públicos donde estén disponibles en lugar de scraping frágil.
Ilustración conceptual generada por IA de un registro de fuentes; utilice solo fuentes a las que tenga permiso para acceder.
El SDK actual de Agentes de OpenAI incluye una WebSearchTool alojada para agentes que utilizan modelos de respuestas de OpenAI. La documentación oficial de la herramienta también distingue entre la búsqueda web alojada y las herramientas de función locales, lo cual es útil si desea que el agente llame a su propio recuperador de URL, base de datos, lector RSS o servicio de detección de cambios. Consulte la guía oficial de herramientas del SDK de Agentes.
Paso 3: Defina el esquema de evidencia antes de pedir al modelo que resuma
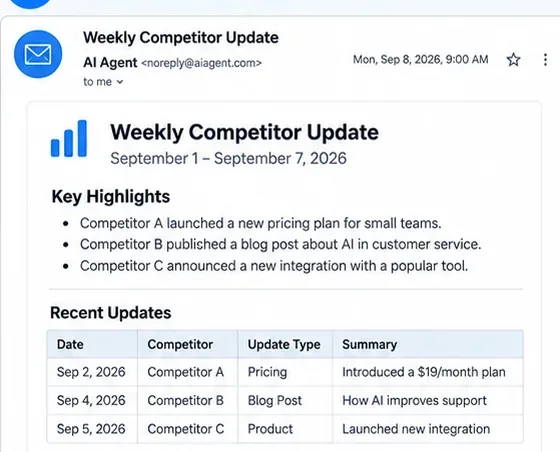
La forma más fácil de obtener informes semanales inconsistentes es pedir "un resumen de las noticias de la competencia". En su lugar, defina un hallazgo estructurado. Como mínimo, cada hallazgo debe contener el competidor, la categoría, la fecha observada, un resumen breve, la URL de la fuente, un extracto de evidencia o nota de la fuente, y una marca de confianza o revisión.
Agregue campos para previous_state y current_state cuando la señal se pueda comparar directamente, como el precio de un plan, la disponibilidad de una función, un titular o una integración documentada. Esto hace que el informe trate sobre el cambio en lugar de sobre lo que el modelo encontró por casualidad esa semana.
La salida estructurada también facilita la prueba del flujo de trabajo. El SDK de Agentes actualmente admite un output_type en un agente, y la documentación oficial recomienda tipos de Python normales como modelos Pydantic o dataclasses para resultados estructurados. Consulte la guía oficial de configuración de agentes.
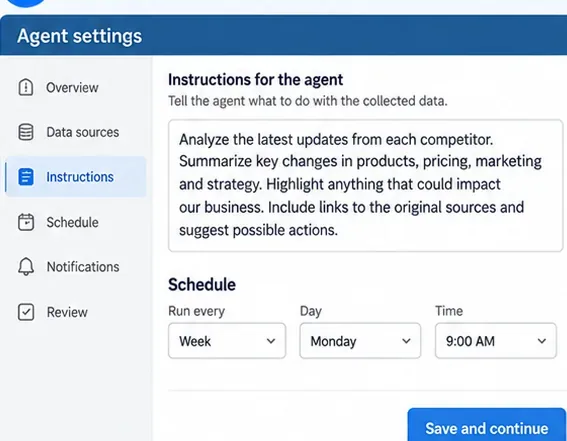
Ilustración conceptual generada por IA de instrucciones de agente y programación; no es una interfaz de producto real.
El último campo es importante. Un buen sistema de monitoreo debe poder decir "no se encontró ningún cambio material" en lugar de fabricar una actualización para llenar espacio.
Paso 4: Ejecute una prueba piloto manual antes de automatizar nada
Ejecute el flujo de trabajo manualmente durante un período de informes y compare el resultado con su propia revisión de las mismas fuentes. Esta prueba piloto revela problemas que son más difíciles de notar después de programar: resultados de búsqueda obsoletos, historias duplicadas, una taxonomía de categorías poco clara, inferencias no respaldadas, URLs de fuentes faltantes y hallazgos que son técnicamente nuevos pero estratégicamente irrelevantes.
Para cada hallazgo propuesto, pregúntese: ¿es la fuente de primera mano o independientemente reputable, está el cambio dentro de la ventana de fechas prevista, puedo señalar la evidencia exacta y se informaría del mismo elemento de nuevo la próxima semana si nada cambia? Si la respuesta a la última pregunta es sí, aún necesita una línea base o una regla de deduplicación.
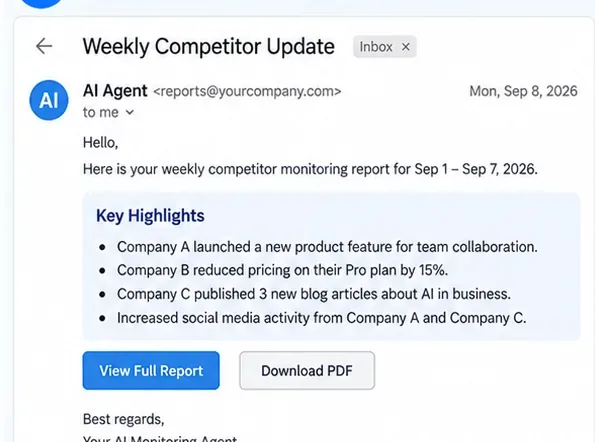
Ilustración conceptual generada por IA de un informe de prueba piloto manual con enlaces de evidencia.
No trate los fragmentos de búsqueda como el registro de evidencia. Almacene la URL de la fuente y, donde sus términos y derechos de acceso lo permitan, una instantánea normalizada o texto extraído utilizado para la comparación. La búsqueda debe ayudar a localizar la evidencia; no debe convertirse en un sustituto de la evidencia.
Paso 5: Implemente el agente con búsqueda web, salida estructurada y una línea base
Una vez que la prueba piloto manual produzca hallazgos útiles, integre el agente en el código. A partir de septiembre de 2026, el SDK de Agentes de Python de OpenAI puede combinar un Agent, una WebSearchTool alojada y un output_type estructurado. El siguiente ejemplo es intencionalmente pequeño: demuestra la capa de agente, no la capa de almacenamiento.
from pydantic import BaseModel
from agents import Agent, Runner, WebSearchTool

class Finding(BaseModel):
    competitor: str
    category: str
    summary: str
    source_url: str
    evidence: str
    observed_at: str
    needs_human_review: bool

class WeeklyReport(BaseModel):
    findings: list[Finding]
    executive_summary: str

agent = Agent(
    name="Weekly competitor monitor",
    instructions=(
        "Monitor only the competitors and topics in the input. "
        "Use public web sources. Every finding must include a source URL "
        "and evidence. Prefer first-party sources for product and pricing claims. "
        "Do not invent a change when no material change is supported."
    ),
    tools=[WebSearchTool()],
    output_type=WeeklyReport,
)

result = Runner.run_sync(
    agent,
    "Review the configured competitors for the reporting window and return the report."
)

report = result.final_output
La instalación del paquete y el patrón de ejecución están documentados en la guía de inicio rápido oficial del SDK de Agentes. El SDK también documenta Runner.run_sync() como el envoltorio síncrono alrededor de la ejecución normal del agente.
Ilustración conceptual generada por IA de un flujo de trabajo de agente; los detalles de implementación dependen de su pila tecnológica.
Agregue detección determinista de cambios donde pueda
No pida al modelo que redescubra cada estado antiguo desde la memoria. Persista una línea base. Para cada fuente, almacene la última observación exitosa: texto normalizado, un hash de contenido, campos seleccionados como precio o nombre del plan, la marca de tiempo de la observación y la URL de la fuente. En la siguiente ejecución, compare la nueva observación con la línea base primero. Luego dé al agente la diferencia para interpretar.
Este diseño híbrido es más fiable que "IA compara dos sitios web completos" porque el código determinista maneja la comparación exacta mientras que el modelo maneja la clasificación, la relevancia y la explicación. Si una página cambia solo su pie de página o parámetros de seguimiento, su normalizador puede eliminar ese ruido antes de que el agente lo vea.
Paso 6: Programe el flujo de trabajo semanalmente y mantenga las credenciales fuera del código
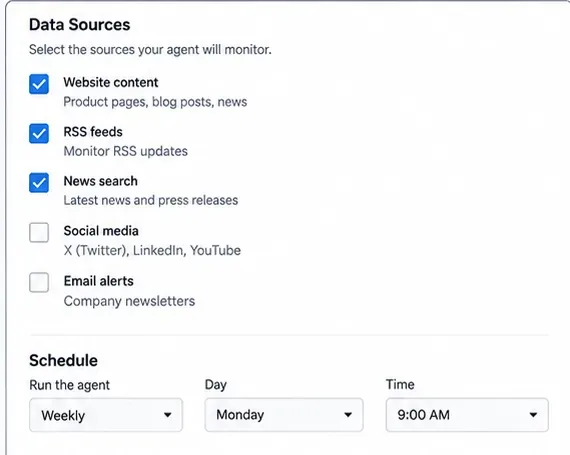
Puede ejecutar el monitor desde cualquier programador que se ajuste a su entorno. GitHub Actions es una opción práctica para un flujo de trabajo basado en repositorios. La documentación actual de GitHub indica que los flujos de trabajo programados utilizan la sintaxis cron POSIX, se ejecutan en la rama predeterminada, usan UTC por defecto y pueden especificar opcionalmente una zona horaria IANA. GitHub también advierte que las ejecuciones pueden retrasarse durante períodos de alta carga, especialmente alrededor del inicio de la hora, por lo que un minuto como 17 es preferible a 00 cuando la ejecución exacta al inicio de la hora no es necesaria. Consulte la documentación oficial de programación de GitHub Actions.
Almacene las claves API como secretos cifrados en lugar de confirmarlas en el repositorio. La guía oficial de secretos de GitHub explica los secretos de repositorio, entorno y organización y recomienda evitar la divulgación accidental en los registros de flujos de trabajo.
Ilustración conceptual generada por IA de una capa de programación; el artículo utiliza GitHub Actions como ejemplo concreto.
Un detalle operativo es fácil de pasar por alto: GitHub dice que los flujos de trabajo programados en repositorios públicos se desactivan automáticamente después de 60 días sin actividad en el repositorio. Si este flujo de trabajo es crítico para la misión, monitoree el monitor: registre la hora de la última ejecución exitosa y alerte cuando el trabajo semanal esperado no se complete.
Paso 7: Coloque una puerta de revisión humana entre "hallazgo" y "decisión"
El monitoreo semanal de la competencia es un flujo de trabajo de lectura y resumen, por lo que no debe cambiar automáticamente los precios, publicar contenido ni alterar una hoja de ruta de producto. Una persona debe revisar las afirmaciones materiales antes de que influyan en una decisión. La revisión puede ser ligera: aprobar, rechazar, fusionar con otro hallazgo o marcar como "vigilar la próxima semana".
Requiere una revisión más estricta para categorías de alto impacto como precios, afirmaciones legales, incidentes de seguridad, despidos, adquisiciones o declaraciones que dependen de informes de terceros. Para cambios de producto y precios, prefiera la propia página del competidor como evidencia principal incluso si una noticia le ayudó a descubrirlo.
Ilustración conceptual generada por IA de la etapa de revisión humana antes de que los hallazgos se compartan o se actúe sobre ellos.
Si su implementación agrega más tarde herramientas que pueden tomar acciones, el SDK de Agentes incluye barreras de seguridad y mecanismos de aprobación con intervención humana. La documentación oficial de barreras de seguridad describe las barreras de entrada, salida y herramienta, mientras que la guía de intervención humana explica cómo pausar llamadas de herramientas sensibles para su aprobación.
Paso 8: Rastree tendencias, trace fallos y autoverifique el sistema
Un informe semanal útil se vuelve más valioso después de varias ejecuciones porque puede distinguir eventos aislados de patrones. Almacene cada hallazgo aprobado en una tabla simple o base de datos con competidor, categoría, fecha, fuente y estado de revisión. Luego puede responder preguntas como qué competidor cambió los precios con más frecuencia, qué temas se repiten en las notas de la versión o qué fuentes monitoreadas ya no producen señales útiles.
Ilustración conceptual generada por IA del seguimiento de tendencias y la autoverificación a lo largo de múltiples ejecuciones semanales.
Para el agente en sí, mantenga la observabilidad. El SDK de Agentes de OpenAI incluye trazabilidad integrada que registra generaciones de modelos, llamadas a herramientas, traspasos, barreras de seguridad y eventos personalizados. La guía oficial de trazabilidad describe cómo se pueden usar las trazas y los segmentos para depurar y monitorear flujos de trabajo. Sea deliberado con los datos sensibles porque las cargas útiles de trazas pueden incluir entradas/salidas de modelos y herramientas según la configuración.
Autoverificación antes de confiar en el informe semanal
Cada hallazgo material tiene una URL de fuente funcional y una fecha dentro de la ventana de informes.
Las afirmaciones de producto y precios de primera mano están respaldadas por evidencia de primera mano siempre que sea posible.
El sistema compara contra el último estado conocido en lugar de simplemente repetir noticias antiguas.
"Sin cambio material" es un resultado aceptable para cualquier competidor.
Las historias duplicadas de múltiples medios se fusionan en lugar de contarse como cambios separados.
El trabajo programado tiene una marca de tiempo de éxito registrada, y las ejecuciones perdidas son detectables.
Las claves API y otras credenciales se almacenan como secretos y no aparecen en registros o informes.
Un humano revisa los hallazgos de alto impacto antes de que el equipo actúe sobre ellos.
Errores comunes que hacen que el monitoreo de la competencia con IA no sea fiable
Monitorear solo a través de consultas de búsqueda
La búsqueda es excelente para el descubrimiento pero inestable como línea base histórica. Mantenga URLs de fuentes explícitas y persista las observaciones anteriores.
Pedir al modelo "noticias importantes" sin un esquema
La importancia es subjetiva. Defina categorías, requisitos de evidencia y una marca de revisión para que la salida pueda ser auditada.
Dejar que el agente resuma sin fechas
Un resultado puede ser relevante pero antiguo. Incluya siempre la ventana de informes y requiera una fecha observada o publicada cuando la fuente la proporcione.
Enviar cada elemento descubierto a las partes interesadas
Separe la recopilación del informe. La capa de recopilación puede encontrar muchos elementos candidatos; el informe final debe contener solo cambios respaldados por evidencia, deduplicados que cumplan con sus reglas de relevancia.
Automatizar acciones demasiado pronto
La primera versión más segura es de solo lectura: recopilar, comparar, resumir y solicitar revisión. Agregue acciones de escritura solo después de poder medir los falsos positivos y entender los modos de fallo.
Una arquitectura simple que puede reutilizar
El patrón duradero es: registro de fuentes → recopilación → normalización → comparación de línea base → análisis de agente → hallazgos estructurados → revisión humana → informe semanal → almacén de tendencias. El agente de IA es más fuerte en las etapas de interpretación, mientras que el código ordinario suele ser mejor para la programación exacta, el almacenamiento de estado, el hashing, los reintentos y las comparaciones deterministas.
Si el flujo de trabajo pasa la autoverificación durante varias ejecuciones consecutivas, puede expandirse con cuidado: agregar más competidores, agregar agentes especializados para cambios de precios o productos, agregar una base de datos, o enrutar informes aprobados a correo electrónico, Slack o su base de conocimiento interna. El objetivo no es crear el agente más autónomo. Es crear el sistema repetible más pequeño que dé a su equipo cambios de la competencia oportunos y respaldados por fuentes cada semana.