Strona główna
» Domeny
»
Jak mierzyć jakość odpowiedzi LLM za pomocą frameworków Evals
Jak mierzyć jakość odpowiedzi LLM za pomocą frameworków Evals
Najbardziej wiarygodnym sposobem pomiaru jakości odpowiedzi LLM jest traktowanie oceny jako powtarzalnego systemu testowego, a nie pojedynczego wyniku. Zdefiniuj, co „dobry” oznacza dla Twojej aplikacji, zbuduj reprezentatywny zbiór danych ewaluacyjnych, połącz deterministyczne kontrole z oceną opartą na modelach i ludzkim osądem, porównaj każdą zmianę kandydata z linią bazową i sprawdź błędy według kategorii przed wysłaniem aplikacji.
Ma to znaczenie, ponieważ LLM może dać odpowiedź, która brzmi schludnie, a jednocześnie jest błędna, nieuzasadniona, niekompletna, niepewna lub niezgodna z instrukcjami. Przydatne ramy ewaluacyjne przekształcają te niejasne wątpliwości w jednoznaczne kryteria, które można ponownie zastosować po szybkiej zmianie, aktualizacji modelu, zmianie pobierania, aktualizacji narzędzia lub rewizji polityki bezpieczeństwa.
Uwaga dotycząca dokumentacji: możliwości frameworka opisane poniżej zostały sprawdzone pod kątem zgodności z oficjalną dokumentacją dostępną 13 września 2026 r. Narzędzia te szybko się rozwijają, dlatego przed skopiowaniem kodu specyficznego dla frameworka do środowiska produkcyjnego należy zweryfikować aktualne interfejsy API.
Co należy zmierzyć w pierwszej kolejności?
Zacznij od awarii, która ma największe znaczenie dla użytkowników. W przypadku bota wsparcia opartego na faktach, poprawność i zgodność z polityką mogą dominować. W przypadku generowania wspomaganego wyszukiwaniem (RAG) istotne są ugruntowanie i jakość wyszukiwania, ponieważ płynna odpowiedź może nadal zawierać fakty, które nie są poparte pobranym kontekstem. W przypadku agenta jakość ostatecznej odpowiedzi nie wystarczy; konieczne może być również ocenianie wyboru narzędzia, argumentów narzędzia, wykonania zadania i zbędnych kroków.
Wymiar jakości
O co prosi
Dobry typ oceniającego
Poprawność
Czy odpowiedź jest prawidłowa pod względem faktycznym i logicznym?
Porównanie odniesień, sprawdzenie kodu, ocena LLM lub recenzja człowieka
Instrukcja poniżej
Czy model spełniał wymagane ograniczenia?
Zasady kodowania i sędzia oparty na rubryce
Ugruntowanie
Czy twierdzenia są poparte podanym kontekstem?
Kontrole sędziowskie lub kontrole na poziomie roszczeń dla konkretnego RAG
Znaczenie
Czy odpowiedź odpowiada na pytanie i nie odbiega od tematu?
Sędzia LLM lub przegląd ludzki
Zgodność z formatem
Czy dane wyjściowe są zgodne ze schematem JSON, czy nadają się do użytku na maszynie?
Kod deterministyczny
Bezpieczeństwo i polityka
Czy odpowiedź narusza zasady aplikacji?
Sprawdzanie zasad, sędzia LLM i ukierunkowana kontrola przez człowieka
Efektywność
Jakie opóźnienie, użycie tokena i koszt były wymagane przy udzielaniu odpowiedzi?
Telemetria i śledzenie
Nie uśredniaj ich do jednej liczby zbyt wcześnie. Model kandydata, który zyskuje dwa punkty w stylu, ale wprowadza nawet niewielką liczbę poważnych błędów w polityce, może być gorszym wydaniem. Utrzymuj krytyczne wymiary widoczne jako oddzielne bramki.
Czteroetapowy proces oceny, który działa w różnych ramach
1. Zbuduj reprezentatywny zbiór danych ewaluacyjnych
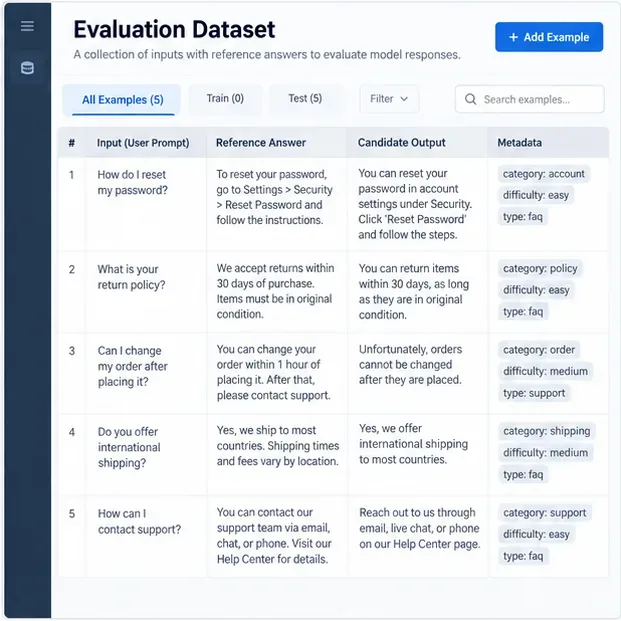
Twój zbiór danych powinien zawierać realistyczne dane wejściowe i, w miarę możliwości, oczekiwane zachowanie. Niektóre wiersze mogą zawierać dokładne odpowiedzi referencyjne; inne mogą wymagać rubryki zamiast jednego „złotego” zdania. Dodaj metadane, takie jak typ zadania, segment klientów, język, poziom trudności, warunek pobierania lub kategoria bezpieczeństwa, aby później móc podzielić wyniki.
Wyobraźmy sobie na przykład asystenta obsługi klienta. Przydatny zestaw ewaluacyjny nie zawierałby wyłącznie prostych pytań z FAQ. Powinien on również obejmować niejednoznaczne prośby, wyjątki od zasad, przypadki braku kontekstu, monity o charakterze antagonistycznym, wieloetapowe działania następcze oraz przykłady, w których prawidłowym zachowaniem jest stwierdzenie, że odpowiedzi nie można ustalić.
Aktualne wytyczne LangSmith dotyczące ewaluacji zalecają rozpoczęcie od ręcznie opracowanych przykładów, które pokazują, jak wygląda prawidłowe zachowanie, a następnie rozszerzenie zbioru danych o ślady historyczne i błędy wykryte w środowisku produkcyjnym. System ewaluacji obsługuje zbiory danych z danymi wejściowymi, opcjonalnymi danymi wyjściowymi i metadanymi. Zobacz dokumentację koncepcji ewaluacji LangSmith .
Zbiór danych ewaluacyjnych powinien łączyć realistyczne podpowiedzi z odniesieniami lub oczekiwanym zachowaniem i zachowywać metadane na potrzeby późniejszej analizy błędów.
Kiedy to podejście się sprawdza: prawie zawsze. Nawet jeśli korzystasz z oceny w czasie rzeczywistym, nadal potrzebujesz stabilnego zestawu offline do testów regresyjnych. Jeśli nie masz odpowiedzi referencyjnych dla zadań otwartych, zamiast tego przechowuj rubrykę, wymagane fakty, zabronione zachowania lub preferencje dotyczące par.
2. Dopasuj każdy wymiar jakości do właściwego ewaluatora
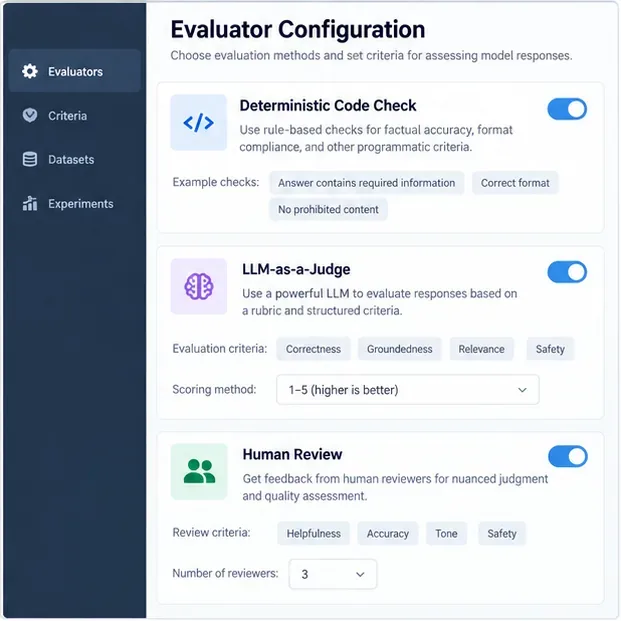
Najmocniejsze zestawy oceniające łączą różne typy oceniających, ponieważ nie ma jednego oceniającego, który byłby idealny dla każdego pytania.
Sprawdzanie deterministyczne sprawdza się najlepiej, gdy wymagania są jednoznaczne: poprawny kod JSON, dokładne etykiety, wymagane klucze, tolerancja liczbowa, reguły wyrażeń regularnych lub gdy wywołanie narzędzia użyło zatwierdzonych argumentów.
Metryki oparte na odniesieniach mogą okazać się pomocne, gdy istnieje znana odpowiedź, ale samo podobieństwo ciągów znaków jest często zbyt kruche, aby można było na jego podstawie tworzyć poprawne parafrazy, i zbyt wyrozumiałe dla semantycznie niepoprawnych tekstów o podobnym słownictwie.
LLM-as-a-judge jest przydatny w przypadku kryteriów takich jak kompletność, trafność, ton, wierność lub czy odpowiedź otwarta spełnia kryteria.
Ocena parami jest przydatna, gdy łatwiej jest zadecydować, czy lepszy jest kandydat A czy baza B, niż przypisać miarodajny wynik bezwzględny.
Ocena dokonywana przez człowieka pozostaje ważna w przypadku kalibracji automatycznych programów oceniających, rozwiązywania subiektywnych lub ryzykownych przypadków oraz sprawdzania, czy same wskaźniki odzwierciedlają wartość dla użytkownika.
Obecne API Evals firmy OpenAI definiuje ocenę jako kryteria testowe wraz ze schematem źródła danych i obsługuje wielokrotnego użytku moduły oceniające. API obejmuje deterministyczne sprawdzanie ciągów znaków, moduły oceniające pod względem podobieństwa tekstu oraz moduły oceniające oparte na modelu; patrz dokumentacja API Evals firmy OpenAI i dokumentacja modułów oceniających OpenAI . Usługa ewaluacji Vertex AI Gen AI firmy Google Cloud obsługuje metryki oparte na modelach punktowo i parami, a także metryki oparte na obliczeniach; jej wyniki mogą obejmować oceny dla poszczególnych instancji, wyjaśnienia, średnie zbiorcze, odchylenia standardowe i wskaźniki wygranych dla par. Zobacz dokumentację wyników ewaluacji Vertex AI .
W miarę możliwości stosuj deterministyczne reguły, dodawaj sędziów LLM korzystających z rubryk oceniania w celu zapewnienia jakości semantycznej i zapewnij dostępność recenzji ludzkiej w celu kalibracji i niuansów w przypadkach.
Gdy to podejście się sprawdza: stosuj deterministyczne kontrole wymagań weryfikowalnych przez maszyny, sędziów LLM w odniesieniu do cech semantycznych oraz ludzi, gdy rozbieżność ma istotne konsekwencje biznesowe lub związane z bezpieczeństwem. W przypadku systemu RAG, Ragas udostępnia metryki takie jak precyzja kontekstu, przywołanie kontekstu, trafność odpowiedzi i wierność, a także metryki użycia agenta/narzędzia, w tym dokładność wywołania narzędzia i cel agenta. Zapoznaj się z dokumentacją metryk Ragas . DeepEval oferuje również metryki specyficzne dla zadań i niestandardowe oceny sędziów LLM, w tym punktację w stylu G-Eval; zapoznaj się z dokumentacją metryk DeepEval .
3. Uruchom ten sam zestaw danych w odniesieniu do danych bazowych i kandydatów
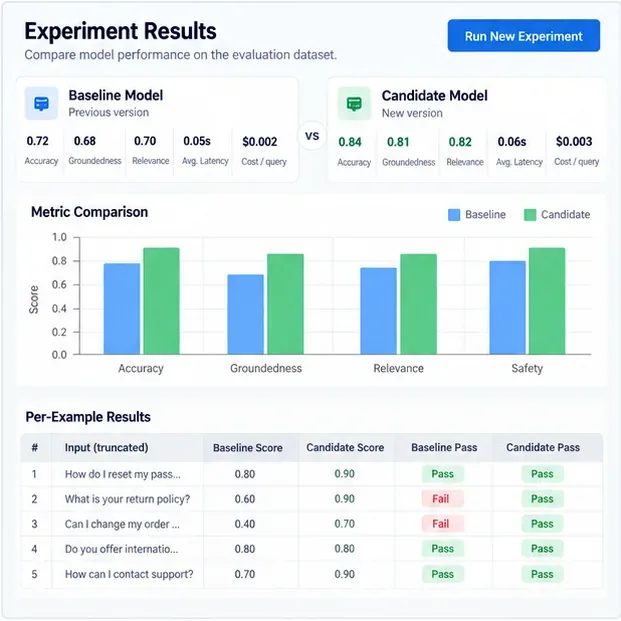
Wyniki bezwzględne są przydatne, ale decyzje o wydaniu są zazwyczaj bardziej jednoznaczne, gdy nowa konfiguracja jest testowana z wersją, której już ufasz. Zadbaj o to, aby zbiór danych, definicje ewaluatorów, parametry modelu i ustawienia próbkowania były jak najbardziej stabilne. Następnie porównaj te same przykłady obok siebie.
Śledź co najmniej trzy poziomy wyników:
Wyniki według przykładów: Które konkretne wskazówki uległy poprawie lub pogorszeniu?
Wyniki dla poszczególnych wycinków: Czy wydajność zmieniła się w przypadku pytań dotyczących długiego kontekstu, określonego języka, trudnych przypadków, kategorii produktów lub antagonistycznych danych wejściowych?
Wyniki zbiorcze: Co się stało ze wskaźnikiem zdawalności, średnim wynikiem, opóźnieniem, wykorzystaniem tokenów, kosztem i liczbą poważnych niepowodzeń?
W przypadku systemów niedeterministycznych należy powtarzać ważne testy wystarczająco często, aby zrozumieć zmienność, zamiast zakładać, że jedno ukończenie reprezentuje model. Jeśli decyzja o wydaniu jest istotna, należy przeprowadzić porównania parami tych samych przykładów i zgłosić niepewność, zamiast polegać jedynie na niewielkiej zmianie średniej.
LangSmith obsługuje eksperymenty offline w celu porównywania wersji i ewaluatorów parowych, natomiast obecny stos ewaluacyjny GenAI MLflow obsługuje zestawy danych ewaluacyjnych, wbudowane i niestandardowe scoringi, sędziów LLM, opinie użytkowników, śledzenie i monitorowanie produkcji. Zobacz LangSmith Evaluation oraz MLflow LLM and Agent Evaluation .
Porównaj kandydata z bieżącym punktem odniesienia na podstawie tych samych przykładów, a następnie sprawdź zarówno zbiorcze wskaźniki, jak i wyniki zaliczenia lub niezaliczenia dla każdego przykładu.
Kiedy to podejście się sprawdza: za każdym razem, gdy zmieniasz model, monit systemowy, potok pobierania, implementację narzędzia lub ustawienia dekodowania. Kandydat nie powinien zostać awansowany tylko dlatego, że jedna metryka zbiorcza wzrosła; powinna ona spełniać progi wydania w kluczowych wymiarach i unikać niedopuszczalnych regresji na poziomie wycinków.
4. Przeprowadź inspekcję błędów, skalibruj sędziego i przekształć regresje w nowe testy
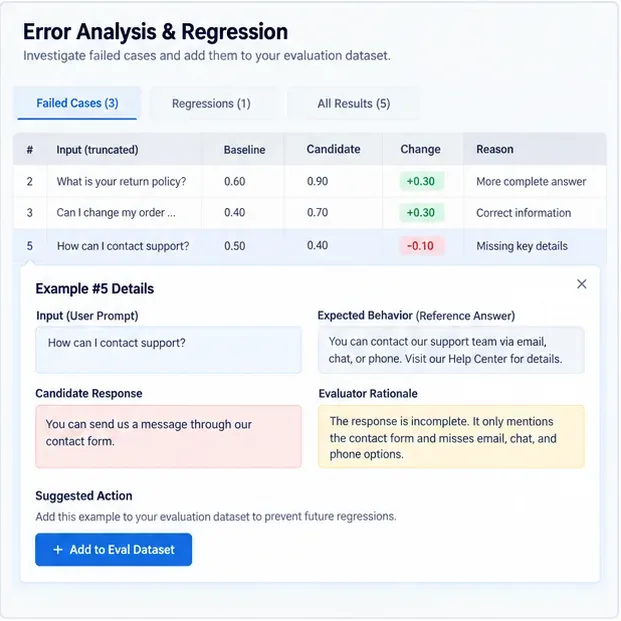
Przeprowadzenie ewaluacji jest wartościowe tylko wtedy, gdy zmienia Twoje następne działania. Posortuj błędy według wagi i przyczyny źródłowej. Niski wynik ugruntowania może wynikać ze słabego przywoływania informacji, podpowiedzi zachęcającej do zgadywania, zbyt niejasnej rubryki oceny lub nieprawidłowej odpowiedzi referencyjnej. Przeczytaj podstawowe przykłady przed zmianą modelu.
Następnie przenieś ważne awarie do stałych przypadków regresji. To tworzy koło zamachowe: produkcja ujawnia awarię, człowiek ją potwierdza, przypadek jest dodawany do zestawu danych offline, poprawka jest testowana w całym pakiecie, a przyszłe wersje są blokowane przed ponownym pojawieniem się tego samego problemu.
Sędziowie LLM również potrzebują oceny. Dokumentacja Google wyraźnie opisuje porównywanie wyników metryk opartych na modelach z ocenami ludzkimi w celu oceny, czy sędzia jest wystarczająco dobry w danym przypadku użycia. Podobnie, w ramach metody GDPval firmy OpenAI, jako główny standard wykorzystuje się ocenianie par ekspertów, a automatyczne ocenianie opisuje się jako przybliżenie, a nie zamiennik oceny eksperckiej. Zobacz wskazówki Vertex AI dotyczące oceny modelu sędziego oraz metodologię GDPval firmy OpenAI .
Przeanalizuj rzeczywiste nieudane przykłady, potwierdź, że osoba oceniająca dokonuje prawidłowej oceny i dodaj ważne regresje do stałego zestawu testowego.
Kiedy to podejście się sprawdza: zawsze w przypadku błędów o dużym znaczeniu i gdy sędzia LLM wpływa na decyzję o wydaniu. Jeśli recenzenci wielokrotnie nie zgadzają się z sędzią, należy poprawić kryteria, podać jaśniejsze odniesienia, zmienić model oceny lub ponownie przekazać kryterium do oceny ludzkiej.
Jak wiarygodny jest LLM jako sędzia?
Sędziowie LLM są kompetentni, ponieważ potrafią oceniać otwarte wyniki w skali, której nie jest w stanie dorównać ocena wyłącznie przez ludzi. Oryginalne badanie G-Eval wykazało znacznie lepszą korelację z oceną ludzką niż tradycyjne automatyczne metryki w badanym środowisku podsumowania. Jednak w tym samym artykule ostrzegano, że ewaluatorzy LLM mogą faworyzować teksty generowane przez LLM. Zobacz oryginalny artykuł G-Eval .
Odrębne badania dotyczące MT-Bench i Chatbot Arena wykazały, że doświadczeni sędziowie LLM potrafią dobrze wpisywać się w ludzkie preferencje, jednocześnie dokumentując swoje stanowisko, wylewność, samodoskonalenie i uprzedzenia związane z rozumowaniem. Zobacz oryginalne badanie dotyczące LLM-as-a-judge .
Praktyczny wniosek nie brzmi: „nigdy nie korzystaj z sędziów LLM”. Chodzi o to, by ich skalibrować. Zbuduj próbę oznaczoną przez ludzi, zmierz zgodność, zbadaj kategorie niezgodności, losuj lub zamień kolejność odpowiedzi w testach parami, gdy efekty pozycji są prawdopodobne, i unikaj sytuacji, w której ta sama niejasna podpowiedź sędziego w milczeniu decyduje o każdej decyzji o zwolnieniu.
Którą strukturę ewaluacyjną powinieneś wybrać?
Struktura
Najlepiej pasuje
Wyraźna siła
Oceny i testy OpenAI
Zespoły korzystające już z interfejsów API OpenAI i chcące przeprowadzić testy natywne dla interfejsu API
Wielokrotnego użytku definicje ewaluacji z deterministycznymi i opartymi na modelach oceniaczami
Silne porównanie eksperymentów i pętla sprzężenia zwrotnego produkcji
Ragas
Przepływy RAG i ocena wykorzystania agentów/narzędzi
Celowe wyszukiwanie, wierność, trafność i metryki narzędzi
Głęboka ocena
Zespoły skupione na Pythonie, które chcą przeprowadzać oceny w stylu testów i dostosowywać sędziów LLM
Szeroki katalog metryk, ocena komponentów/kompleksowa i metryki trajektorii agentów
Ocena MLflow GenAI
Zespoły, które już korzystają z MLflow lub chcą powiązać ewaluacje ze śledzeniem i zarządzaniem cyklem życia
Zestawy danych, narzędzia do oceniania, opinie użytkowników, śledzenie eksperymentów i monitorowanie produkcji
Ocena Vertex AI Gen AI
Wdrożenia Google Cloud
Przepływy pracy ewaluacji punktowej, parowej, opartej na modelach i obliczeniowej
Wybór frameworka ma mniejsze znaczenie niż projekt ewaluacji. Możesz zbudować słaby pakiet ewaluacyjny na zaawansowanej platformie lub silny, korzystając z kilku skryptów. Wybierz narzędzie, które zapewni powtarzalność testów, ich wersjonowanie, łatwość inspekcji i uruchamiania przed każdą istotną zmianą.
Praktyczna karta wyników wydania
Dla asystenta produkcji, użyteczną decyzję o wydaniu można wyrazić jako zestaw bramek zamiast jednego wyniku łączonego. Na przykład, wymagaj zerowej liczby krytycznych usterek bezpieczeństwa w wybranym zestawie bezpieczeństwa, braku statystycznie istotnej regresji w poprawności zadań, minimalnego wskaźnika zdawalności pytań RAG, prawidłowego, ustrukturyzowanego wyniku dla każdego przypadku schematu oraz opóźnienia lub kosztów w ramach budżetu operacyjnego. Dokładne progi muszą wynikać z tolerancji ryzyka i wymagań użytkownika; nie ma uniwersalnego procentu, który czyni LLM „wystarczająco dobrym”.
Zachowaj również surowe przykłady, na których opiera się wynik. Jeśli wersja zmieni się z 0,84 na 0,86, nadal musisz wiedzieć, które dwa przypadki uległy zmianie i czy te zmiany mają znaczenie. W praktyce zespoły uczą się więcej z niewielkiej liczby jasno sklasyfikowanych błędów niż z imponującej średniej na pulpicie nawigacyjnym, której nie da się prześledzić.
Typowe błędy w ocenie
Testowanie tylko prawidłowych ścieżek: dodawanie niejednoznaczności, przypadków skrajnych, prób natychmiastowego wstrzyknięcia, brakującego kontekstu i znanych historycznych błędów.
Stosowanie dokładnego dopasowania w przypadku odpowiedzi otwartych: dokładne dopasowanie należy stosować tylko w przypadku wyników, w których dokładność jest rzeczywiście wymagana.
Zaufanie do sędziego LLM bez żadnych kryteriów: porównaj to z ludzkimi etykietami i omówi różnice zdań.
Optymalizacja średniej przy jednoczesnym ukrywaniu poważnych błędów: zachowanie bezpieczeństwa, polityki i innych krytycznych wymiarów jako wyraźnych bram.
Zmiana zestawu danych podczas porównywania modeli: zamroź zestaw porównawczy lub zmień jego wersję, aby wyniki pozostały możliwe do zinterpretowania.
Ignorowanie dryfu produkcyjnego: oceny offline chronią wydania; oceny online i przykładowe recenzje ludzkie ujawniają nowe zachowania użytkowników i nowe tryby awarii.
Podsumowanie
Pomiar jakości odpowiedzi LLM to dziedzina inżynierska, a nie testowanie atmosfery. Zacznij od reprezentatywnego zbioru danych, zdefiniuj wymiary jakości specyficzne dla danego zadania, wybierz deterministyczne testy wszędzie tam, gdzie możliwe jest obliczenie wymagania, korzystaj z sędziów LLM tam, gdzie konieczna jest ocena semantyczna, kalibruj tych sędziów z udziałem ludzi i porównuj zmiany kandydatów ze stabilną linią bazową. Następnie przekształć każdą istotną awarię w rzeczywisty test regresji.
Jeśli zastosujesz się do tej zasady, struktura oceny stanie się czymś więcej niż tylko panelem raportów: stanie się systemem kontroli jakości, który poinformuje Cię, czy monit, model, zmiana pobierania lub aktualizacja agenta faktycznie przyczyniła się do ulepszenia produktu.