Strona główna
» Domeny
»
Jak naprawić błąd „przekroczenia limitu czasu interfejsu API” podczas uruchamiania przepływów pracy z wieloma agentami
Jak naprawić błąd „przekroczenia limitu czasu interfejsu API” podczas uruchamiania przepływów pracy z wieloma agentami
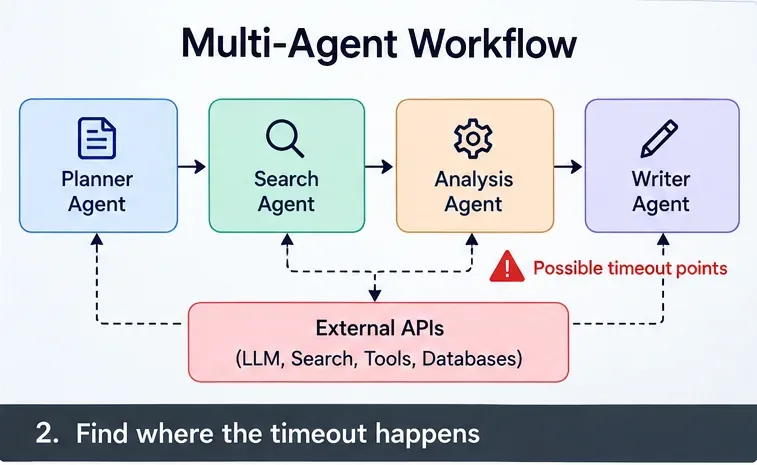
Błąd przekroczenia limitu czasu API w przepływie pracy z wieloma agentami rzadko można naprawić, zmieniając tylko jeden numer. Planista może wywołać trzech agentów, każdy agent może wywołać interfejs LLM, usługę wyszukiwania, bazę danych lub narzędzie API, a każda warstwa może mieć własny limit czasu, politykę ponawiania prób, pulę połączeń i limit współbieżności. Praktycznym rozwiązaniem jest zidentyfikowanie warstwy, która pierwsza przekroczy limit czasu, a następnie wybranie między dłuższym oczekiwaniem, mniejszą liczbą równoczesnych wywołań, inteligentniejszymi ponowieniami prób, krótszą ścieżką krytyczną lub asynchronicznym projektem zadań.
Kompromis ma znaczenie: podniesienie limitu czasu jest proste, ale utrzymuje zasoby dłużej; agresywne ponowne próby mogą zwielokrotnić obciążenie i koszty; obniżenie współbieżności poprawia stabilność, ale zmniejsza przepustowość szczytową; agenci równoległi redukują opóźnienia zegara tylko wtedy, gdy usługi podrzędne mogą obsłużyć rozproszenie. Nie ma jednego najlepszego ustawienia dla każdego systemu wieloagentowego.
Który limit czasu faktycznie wykorzystujesz?
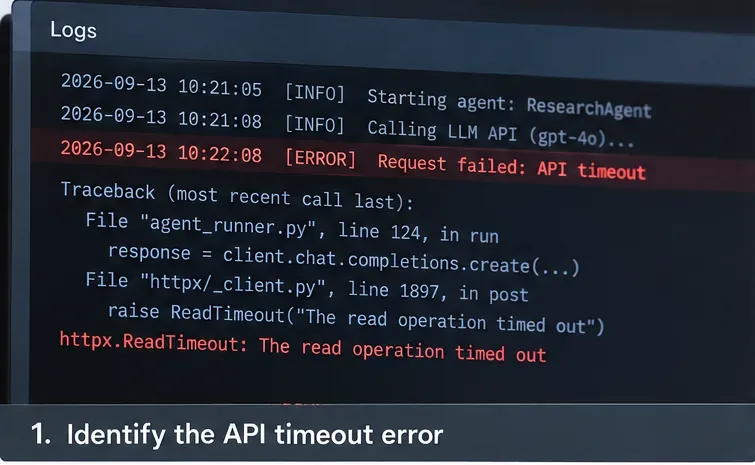
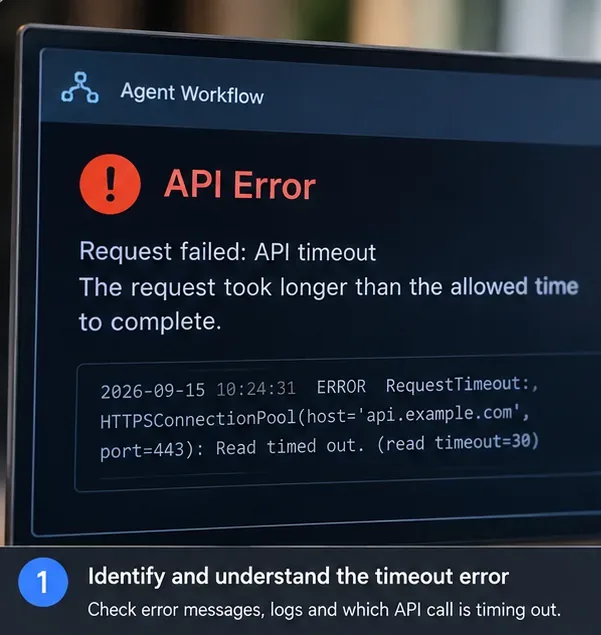
Zacznij od sklasyfikowania awarii, zamiast traktować każde przekroczenie limitu czasu jako to samo zdarzenie. Klienci HTTP mogą przekroczyć limit czasu podczas łączenia się, odczytu, zapisu lub oczekiwania na połączenie z puli. Na przykład HTTPX dokumentuje cztery oddzielne typy przekroczenia limitu czasu: połączenia, odczytu, zapisu i puli. Domyślnie przekroczenie limitu czasu jest generowane po pięciu sekundach braku aktywności sieci, a niekoniecznie po pięciu sekundach całkowitego czasu trwania żądania. Zobacz oficjalną dokumentację dotyczącą przekroczenia limitu czasu HTTPX .
Jeśli korzystasz z pakietu OpenAI Python SDK, jego aktualny oficjalny plik README stanowi, że żądania domyślnie oczekują na 10-minutowy limit czasu klienta, a błędy przekroczenia limitu czasu są domyślnie ponawiane dwukrotnie. Pakiet SDK automatycznie ponawia również próby w przypadku błędów połączenia oraz odpowiedzi HTTP 408, 409, 429 i 5xx z krótkim, wykładniczym odczekaniem. Są to domyślne ustawienia pakietu SDK, a nie gwarancja, że każdy serwer proxy, moduł równoważenia obciążenia, brama lub koordynator oczekujący na żądanie będzie czekał 10 minut. Zobacz oficjalny plik README pakietu OpenAI Python SDK .
Krok 1: przechwyć dokładny wyjątek oraz agenta, punkt końcowy i warstwę transportową, które przekroczyły limit czasu, zamiast rejestrować tylko ogólny błąd przepływu pracy.
Jaką naprawę powinieneś wybrać?
Opcja
Najlepiej pasuje
Główna korzyść
Główny kompromis
Zwiększ limit czasu żądania
Zdrowe, ale uzasadnione, powolne wywołania modelu/narzędzia
Minimalna zmiana kodu i architektury
Pracownicy i połączenia pozostają zajęte dłużej; brama nadrzędna może nadal najpierw zakończyć żądanie
Automatyczna regeneracja po krótkotrwałych awariach
Może zwiększyć ruch, opóźnienia i koszty; niebezpieczne dla działań nieidempotentnych, chyba że zostanie starannie zaprojektowane
Niższa współbieżność agentów
429s, przekroczenia limitu czasu w puli, nasycenie downstream
Zmniejsza liczbę serii i konfliktów w kolejce
Niższa przepustowość szczytowa i czasami dłuższy czas ukończenia przepływu pracy
Paralelizuj niezależnych agentów
Sekwencyjne przepływy pracy z niezależnymi gałęziami
Skraca ścieżkę krytyczną
Zwiększa liczbę jednoczesnych żądań i może powodować naliczanie limitów szybkości lub połączenia
Przesyłaj częściowe dane wyjściowe
Interaktywny UX, w którym liczy się opóźnienie pierwszego bajtu
Użytkownicy widzą postęp szybciej
Nie rozwiązuje automatycznie problemu przekroczenia limitu czasu integracji lub przeciążenia usługi podrzędnej
Przenieś pracę do zadania/kolejki asynchronicznej
Przepływy pracy, które mogą trwać dziesiątki sekund lub minut
Oddziela czas życia żądania HTTP od czasu życia przepływu pracy
Wymaga stanu zadania, sondowania/webhooków, idempotencji, trwałości i monitorowania operacyjnego
Krok 1: Znajdź pierwszą warstwę, której termin upłynął
Rejestruj identyfikator korelacji dla całego przepływu pracy oraz identyfikator zakresu lub elementu podrzędnego dla każdego wywołania agenta i narzędzia. Rejestruj czas rozpoczęcia, czas zakończenia, punkt końcowy, numer próby, typ wyjątku, status odpowiedzi (jeśli dostępny) oraz informację, czy anulowanie nastąpiło od wywołującego, czy od usługi podrzędnej.
Ważne pytanie brzmi: „kto przestał czekać pierwszy?”. Jeśli wywołanie LLM kończy się po 42 sekundach, ale brama API poddaje się po 30 sekundach, wydłużenie limitu czasu klienta LLM z 60 do 120 sekund nic nie zmienia. Aktualna dokumentacja Amazon dla interfejsów API HTTP API Gateway podaje maksymalny limit czasu integracji wynoszący 30 sekund, co jest dobrym przykładem, dlaczego najkrótszy termin w łańcuchu często decyduje o wyniku. Zobacz limity API HTTP Amazon API Gateway .
Krok 2: zamapuj ścieżkę żądania i zaznacz każde miejsce, które może zakończyć lub opóźnić połączenie: koordynator, agent, brama, model API, wyszukiwanie API, baza danych i usługa narzędziowa.
Krok 2: Zmierz ścieżkę krytyczną, a nie tylko średnie opóźnienie
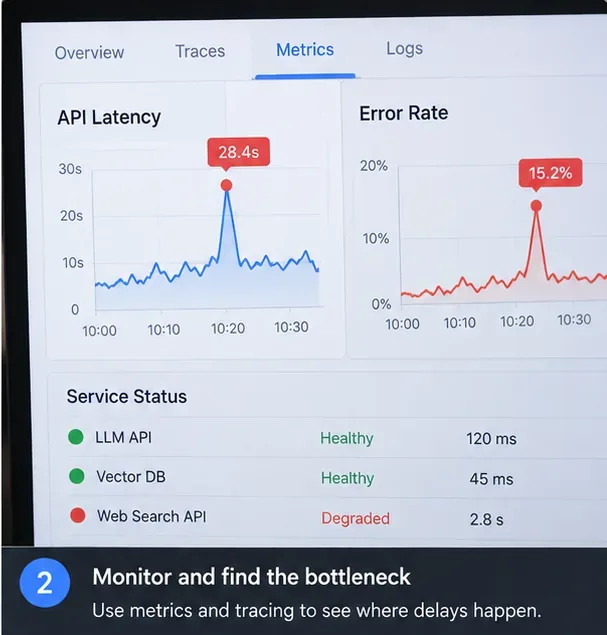
Średnie opóźnienie może wydawać się prawidłowe, podczas gdy niewielki ogon powolnych wywołań powoduje większość awarii przepływów pracy. Śledź co najmniej wskaźnik sukcesu dla każdej zależności oraz opóźnienia p50, p95 i p99. Na etapie rozsyłania danych rejestruj również czas oczekiwania w kolejce i puli połączeń, ponieważ „wolne API” może w rzeczywistości oznaczać przeciążonego klienta oczekującego na wolne połączenie.
Użyj śladów, aby odpowiedzieć na trzy praktyczne pytania: która zależność dominuje na ścieżce krytycznej, czy wielu wolnych agentów działa sekwencyjnie, kiedy mogliby działać współbieżnie, oraz czy skoki współbieżności pokrywają się z błędami 429, przekroczenia limitu czasu puli lub 5xx.
Krok 3: porównaj opóźnienia, błędy i kondycję zależności; skokowy wzrost limitu czasu zbiegający się z momentem, w którym jedna zależność uległa degradacji, sugeruje inne rozwiązanie niż skokowy wzrost współbieżności w całym systemie.
Krok 3: Utwórz budżet czasu wolnego od zewnątrz
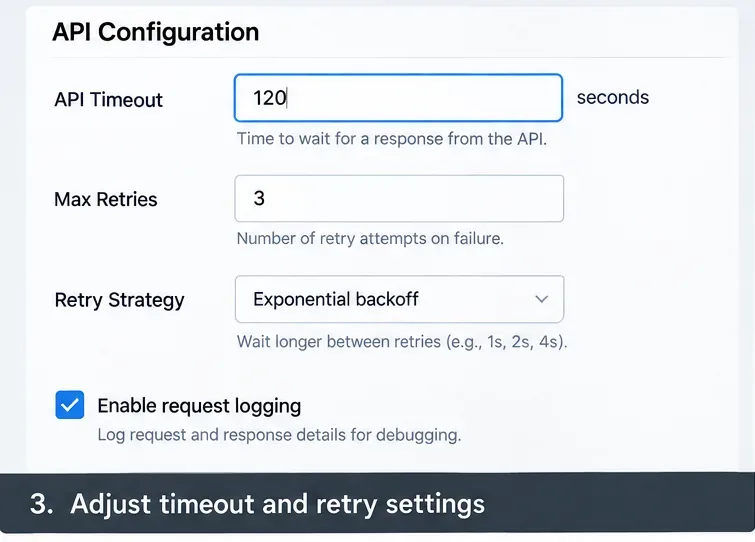
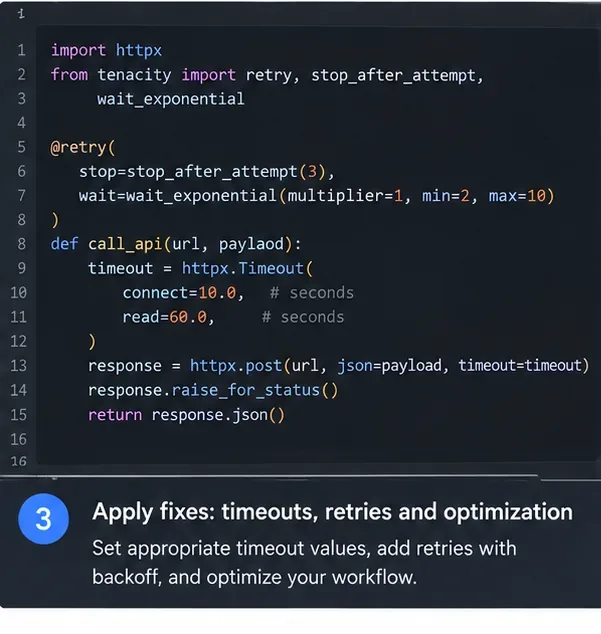
Najpierw ustal termin końcowy dla całego przepływu pracy, a następnie skróć terminy wewnętrzne, aby niższe warstwy uległy awarii wystarczająco wcześnie, umożliwiając orkiestratorowi odzyskanie sprawności. Na przykład, 120-sekundowy termin końcowy dla użytkownika może zarezerwować 10 sekund na orkiestrację i obsługę odpowiedzi, pozostawiając 110 sekund na użyteczną pracę. Wywołanie pojedynczego narzędzia może otrzymać 15 sekund, podczas gdy wywołanie modelu może otrzymać 45 lub 60 sekund, w zależności od zaobserwowanego opóźnienia końcowego.
Nie kopiuj tych wartości bezmyślnie; stanowią one przykładową metodę budżetowania, a nie uniwersalne wartości domyślne. Wybierz wartości z rozkładu zmierzonych opóźnień i docelowego poziomu usług (SLO) produktu. Zewnętrzny termin powinien być wystarczająco długi, aby uwzględnić wewnętrzne wywołanie, jego dozwolone ponowne próby, opóźnienia wycofywania i czas czyszczenia.
Python 3.11 i nowsze wersje umożliwiają asyncio.timeout()ustalenie terminu dla pracy asynchronicznej. Po upływie terminu zadanie jest anulowane, a menedżer kontekstu wyświetla komunikat TimeoutError. Zapoznaj się z oficjalną dokumentacją dotyczącą limitu czasu asyncio w Pythonie .
Krok 4: skonfiguruj wartości limitu czasu i ponownych prób jako skoordynowany budżet, zamiast zwiększać każdą wartość niezależnie.
Krok 4: Ogranicz współbieżność przed zwiększeniem liczby ponownych prób
Systemy wieloagentowe często zawodzą, ponieważ rozproszenie rośnie szybciej niż oczekiwano. Jeśli 20 żądań użytkownika uruchamia po pięciu agentów, a każdy agent uruchamia dwa narzędzia, system może wygenerować do 200 wywołań downstream przed ponownymi próbami. Dodanie ponownych prób w pierwszej kolejności może przekształcić przeciążenie w burzę ponownych prób.
Ogranicznik współbieżności jest często lepszym pierwszym krokiem w przypadku odpowiedzi 429, przekroczenia limitu czasu w puli, rosnącego czasu kolejki lub zależności w dół strumienia w momencie nasycenia. Python asyncio.Semaphoreoferuje prosty, oparty na licznikach sposób ograniczania liczby współprogramów wchodzących jednocześnie do sekcji chronionej. Zobacz oficjalną dokumentację semaforów Pythona .
import asyncio

sem = asyncio.Semaphore(8)

async def guarded_agent_call(agent, task):
    async with sem:
        return await agent.run(task)
Kompromis jest celowy: niższy limit chroni usługi downstream, ale może zwiększyć kolejkowanie w aplikacji. Dopasuj go do przepustowości, opóźnień p95, limitów szybkości i pojemności puli połączeń, zamiast wybierać największą liczbę, jaką może zaplanować Twój komputer.
Krok 5: połącz ograniczoną współbieżność z jawnymi ustawieniami transportu, aby pełna pula połączeń nie maskowała się jako powolny model lub narzędzie.
Krok 5: Ponawiaj próby tylko w przypadku błędów, które prawdopodobnie zakończą się sukcesem
Ponowne próby są przydatne w przypadku przejściowych awarii połączenia, limitów przepustowości, błędów wybranych serwerów i przekroczenia limitu czasu żądania, gdy powtórzenie operacji jest bezpieczne. Są one jednak nieodpowiednim rozwiązaniem domyślnym w przypadku błędów walidacji, błędów uwierzytelniania, błędów deterministycznych narzędzi lub działań niepożądanych bez ochrony idempotentności.
Zwróć uwagę na mnożenie ponownych prób. Jeśli zestaw SDK wykonuje dwie próby, oznacza to maksymalnie trzy próby dla jednego wywołania logicznego. Jeśli warstwa agenta również powtarza całe wywołanie dwukrotnie, teoretyczne maksimum wynosi dziewięć prób dla tej jednej operacji logicznej: trzy próby zewnętrzne pomnożone przez trzy próby zestawu SDK. Jeśli orkiestrator następnie ponawia próbę dla całego etapu z pięcioma agentami, liczba żądań może szybko wzrosnąć.
Centralizuj zarządzanie ponownymi próbami, gdzie to możliwe. W przypadku wywołań LLM z użyciem OpenAI Python SDK pamiętaj, że obecny SDK domyślnie ponawia pewne klasy błędów dwukrotnie. Dodaj zewnętrzne ponawianie tylko wtedy, gdy masz konkretny powód i możesz ograniczyć całkowity budżet prób. citeturn212133view0turn212133view1
Krok 6: sklasyfikuj błąd przed ponowną próbą; przekroczenie limitu czasu odczytu może uzasadniać ograniczoną ponowną próbę, natomiast trwały błąd konfiguracji zazwyczaj nie.
Krok 6: Skróć ścieżkę krytyczną, nie powodując problemu rozproszenia
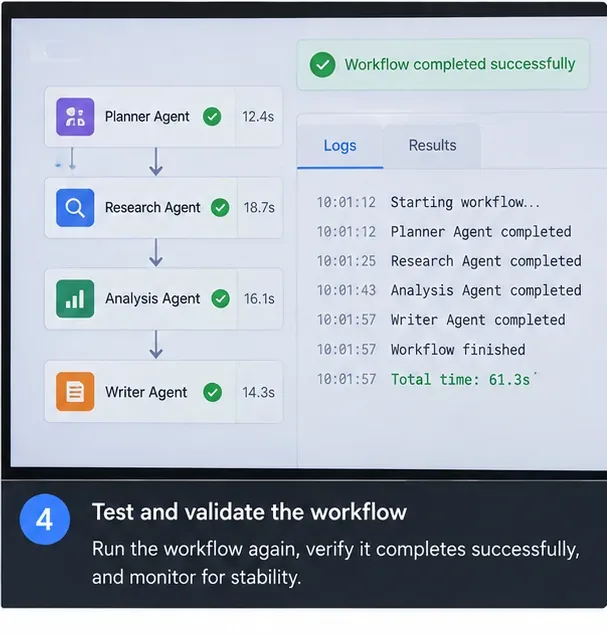
Jeśli agenci planujący, badający, ewaluujący i piszący działają ściśle jeden po drugim, całkowite opóźnienie jest w przybliżeniu sumą ich czasów trwania. Niezależne gałęzie mogą czasami działać równolegle, skracając czas zegarowy do najwolniejszej gałęzi, a nie do sumy wszystkich gałęzi.
Python asyncio.TaskGroupoferuje ustrukturyzowany sposób jednoczesnego uruchamiania powiązanych zadań. Aktualna dokumentacja Pythona informuje, że TaskGroup oczekuje na zadania w grupie i anuluje pozostałe zadania, gdy jedno z nich zakończy się niepowodzeniem z wyjątkiem braku anulowania, zapewniając silniejsze bezpieczeństwo niż nieustrukturyzowane generowanie zadań. Zobacz oficjalną dokumentację Python TaskGroup .
Paralelizacja nie jest darmowa. Jeśli ten sam dostawca wymusza ścisły limit żądań na minutę lub liczbę żądań współbieżnych, uruchomienie czterech agentów jednocześnie może zamienić powolny, ale skuteczny przepływ pracy w szybką serię 429 odpowiedzi. Paralelizuj tylko prawdziwie niezależne zadania i zachowaj globalny limit współbieżności.
Krok 7: Kiedy należy zaprzestać używania synchronicznego żądania HTTP?
Jeśli normalne przepływy pracy rutynowo trwają dłużej niż najkrótszy limit czasu żądania w ścieżce sieciowej, przejście na asynchroniczny model zadań jest zazwyczaj bardziej efektywne niż ciągłe wydłużanie każdego limitu czasu. Początkowe żądanie HTTP może zweryfikować dane wejściowe, utworzyć trwałe zadanie i natychmiast zwrócić identyfikator zadania. Następnie procesy robocze wykonują graf wieloagentowy poza cyklem życia żądania, podczas gdy klient otrzymuje informacje o postępie poprzez sondowanie, zdarzenia wysyłane przez serwer, WebSockety lub webhook.
Przesyłanie strumieniowe jest przydatne, gdy serwer może wcześnie rozpocząć wysyłanie sensownych danych wyjściowych. Na przykład pakiet OpenAI Python SDK obsługuje przesyłanie strumieniowe zdarzeń wysyłanych przez serwer dla wywołań API Responses. Przesyłanie strumieniowe poprawia postrzeganą responsywność i może utrzymać aktywne połączenie generujące dane, ale nie rozwiązuje automatycznie problemu maksymalnego czasu życia żądania każdego serwera proxy. Zobacz oficjalną dokumentację zdarzeń przesyłania strumieniowego OpenAI .
Wybierz zadanie asynchroniczne, gdy trwałość jest ważniejsza niż natychmiastowa prostota: długie zadania badawcze, przepływy pracy agentów z zatwierdzeniem ludzkim, wiele wywołań narzędzi, kosztowne operacje, których nie chcesz powtarzać, lub obciążenia, które muszą przetrwać rozłączenia klienta. Kosztem jest dodatkowe zarządzanie stanem: status zadania, punkty kontrolne, klucze idempotentności, anulowanie, przechowywanie wyników i własność ponownych prób.
Krok 7: w przypadku długich przepływów pracy śledź ukończenie pracy agenta jako trwały stan przepływu pracy, zamiast polegać na jednym połączeniu klienta, które ma pozostać otwarte, aż do zakończenia pracy każdego agenta.
Krok 8: Sprawdź poprawność poprawki przy realistycznym obciążeniu
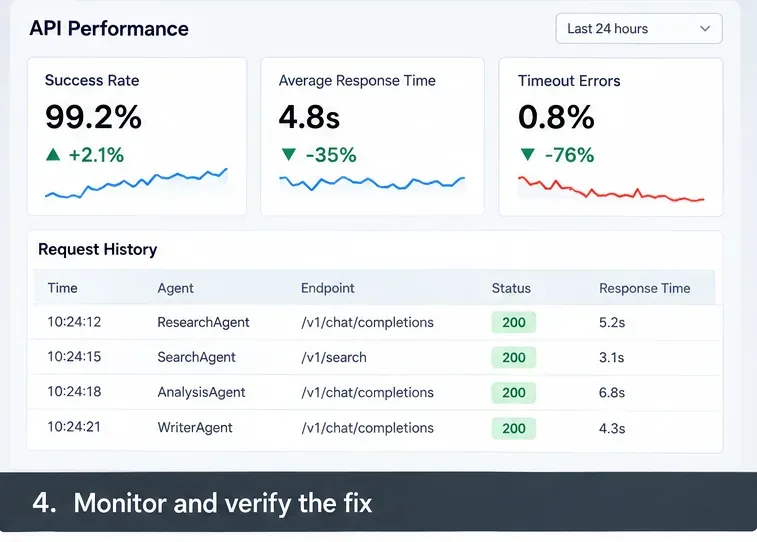
Rozwiązanie problemu nie jest potwierdzone sukcesem, ponieważ jedno żądanie się powiodło. Przetestuj przy oczekiwanej współbieżności w środowisku produkcyjnym i zmierz wskaźnik powodzenia, wskaźnik przekroczenia limitu czasu, liczbę prób ponownych na zadanie logiczne, opóźnienie p95 i p99, opóźnienie kolejki, oczekiwanie na pulę połączeń, wskaźniki pobierania 429/5xx oraz koszt ukończonego przepływu pracy.
Jeśli uruchamiasz agentów w Kubernetes, używaj gotowości i żywotności do różnych celów. Kubernetes dokumentuje sondy gotowości jako mechanizm określający, czy pod powinien odbierać ruch, podczas gdy sondy żywotności określają, kiedy kontener powinien zostać zrestartowany. Dokumentacja wyraźnie ostrzega, że źle zaimplementowane kontrole żywotności mogą powodować kaskadowe awarie pod obciążeniem. Zobacz oficjalną dokumentację sond Kubernetes .
W przypadku chwilowego przeciążenia, bycie „niegotowym” jest często bezpieczniejsze niż wielokrotne zabijanie zdrowych, ale zapracowanych pracowników. Awarie żywotności należy rezerwować na sytuacje, w których ponowne uruchomienie procesu jest rzeczywiście właściwym działaniem naprawczym.
Krok 8: zweryfikuj zmianę za pomocą wskaźników ruchu i opóźnień zbliżonych do tych uzyskiwanych w środowisku produkcyjnym, a nie tylko za pomocą pojedynczego udanego testu.
Jak stwierdzić, które rozwiązanie będzie odpowiednie dla danego schematu awarii?
Zaobserwowany wzór
Najbardziej przydatna pierwsza zmiana
Czego nie robić w pierwszej kolejności
Połączenia kończą się tuż po terminie dla klienta; downstream jest w dobrej kondycji
Zwiększ konkretny wewnętrzny limit czasu i ponownie zaplanuj budżet na termin zewnętrzny
Zwiększ liczbę ponownych prób
Błędy 429 i przekroczenia limitu czasu puli rosną wraz ze współbieżnością
Niższa współbieżność i dodanie kolejkowania/przeciwciśnienia
Uruchom więcej agentów równolegle
Sporadyczne awarie 408/5xx lub sieciowe
Użyj ograniczonych ponownych prób wykładniczego wycofywania dla operacji idempotentnych
Powtarzaj każdy wyjątek w nieskończoność
Przepływ pracy regularnie trwa dłużej niż limity bramy
Użyj architektury zadań asynchronicznych lub obsługiwanego projektu strumieniowego
Podnoś tylko limit czasu SDK
Jedna powolna zależność dominuje nad opóźnieniem p99
Zoptymalizuj, buforuj, zastąp lub wyizoluj tę zależność; rozważ rozwiązanie awaryjne
Dostrój limity czasu agentów niezwiązanych ze sobą
Błędy pojawiają się dopiero po dodaniu agentów równoległych
Zachowaj użyteczny paralelizm, ale dodaj globalny semafor i ograniczenia dla poszczególnych dostawców
Załóż, że równoległe jest zawsze szybsze
Praktyczna linia bazowa produkcji
W przypadku typowego interfejsu API obsługującego wiele agentów solidną linią bazową jest nadanie każdemu przepływowi pracy identyfikatora korelacji, śledzenie każdego wywołania agenta i narzędzia, zdefiniowanie jednego ostatecznego terminu, przypisanie krótszych terminów na wywołanie, wymuszenie globalnego limitu współbieżności dla każdego dostawcy usług podrzędnych, ograniczenie i idempotentność ponownych prób oraz zachowanie wystarczającego stanu, aby można było wznowić działanie lub zgłosić częściowe zakończenie.
Następnie dostosuj na podstawie pomiarów. Jeśli system jest stabilny, ale zbyt wolny, selektywnie paralelizuj niezależne zadania. Jeśli działa szybko przy niskim obciążeniu, ale zawodzi przy obciążeniu szczytowym, zmniejsz liczbę wyjść i dodaj obciążenie zwrotne. Jeśli udane przepływy pracy naturalnie trwają dłużej, niż pozwala na to synchroniczna ścieżka żądań, zmień architekturę zamiast próbować kazać każdemu serwerowi proxy czekać dłużej.