Zmniejszenie rachunku za API LLM o 50% jest możliwe w wielu obciążeniach roboczych, ale nie jest to uniwersalna gwarancja. Wynik zależy od tego, skąd pochodzą Twoje wydatki: tokeny wejściowe niebuforowane, tokeny wejściowe buforowane, tokeny wyjściowe, tokeny rozumowania, wywołania narzędzi lub ponowne próby. Kompresja promptów działa najlepiej, gdy długie lub powtarzalne dane wejściowe stanowią znaczną część rachunku. Praktycznym celem nie jest więc „skrócenie każdego promptu o połowę”. Jest nim „usunięcie tokenów, które nie zmieniają odpowiedzi, zachowanie tokenów, które to robią, oraz weryfikacja oszczędności na rzeczywistym ruchu”.
Ten przewodnik wykorzystuje cztery kroki wdrożeniowe: zmierzenie punktu odniesienia, usunięcie redundantnych danych wejściowych, organizację promptów w celu ponownego wykorzystania cache oraz przeniesienie szczegółowych instrukcji wyjściowych do sterowników strukturalnych, jeśli API je obsługuje. Przykłady mają charakter ilustracyjny, a nie twierdzeń benchmarkowych. Cenniki dostawców i zachowanie cache zmieniają się w czasie, dlatego przed dokonaniem szacunku produkcyjnego zweryfikuj aktualne stawki.
Czego faktycznie wymaga 50% redukcja kosztów API?
Zacznij od równania rozliczeniowego dla Twojego modelu. Dla prostego obciążenia tekstowego całkowity koszt żądania to w przybliżeniu koszt danych wejściowych niebuforowanych plus danych wejściowych buforowanych plus danych wyjściowych. Niektóre modele lub funkcje dodają inne kategorie rozliczeniowe. Obecne odpowiedzi API OpenAI ujawniają zużycie tokenów wejściowych i wyjściowych, w tym szczegóły dotyczące tokenów buforowanych, a strony modeli publikują oddzielne stawki za dane wejściowe, dane wejściowe buforowane i dane wyjściowe.
| Ilustracyjne obciążenie | Tokeny wejściowe | Tokeny wyjściowe | Wynik względny |
|---|
| Żądanie bazowe | 10 000 | 1 000 | 100% kosztu bazowego |
| Tylko dane wejściowe zmniejszone o połowę | 5 000 | 1 000 | Mniej niż 50% całkowitych oszczędności, gdy dane wyjściowe pozostają bez zmian |
| Dane wejściowe i wyjściowe zmniejszone o połowę | 5 000 | 500 | Około 50% niższy koszt oparty na tokenach, gdy stawki pozostają bez zmian |
Jako konkretny przykład, oficjalna strona modelu GPT-5.6 Sol wskazywała 11 września 2026 r. cenę 4 USD za milion tokenów wejściowych, 0,40 USD za milion buforowanych tokenów wejściowych oraz 20 USD za milion tokenów wyjściowych. Przy tych stawkach żądanie z 10 000 tokenów wejściowych i 1 000 tokenów wyjściowych kosztuje około 0,06 USD przed innymi opłatami. Zmniejszenie tylko danych wejściowych do 5 000 tokenów obniża ten przykład do około 0,04 USD, co stanowi redukcję o 33%. Zmniejszenie zarówno danych wejściowych, jak i wyjściowych o połowę obniża koszt do około 0,03 USD, co stanowi redukcję o 50%. Ceny te mogą ulec zmianie, więc traktuj tę arytmetykę jako metodę, a nie stałą wycenę. Zobacz oficjalną stronę modelu GPT-5.6 Sol, aby sprawdzić aktualne ceny.
Szybka referencja: cztery najbardziej wartościowe działania
| Technika | Najlepsze zastosowanie | Główne ryzyko | Co mierzyć |
|---|
| Audyt tokenów | Dowolne obciążenie produkcyjne | Optymalizacja niewłaściwego komponentu | Dane wejściowe, dane wejściowe buforowane, dane wyjściowe, ponowne próby, koszt na udane zadanie |
| Usuwanie redundancji | Długie prompty systemowe, powtarzalne polityki, rozwlekłe przykłady | Usunięcie ograniczenia, które faktycznie ma znaczenie | Sukces zadania i zgodność z instrukcjami |
| Układ przyjazny dla cache | Powtarzalne żądania dzielące stabilne instrukcje lub kontekst | Niskie ponowne wykorzystanie cache, ponieważ dynamiczny tekst pojawia się zbyt wcześnie | Stosunek tokenów buforowanych i opóźnienie |
| Sterowniki strukturalnych wyników | Ekstrakcja JSON, klasyfikacja, stałe formaty odpowiedzi | Schemat zbyt sztywny dla zadania | Tokeny wyjściowe, błędy parsowania, ponowne próby |
Krok 1: Zmierz rzeczywisty punkt odniesienia tokenów przed zmianą promptów
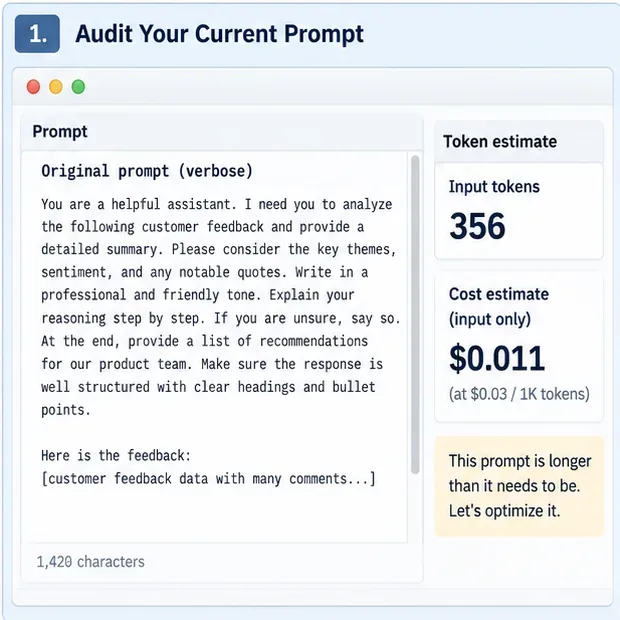
Podpis: Ilustracyjny interfejs audytu tokenów rejestruje oryginalny rozmiar promptu i przykładowy szacunek kosztów przed kompresją; liczby nie odzwierciedlają aktualnych cen dostawcy.
Zbierz reprezentatywną próbkę żądań produkcyjnych, zamiast optymalizować jeden ręcznie wybrany prompt. Co najmniej zapisz tokeny wejściowe, tokeny wejściowe buforowane (jeśli dostępne), tokeny wyjściowe, nazwę modelu, opóźnienie, ponowne próby oraz to, czy ostateczna odpowiedź przeszła Twoją kontrolę jakości biznesowej. Jeśli Twój dostawca oferuje punkt końcowy do liczenia tokenów wejściowych, użyj go przed wysłaniem żądań, gdy potrzebujesz deterministycznego budżetowania. OpenAI obecnie dokumentuje punkt końcowy do liczenia tokenów wejściowych w swoim oficjalnym referencji API.
Obliczaj koszt na udane zadanie, a nie tylko koszt na wywołanie API. Skompresowany prompt, który powoduje więcej ponownych prób, może być droższy, nawet jeśli każde żądanie jest krótsze. Segmentuj punkt odniesienia również według typu zadania: streszczanie, ekstrakcja, odpowiadanie na pytania RAG, agentowe użycie narzędzi i długie rozmowy zazwyczaj mają różne profile tokenów.
Krok 2: Usuń redundancję bez usuwania informacji krytycznych dla decyzji

Podpis: Ilustracyjny prompt przed i po zachowuje te same żądane wyniki, usuwając powtarzalne sformułowania i niepotrzebne instrukcje procesowe.
Najbezpieczniejszym pierwszym przebiegiem kompresji jest deduplikacja semantyczna. Usuń powtarzające się opisy ról, zduplikowane ograniczenia, grzecznościowe wypełniacze, wyjaśnienia oczywistego formatowania oraz przykłady, które uczą tego samego wzorca więcej niż raz. Scal nakładające się reguły w pojedynczą instrukcję. Preferuj jedno precyzyjne zdanie zamiast kilku zdań powtarzających ten sam wymóg.
Przed
Jesteś pomocnym asystentem, który jest ekspertem w analizie produktów.
Muszę, abyś przeanalizował poniższe opinie klientów i dostarczył
szczegółowe podsumowanie. Proszę zidentyfikuj kluczowe tematy, ogólny sentyment,
warte uwagi cytaty i rekomendacje dla naszego zespołu produktowego. Upewnij się,
że Twoja odpowiedź jest profesjonalna, jasna, zwięzła i dobrze ustrukturyzowana.
Po
Przeanalizuj opinie klientów.
Zwróć: kluczowe tematy, ogólny sentyment, warte uwagi cytaty i rekomendacje produktowe.
Bądź zwięzły i rzeczowy.
Nie kompresuj wyjątków, granic polityki, definicji domenowych, reguł bezpieczeństwa narzędzi ani wymagań dowodowych tylko dlatego, że są długie. To często tokeny o wysokiej wartości. Przydatnym testem jest pytanie: „Jeśli usunę to zdanie, czy akceptowalna odpowiedź może się zmienić?”. Jeśli tak, zachowaj je, chyba że sterownik API lub schemat mogą wymusić to samo zachowanie w bardziej niezawodny sposób.
Krok 3: Umieść stabilne treści na początku, a dynamiczne na końcu
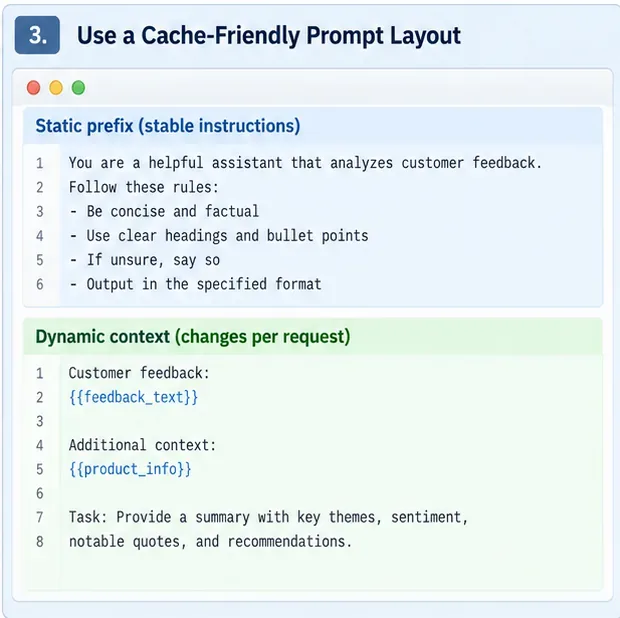
Podpis: Ilustracyjny układ promptu umieszcza stabilne instrukcje w wielokrotnie używanym prefiksie i dołącza kontekst specyficzny dla żądania później.
Pamięć podręczna promptów nie zmniejsza surowej liczby tokenów, ale może zmniejszyć kwotę rozliczaną przy normalnej stawce za dane wejściowe i obniżyć opóźnienie przetwarzania promptu. To sprawia, że układ promptu jest częścią optymalizacji kosztów. Zgrupuj instrukcje systemowe, wspólne przykłady, wskazówki dotyczące narzędzi i inne stabilne treści razem. Umieść fakty specyficzne dla żądania, pobrane fragmenty, dane użytkownika i bieżące pytanie na końcu.
Wytyczne modelu OpenAI wyraźnie zalecają umieszczanie treści statycznych na początku, a dynamicznych na końcu, aby poprawić ponowne wykorzystanie pamięci podręcznej promptów, a obiekt użycia odpowiedzi udostępnia informacje o tokenach buforowanych do pomiaru. Zobacz oficjalne wytyczne modelu oraz referencję API Responses.
Unikaj zmiany nieszkodliwych białych znaków, kolejności przykładów, znaczników czasu, losowych identyfikatorów lub tekstu specyficznego dla użytkownika wewnątrz w innym przypadku wielokrotnie używanego prefiksu, chyba że semantyka cache dostawcy mówi, że te zmiany są bezpieczne. Mierz trafienia cache z odpowiedzi API, zamiast zakładać, że prompt jest ponownie wykorzystywany.
Krok 4: Zastąp prozę dotyczącą formatu sterownikami strukturalnych wyników
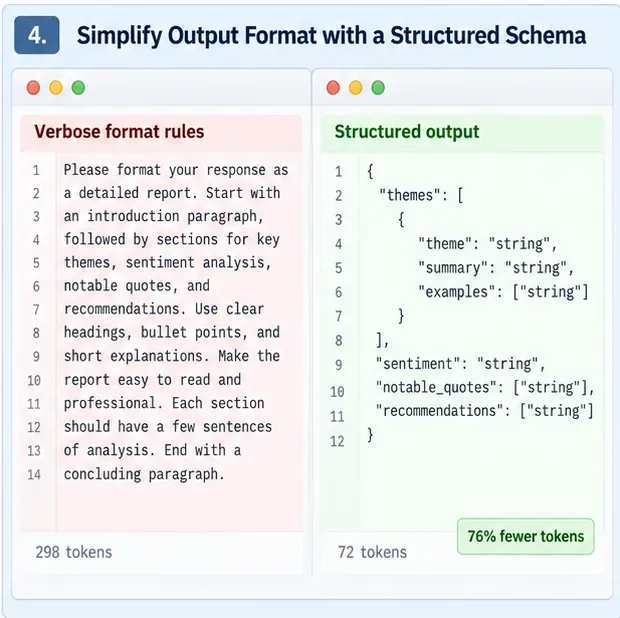
Podpis: Ilustracyjny widok strukturalnych wyników pokazuje, jak schemat może zastąpić wiele linii prozy wielokrotnie opisujących ten sam kształt odpowiedzi.
Prompty ekstrakcji i klasyfikacji często marnują tokeny na opisywanie pól JSON, dozwolonych wartości, zagnieżdżeń, kolejności i reguł walidacji w języku naturalnym. Gdy API obsługuje strukturalne wyniki lub typowane argumenty narzędzi, przenieś jak najwięcej tego kontraktu do interfejsu strukturalnego i utrzymaj instrukcję w języku naturalnym skupioną na znaczeniu.
Obecne wytyczne OpenAI konkretnie zalecają usuwanie definicji schematu wyjściowego z promptu, gdzie to możliwe, i używanie zamiast tego Structured Outputs. Może to zmniejszyć tekst promptu, a także zmniejszyć liczbę ponownych prób z powodu nieprawidłowych wyników. Dokładny mechanizm różni się w zależności od dostawcy, więc nie kopiuj formatu żądania specyficznego dla OpenAI do innego API bez sprawdzenia dokumentacji tego dostawcy.
Zaawansowana kompresja dla RAG, długich dokumentów i rozmów
Po ustabilizowaniu czterech podstawowych kroków, większe oszczędności zazwyczaj wynikają z zmniejszania kontekstu, a nie z dopracowywania sformułowań zdań. W systemach RAG pobieraj mniej, ale bardziej trafnych fragmentów, deduplikuj niemal identyczne kawałki i unikaj dołączania dokumentów, które nie mogą wpłynąć na odpowiedź. Dla długich rozmów zachowaj trwałe fakty i nierozstrzygnięte decyzje, ale streszczaj lub odrzucaj tury, które nie wpływają już na bieżące zadanie. Dla systemów agentowych udostępniaj tylko narzędzia i opisy narzędzi istotne dla bieżącego etapu, jeśli Twoja architektura bezpiecznie na to pozwala.
Uczone kompresory promptów są kolejną opcją dla bardzo długich kontekstów. Open-source'owy projekt Microsoftu LLMLingua implementuje kompresję promptów na poziomie tokenów. Oryginalna praca LLMLingua raportowała współczynniki kompresji do 20× z ograniczoną degradacją benchmarków w ocenianych ustawieniach. LongLLMLingua celuje w zadania z długim kontekstem, podczas gdy LLMLingua-2 używa uczonego kompresora niezależnego od zadania. Są to wyniki badań, a nie obietnica, że te same współczynniki zachowają jakość na Twoich danych. Przeprowadź benchmarki własnych zadań, języków, modeli i typów promptów przed wdrożeniem agresywnej kompresji.
Jak udowodnić, że optymalizacja jest faktycznie lepsza
Przeprowadź ewaluację A/B na tych samych reprezentatywnych żądaniach. Wersje bazowa i skompresowana powinny używać tego samego modelu, ustawień rozumowania, narzędzi, danych wejściowych wyszukiwania i kryteriów sukcesu. Zmieniaj jedną technikę kompresji na raz, gdy to możliwe, aby zidentyfikować przyczynę regresji.
| Metryka | Dlaczego ma znaczenie | Sugerowana interpretacja |
|---|
| Zmniejszenie tokenów wejściowych | Pokazuje surowe skurczenie się promptu | Przydatne, ale samo w sobie niewystarczające |
| Stosunek tokenów buforowanych | Pokazuje, czy stabilne prefiksy są ponownie wykorzystywane | Wyższy jest zazwyczaj lepszy, gdy jakość pozostaje bez zmian |
| Zmniejszenie tokenów wyjściowych | Może istotnie zmienić całkowity koszt | Zweryfikuj, czy zwięzła odpowiedź nadal kończy zadanie |
| Koszt na udane zadanie | Uwzględnia ponowne próby i błędy | To jest podstawowa metryka biznesowa |
| Sukces zadania / dokładność | Wykrywa utratę informacji | Ustaw akceptowalny próg nieinferiorności przed testowaniem |
| Opóźnienie p50 i p95 | Pokazuje rzeczywisty wpływ na użytkownika | Wstępne przetwarzanie kompresji może zniwelować oszczędności wnioskowania |
Nie ogłaszaj zwycięstwa tylko dlatego, że prompt jest o 50% krótszy. Silniejszym warunkiem akceptacji jest: skompresowana konfiguracja zmniejsza zmierzony koszt o mniej więcej docelową kwotę, pozostając w ramach zdefiniowanych wcześniej tolerancji jakości, opóźnienia i niezawodności.
Kiedy należy przestać kompresować?
Zatrzymaj się lub wycofaj, gdy następna redukcja usuwa fakty potrzebne do poprawnych decyzji, zwiększa halucynacje, powoduje błędy wywołań narzędzi, osłabia zgodność z polityką lub zwiększa liczbę ponownych prób na tyle, że niweluje oszczędności. Kompresja może również dodać opóźnienie, jeśli uruchamiasz osobny model do kompresji każdego promptu. Badanie z 2026 roku dotyczące kompresji promptów w rzeczywistych ustawieniach wnioskowania wykazało, że narzut wstępnego przetwarzania może zniwelować zyski z wnioskowania poza korzystnymi reżimami długości promptu i sprzętu, co jest kolejnym powodem do mierzenia wydajności end-to-end, a nie tylko liczby tokenów.
Dla małych promptów ręczne porządkowanie i organizacja przyjazna dla cache są zwykle łatwiejsze do uzasadnienia niż dodawanie dedykowanego modelu kompresji. Dla dużych ładunków RAG lub przepływów pracy z wieloma dokumentami wybór kontekstu i uczona kompresja stają się bardziej atrakcyjne, ponieważ objętość usuwalnych tokenów jest znacznie większa.
Szybka lista kontrolna wdrożenia
- Zarejestruj punkt odniesienia produkcyjny z danymi wejściowymi, danymi wejściowymi buforowanymi, danymi wyjściowymi, opóźnieniem, ponownymi próbami i sukcesem zadania.
- Najpierw usuń zduplikowane instrukcje, prozę o niskiej wartości i redundantne przykłady.
- Zachowaj definicje domenowe, wyjątki, wymagania dowodowe i ograniczenia bezpieczeństwa.
- Umieść stabilne treści promptu przed dynamicznymi treściami specyficznymi dla żądania, gdy semantyka cache nagradza wielokrotnie używane prefiksy.
- Używaj strukturalnych wyników lub schematów narzędzi zamiast wielokrotnego opisywania stałych formatów odpowiedzi w prozie.
- Dla RAG zmniejsz nieistotny i zduplikowany kontekst przed próbą kompresji na poziomie tokenów.
- Ograniczaj długość wyjścia tylko wtedy, gdy zadanie nadal może być poprawnie wykonane.
- Porównuj koszt na udane zadanie, a nie tylko liczbę tokenów promptu.
- Uruchamiaj testy regresji przed i po każdej istotnej zmianie kompresji.
- Ponownie sprawdzaj ceny dostawcy i reguły cache za każdym razem, gdy zmieniasz modele lub wersje API.
Podsumowanie
Redukcja o 50% jest rozsądnym celem inżynieryjnym dla niektórych rozwlekłych, obciążonych kontekstem obciążeń roboczych, ale powinna być traktowana jako wynik do walidacji, a nie domyślne oczekiwanie. Najbardziej niezawodną ścieżką jest najpierw mierzenie, usuwanie semantycznie redundantnego tekstu, maksymalizowanie bezpiecznego ponownego wykorzystania cache, skracanie kontraktów wyjściowych za pomocą sterowników strukturalnych, a następnie atakowanie największych pozostałych bloków kontekstu poprzez przycinanie wyszukiwania, streszczanie lub przetestowany kompresor promptów. Jeśli końcowy koszt na udane zadanie spada, a jakość pozostaje wewnątrz Twojego pasma akceptacji, kompresja działa. Jeśli jakość lub ponowne próby ulegają pogorszeniu, przywróć brakujące informacje i zoptymalizuj inną część żądania.
Główne odniesienia








