Strona główna
» Domeny
»
Jak uruchomić DeepSeek offline na Windows 11 z LM Studio
Jak uruchomić DeepSeek offline na Windows 11 z LM Studio
Tak – możesz uruchomić DeepSeek całkowicie offline na Windows 11 z LM Studio, ale najpierw potrzebujesz jednego połączenia z internetem do konfiguracji. Zainstaluj LM Studio, pobierz kompatybilny model DeepSeek i wymagane środowisko uruchomieniowe, załaduj model raz, a następnie możesz odłączyć się od internetu. Oficjalna dokumentacja offline LM Studio stwierdza, że rozmowy z pobranymi modelami, rozmowy z lokalnymi dokumentami oraz uruchamianie lokalnego serwera nie wymagają dostępu do internetu.
Dla typowego komputera z Windows 11 najbardziej praktycznym punktem wyjścia nie jest największy aktualny model DeepSeek. Mniejszy model GGUF, taki jak DeepSeek-R1-0528-Qwen3-8B, jest znacznie łatwiejszy do uruchomienia lokalnie. LM Studio opublikowało wsparcie dla tego 8B modelu destylowanego w maju 2025 roku i twierdzi, że działa on w formacie GGUF z LM Studio w wersji 0.3.16 lub nowszej. Dla porównania, wytyczne LM Studio z sierpnia 2026 roku dla DeepSeek V4 Flash mówią, że lokalne użycie wymaga około 156 GB pamięci systemowej. Czyni to V4 Flash złym wyborem dla większości konsumenckich maszyn z Windows, mimo że jest nowszy i bardziej wydajny.
Ten przewodnik został sprawdzony 11 września 2026 roku. Changelog LM Studio wymienia wersję 0.4.24 datowaną na 9 września 2026 roku. Ponieważ interfejs LM Studio ewoluuje, przycisk może się nieco przemieścić między wersjami, ale podstawowy przepływ pracy – pobranie modelu, załadowanie go, rozmowa lokalna i opcjonalne udostępnienie API localhost – pozostaje udokumentowany przez LM Studio.
Zanim zaczniesz: Czy Twój komputer z Windows 11 spełnia wymagania?
LM Studio obecnie obsługuje zarówno komputery z Windows x64, jak i systemy Windows oparte na ARM. Dla x64 procesor musi obsługiwać AVX2. LM Studio zaleca co najmniej 16 GB RAM i co najmniej 4 GB dedykowanej pamięci VRAM. Są to zalecenia na poziomie aplikacji, a nie obietnica, że każdy model się zmieści. Rozmiar modelu, kwantyzacja, długość kontekstu i odciążenie GPU wpływają na zużycie pamięci.
Co posiadasz
Praktyczna rekomendacja
Dlaczego
16 GB RAM, skromna karta graficzna lub grafika zintegrowana
Zacznij od modelu destylowanego DeepSeek 8B lub mniejszego w wariancie GGUF 4-bit
Utrzymuje to ślad modelu na stosunkowo zarządzalnym poziomie, zachowując użyteczne zdolności rozumowania.
Więcej RAM i mocniejsza karta graficzna
Wypróbuj większe warianty destylowane dopiero po sprawdzeniu szacunku dopasowania urządzenia w LM Studio
Większe modele mogą poprawić jakość, ale zużywają znacznie więcej pamięci i mogą być znacznie wolniejsze.
Zwykły komputer do gier lub laptop
Nie zaczynaj od DeepSeek V4 Flash
LM Studio twierdzi, że lokalny model V4 Flash wymaga co najmniej 156 GB pamięci systemowej.
Dokumentacja pobierania modeli LM Studio wyjaśnia, że kompilacje skwantyzowane wymieniają pewną wierność na mniejsze pliki i niższe obciążenie pamięci. Ogólna rekomendacja to wybór opcji 4-bit lub wyższej, gdy Twój sprzęt jest w stanie to obsłużyć. Jeśli nie jesteś pewien, wersja GGUF 4-bit jest rozsądnym pierwszym testem.
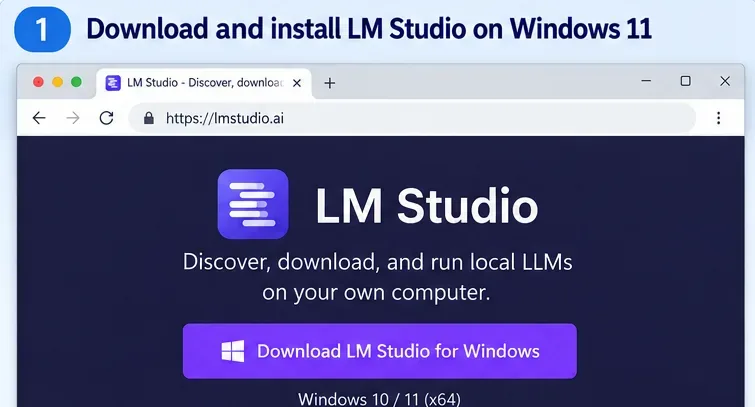
Pobierz aktualną stabilną wersję dla Windows ze oficjalnej strony pobierania LM Studio. Użyj instalatora pasującego do architektury Twojego systemu Windows. Na komputerze x64 upewnij się, że Twój procesor obsługuje AVX2, zanim będziesz rozwiązywać błędy ładowania modelu później.
Widok pobierania dla Windows w LM Studio. Wybierz instalator pasujący do Twojego systemu Windows 11, zanim przejdziesz do pobierania modelu.
Uruchom LM Studio, mając jeszcze połączenie z internetem. Ma to znaczenie, ponieważ aplikacja może potrzebować pobrać lub zaktualizować LM Runtime. LM Studio opisuje środowiska uruchomieniowe jako zapakowane silniki wnioskowania, takie jak jego runtime oparty na llama.cpp dla modeli GGUF. Pobieranie runtime wymaga połączenia, nawet jeśli wnioskowanie może działać offline później.
Krok 2: Pobierz model DeepSeek pasujący do Twojego PC
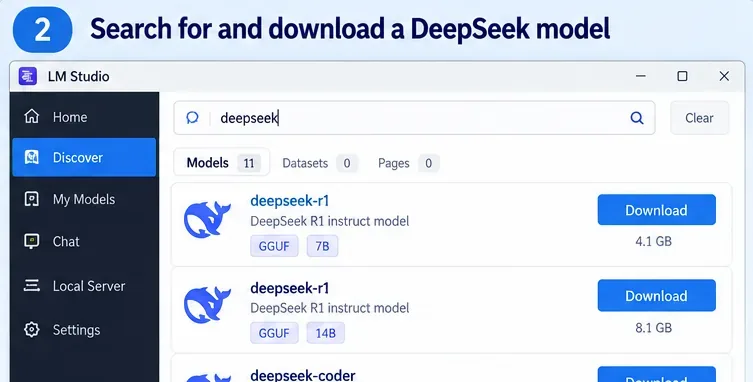
Otwórz obszar Discover w LM Studio i wyszukaj DeepSeek. LM Studio może przeszukiwać obsługiwane modele Hugging Face po słowie kluczowym, identyfikatorze user/model lub nawet pełnym URL Hugging Face.
Wyszukaj DeepSeek w Discover, a następnie wybierz model i kwantyzację odpowiednie dla Twojego sprzętu. Dokładne wpisy katalogowe i rozmiary plików zmieniają się w czasie.
Który model DeepSeek powinieneś wybrać?
Dla większości osób korzystających z tego przewodnika zacznij od DeepSeek-R1-0528-Qwen3-8B. LM Studio twierdzi, że ten destylowany model 8B obsługuje rozumowanie i użycie narzędzi, jest dostępny jako GGUF i może działać przy znacznie mniejszej pamięci niż flagowe modele DeepSeek. Wytyczne LM Studio dla Windows nadal zalecają 16 GB RAM dla całej aplikacji, więc nie traktuj twierdzenia o niskim zapotrzebowaniu na pamięć dla konkretnego modelu jako komfortowego celu dla całego systemu.
Jeśli kusi Cię DeepSeek V4 Flash, ponieważ jest nowszy, najpierw sprawdź wymagania sprzętowe. Oficjalny artykuł o V4 Flash LM Studio twierdzi, że model Mixture-of-Experts 284B wymaga co najmniej 156 GB pamięci systemowej do lokalnego użycia. Jest on wykonalny na stacjach roboczych z dużą pamięcią, a nie na zwykłym laptopie z Windows.
Krok 3: Załaduj model do pamięci
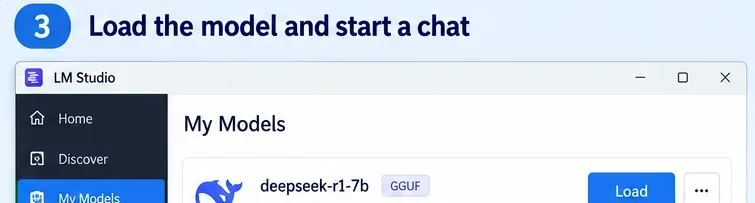
Po zakończeniu pobierania przejdź do pobranych modeli lub otwórz loader modeli z Chat. Wybierz model DeepSeek i załaduj go. LM Studio wyjaśnia, że ładowanie modelu alokuje pamięć dla wag modelu i powiązanego stanu środowiska uruchomieniowego.
Pobrany model GGUF DeepSeek gotowy do załadowania. Jeśli ładowanie nie powiedzie się, spróbuj mniejszego modelu lub kwantyzacji o niższym zapotrzebowaniu na pamięć, zanim zmienisz zaawansowane ustawienia.
Przy pierwszym uruchomieniu zachowaj konserwatywne ustawienia ładowania. Bardzo duże okno kontekstowe może zużywać znaczną dodatkową pamięć, więc nie ma powodu, aby maksymalizować kontekst od razu. Załaduj model z umiarkowanym kontekstem, zweryfikuj, że działa, i rozszerzaj go tylko wtedy, gdy wymaga tego Twoje obciążenie.
Jeśli LM Studio zgłasza, że model się nie mieści, najpewniejszym rozwiązaniem jest zazwyczaj wybór mniejszego modelu lub bardziej kompaktowej kwantyzacji. Zamknięcie aplikacji obciążających pamięć może pomóc, ale nie zmienia fundamentalnego śladu modelu.
Krok 4: Odłącz internet i zweryfikuj, czy DeepSeek naprawdę działa offline
To jest krok, który odróżnia „model lokalny” od zwykłego „używania klienta desktopowego”. Gdy model i jego środowisko uruchomieniowe są zainstalowane, wyłącz Wi-Fi i odłącz Ethernet. Następnie rozpocznij nowy czat i wyślij prosty prompt, taki jak:
Wyjaśnij różnicę między RAM a VRAM w pięciu punktach.
Jeśli model odpowiada, gdy komputer nie ma połączenia z siecią, wnioskowanie jest lokalne. LM Studio stwierdza, że gdy LLM znajduje się na Twoim urządzeniu, może działać całkowicie offline i że tekst wprowadzany do lokalnych czatów LLM nie opuszcza Twojego urządzenia. Dokumentacja offline stwierdza również, że lokalne przetwarzanie dokumentów i RAG pozostają na urządzeniu.
Załadowany model DeepSeek odpowiadający w LM Studio Chat. Aby samodzielnie zweryfikować działanie offline, odłącz dostęp do sieci po pełnym pobraniu modelu i runtime i powtórz prosty prompt.
Istnieje ważna granica: wyszukiwanie modeli, pobieranie nowych modeli, pobieranie środowisk uruchomieniowych i sprawdzanie aktualizacji aplikacji wymagają dostępu do internetu. Jeśli później dodasz modele chmurowe, zdalne serwery MCP, narzędzia internetowe lub inne integracje sieciowe, te funkcje również mogą wymagać połączenia. Twierdzenia o prywatności offline dotyczą lokalnego przepływu pracy, a nie usług, do których celowo łączysz się później.
Krok 5: Opcjonalnie – Użyj DeepSeek przez lokalne API
Jeśli chcesz, aby inna aplikacja Windows, skrypt, rozszerzenie IDE lub narzędzie wewnętrzne wywoływało Twój lokalny model DeepSeek, LM Studio może uruchomić lokalny serwer. Aktualna dokumentacja dla programistów mówi, że można go uruchomić ze strony Developer lub za pomocą:
lms server start
Domyślnie serwer jest dostępny pod adresem http://localhost:1234. LM Studio zapewnia natywne punkty końcowe REST i punkty końcowe zgodne z OpenAI. Sam serwer może działać offline, o ile model i środowisko uruchomieniowe są już lokalne. Jeśli jednak udostępnisz serwer poza localhost, najpierw sprawdź ustawienia uwierzytelniania i dostępu do sieci.
Za mało RAM/VRAM, zbyt duży kontekst lub nieobsługiwany CPU/runtime
Spróbuj mniejszego modelu DeepSeek, mniejszej kwantyzacji lub krótszego kontekstu. Na Windows x64 potwierdź obsługę AVX2.
LM Studio działa online, ale nie po odłączeniu
Model lub wymagane środowisko uruchomieniowe nie zostały w pełni pobrane
Połącz się raz, dokończ wszystkie pobierania modelu/runtime, załaduj model pomyślnie, a następnie powtórz test offline.
Generowanie jest bardzo wolne
Model jest zbyt duży dla dostępnego przyspieszenia GPU i w dużym stopniu polega na CPU/pamięci systemowej
Wybierz mniejszy model lub kwantyzację. Większy model nie jest użyteczny, jeśli opóźnienia czynią przepływ pracy niepraktycznym.
Nie możesz znaleźć modelu offline
Wyszukiwanie Discover wymaga dostępu do sieci
Pobierz modele przed przejściem w tryb offline lub załaduj plik modelu uzyskany w inny kontrolowany sposób.
Oczekiwałeś, że V4 Flash zadziała na zwykłym laptopie
Jego lokalne wymagania pamięciowe są klasy stacji roboczej
Użyj zamiast tego modelu destylowanego R1, chyba że Twój komputer ma około 156 GB lub więcej pamięci systemowej.
Kiedy ta konfiguracja jest dobrym wyborem
Uruchamianie DeepSeek offline z LM Studio jest dobrym wyborem, gdy chcesz prywatnego lokalnego wnioskowania, przewidywalnych kosztów po pobraniu modelu, eksperymentowania bez kluczy API lub API localhost do rozwoju. Jest to również przydatne, gdy Twój komputer musi działać bez dostępu do internetu.
Jest to słabszy wybór, gdy potrzebujesz najsilniejszego dostępnego modelu DeepSeek, ale masz tylko sprzęt konsumencki, gdy potrzebujesz ekstremalnie wysokiej przepustowości lub gdy Twoje obciążenie zależy od informacji z internetu w czasie rzeczywistym. Modele lokalne znają tylko to, co znajduje się w ich wagach i kontekście, który dostarczasz, chyba że celowo połączysz zewnętrzne narzędzia lub źródła danych.
Szybka lista kontrolna
Użyj systemu Windows 11 spełniającego wymagania LM Studio; procesory x64 potrzebują AVX2.
Zachowaj dostęp do internetu podczas początkowych pobrań LM Studio, runtime i modeli.
Zacznij od mniejszego modelu GGUF DeepSeek, zwłaszcza destylowanego modelu klasy 8B.
Wybierz kwantyzację 4-bit lub wyższą, jeśli Twój sprzęt jest w stanie ją obsłużyć.
Załaduj model pomyślnie przed odłączeniem sieci.
Wyłącz Wi-Fi/Ethernet i uruchom nowy prompt, aby zweryfikować wnioskowanie offline.
Zmniejsz rozmiar modelu lub długość kontekstu, jeśli napotkasz błędy pamięci.
Użyj serwera localhost LM Studio tylko wtedy, gdy potrzebujesz lokalnego dostępu do API.
Podsumowanie
Najłatwiejszym sposobem na uruchomienie DeepSeek offline na Windows 11 jest połączenie LM Studio z mniejszym modelem GGUF DeepSeek, który faktycznie mieści się na Twoim sprzęcie. Dla zwykłego PC destylowany model klasy 8B R1 jest znacznie bardziej realistycznym punktem wyjścia niż DeepSeek V4 Flash. Dokończ pobieranie będąc online, załaduj model, odłącz sieć i zweryfikuj, czy nowy czat nadal odpowiada. Gdy to zadziała, masz prawdziwie lokalną konfigurację DeepSeek, a nie nakładkę desktopową na API chmurowe.