Strona główna
» Domeny
»
Jak uniemożliwić agentom CrewAI wykonywanie zbędnych zadań: praktyczny przewodnik po deduplikacji
Jak uniemożliwić agentom CrewAI wykonywanie zbędnych zadań: praktyczny przewodnik po deduplikacji
Gdy agenci CrewAI zdają się wykonywać tę samą pracę dwukrotnie, przyczyną zazwyczaj nie jest pojedyncze ustawienie „duplikowania zadania”. Powtarzanie może wynikać z nakładających się opisów zadań, hierarchicznego delegowania, powtarzania prób, wielu wyzwalaczy przepływu, powtarzających się wyłączeń zespołu lub narzędzi powodujących efekty uboczne, które nie są chronione kluczem idempotentności.
To praktyczne odniesienie zostało sprawdzone pod kątem oficjalnej dokumentacji CrewAI 13 września 2026 r. Aktualna dokumentacja została rozwiązana do wersji CrewAI 1.15.14. Najważniejsza różnica polega na tym, że zapobieganie redundantnemu rozumowaniu w jednym przebiegu różni się od zapobiegania dwukrotnemu wystąpieniu tej samej akcji biznesowej w różnych przebiegach . CrewAI zapewnia kontekst zadania, zadania warunkowe, wywołania zwrotne, stan przepływu, trwałość i buforowanie narzędzi, ale nadal konieczne jest zaprojektowanie jawnych warunków pomijania dla zadań, które muszą zostać wykonane tylko raz.
Szybka diagnoza: dlaczego ta sama praca jest wykonywana dwa razy?
Objaw
Prawdopodobna przyczyna
Pierwsza poprawka do wypróbowania
Dwóch agentów bada ten sam temat
Nakładające się role lub opisy zadań
Przypisz każdemu zadaniu jednego właściciela i przekaż poprzednie wynikicontext
Menedżer prosi o pracę, którą wykonał już inny agent
Delegacja hierarchiczna i niejasne obowiązki
Wyjaśnij instrukcje menedżera, role agentów i własność narzędzi
To samo zadanie jest uruchamiane kilka razy po niepowodzeniu walidacji
Ponowne próby bariery ochronnej
Sprawdź błąd bariery ochronnej i zredukuj go guardrail_max_retriespodczas debugowania
Agent wielokrotnie dzwoni do tego samego narzędzia
Wysoki budżet iteracji, słaby warunek zatrzymania lub ponowne próby wywołania narzędzia
Obniż max_iter, zaostrz oczekiwany wynik i sprawdź dzienniki kroków
Metoda Flow jest uruchamiana więcej niż raz
Wiele @start()metod lub wiele zdarzeń upstream
Użyj pojedynczego punktu wejścia, routera, flag stanowych lub, and_gdy jest to właściwe,
Mutacja poczty e-mail/płatności/API występuje dwukrotnie po ponownym uruchomieniu
Brak ochrony idempotencji w poprzek biegu
Użyj deterministycznego klucza operacyjnego w trwałym lub zewnętrznym magazynie transakcyjnym
Włączyłeś pamięć, ale zadania nadal są uruchamiane ponownie
Pamięć dostarcza kontekst; nie jest deduplikatorem na poziomie harmonogramu
Śledź ukończoną pracę wyraźnie, zamiast polegać na jej przypomnieniu
Włączyłeś pamięć podręczną, ale całe zadanie uruchamia się ponownie
Pamięć podręczna CrewAI jest udokumentowana w celu uzyskania wyników wykonania narzędzia
Dodaj logikę pomijania na poziomie zadań lub magazyn idempotentności
1. Zacznij od jednego właściciela na jednostkę pracy
Najprostsza reguła zapobiegająca duplikacji jest jednocześnie najskuteczniejsza: każda sensowna jednostka pracy powinna mieć jednego właściciela zadania. W sekwencyjnym procesie CrewAI zadania są uruchamiane w kolejności ich deklarowania. contextAtrybut ten pozwala późniejszemu zadaniu na wykorzystanie wyników poprzedniego zadania zamiast niezależnego ponownego wyszukiwania tych samych informacji.
Łatwiej jest wnioskować o oddzielnej własności: jedno zadanie bada, kolejne analizuje badania, zamiast je powtarzać.
research_task: "Research the customer and summarize findings"
analysis_task: "Research the customer, analyze findings, and recommend actions"
writer_task:   "Review the customer, research missing details, and write the report"
Wszystkie trzy zadania zawierają pozwolenie na wyszukiwanie, więc powtarzanie wyszukiwania jest przewidywalne. Preferuj węższy łańcuch:
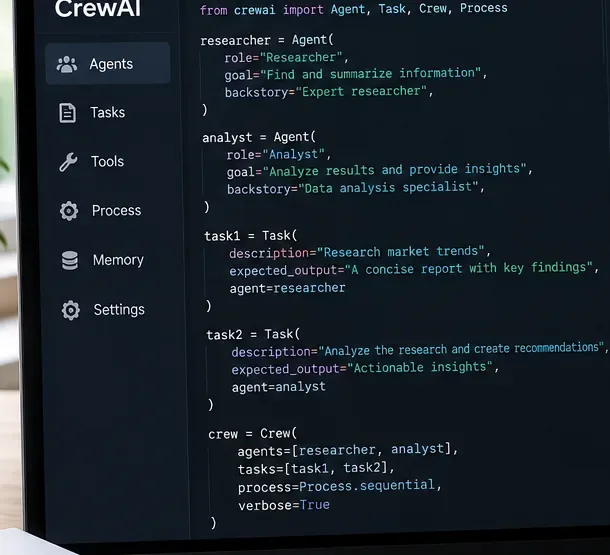
from crewai import Agent, Crew, Process, Task

research_task = Task(
    description="Research the customer once and return verified facts and sources.",
    expected_output="Structured research notes with sources.",
    agent=researcher,
)

analysis_task = Task(
    description="Analyze only the research provided in context. Do not perform new research.",
    expected_output="Prioritized findings and recommendations.",
    agent=analyst,
    context=[research_task],
)

crew = Crew(
    agents=[researcher, analyst],
    tasks=[research_task, analysis_task],
    process=Process.sequential,
)
Przypisz każdemu zadaniu czasownik inny od pozostałych: badanie, normalizacja, analiza, pisanie, przegląd.
Określ, czego zadanie nie powinno wykonywać, jeśli nakładanie się zadań jest kosztowne.
Określ oczekiwany wynik na tyle konkretnie, aby kolejne zadanie mogło go od razu wykorzystać.
Przekaż poprzednie wyniki contextzamiast mówić agentom, aby „zbadali, jeśli to konieczne”.
Ogranicz narzędzia na poziomie zadania lub agenta, jeśli tylko jedna rola powinna mieć możliwość wyszukiwania, zapisywania w bazie danych, wysyłania wiadomości lub wywoływania zewnętrznego interfejsu API.
2. Pomiń pracę, która jest już wykonana za pomocą ConditionalTask
Jeśli zadanie jest potrzebne tylko wtedy, gdy poprzedni wynik jest niekompletny, nie zmuszaj agenta do nieformalnej decyzji o powtórzeniu pracy. CrewAI udostępnia funkcję ConditionalTask, której warunek otrzymuje wynik poprzedniego zadania i może pominąć wykonywanie, gdy warunek jest fałszywy.
W oficjalnym przykładzie użyto warunku, który sprawdza, czy zwrócono wystarczającą liczbę rekordów zdarzeń; jeśli istnieje już wystarczająca ilość danych, zadanie dodatkowego pobierania jest pomijane. Zobacz Zadania warunkowe CrewAI .
from typing import List
from pydantic import BaseModel
from crewai import Agent, Crew, Task
from crewai.tasks.conditional_task import ConditionalTask
from crewai.tasks.task_output import TaskOutput

class ResearchOutput(BaseModel):
    sources: List[str]
    summary: str

def needs_more_sources(output: TaskOutput) -> bool:
    return len(output.pydantic.sources) < 5

research = Task(
    description="Find up to five authoritative sources about the topic.",
    expected_output="A structured research result.",
    agent=researcher,
    output_pydantic=ResearchOutput,
)

enrich = ConditionalTask(
    description="Find only the missing sources needed to reach five total.",
    expected_output="Additional authoritative sources only.",
    condition=needs_more_sources,
    agent=researcher,
)
Ten wzorzec jest skuteczniejszy niż polecenie agentowi „unikania wykonywania duplikowanej pracy”, ponieważ decyzja o pominięciu jest deterministyczną logiką Pythona, a nie kolejnym osądem opartym na modelu języka.
3. Wiedz, kiedy delegowanie powoduje widoczne duplikowanie
CrewAI obsługuje zarówno procesy sekwencyjne, jak i hierarchiczne. W zespole hierarchicznym kierownik przydziela zadania, deleguje pracę, weryfikuje wyniki i ocenia, czy wykonanie zadań jest satysfakcjonujące. Ta elastyczność jest przydatna, gdy przydział zadań musi być dynamiczny, ale oznacza również, że odpowiedzialność jest mniej jednoznaczna niż w zespole sekwencyjnym.
Dokumentacja agenta CrewAI podaje obecnie, że allow_delegationwartość domyślna to False. Należy zachować tę wartość domyślną dla specjalistów, chyba że agent faktycznie musi powierzyć pracę innemu agentowi. W procesie hierarchicznym za delegowanie zadań odpowiada sam menedżer. Zobacz przewodnik po procesach hierarchicznych .
Bezpiecznym punktem wyjścia dla załogi wykonującej powtarzające się zgłoszenia jest:
researcher = Agent(
    role="Researcher",
    goal="Collect evidence once and return it in structured form.",
    backstory="You gather evidence; you do not write the final report.",
    allow_delegation=False,
    max_iter=8,
    max_retry_limit=1,
)

writer = Agent(
    role="Writer",
    goal="Write from supplied context without doing fresh research.",
    backstory="You synthesize existing evidence into a final answer.",
    allow_delegation=False,
    max_iter=6,
)
Następnie dodawaj delegację tylko tam, gdzie przynosi to wymierne korzyści. Jeśli hierarchiczna orkiestracja nie jest potrzebna, Process.sequentialłatwiej jest debugować, ponieważ kolejność zadań i ich własność są jasno określone.
4. Nie myl ponawiania prób z duplikowaniem harmonogramu
Oczekuje się powtarzania niektórych zadań. Zabezpieczenia zadań CrewAI mogą weryfikować dane wyjściowe i wysyłać informacje zwrotne do agenta w przypadku niepowodzenia weryfikacji. Aktualna dokumentacja zadania podaje guardrail_max_retrieswartość domyślną 3, a w przypadku niepowodzenia zabezpieczenia zadania, zadanie jest ponawiane do tego limitu.
Agenci ujawniają również max_retry_limitbłędy wykonania i max_itermaksymalną liczbę iteracji agenta przed wygenerowaniem najlepszej dostępnej odpowiedzi. Aktualna dokumentacja agenta podaje domyślną wartość max_iter20 i domyślny limit ponownych prób wystąpienia błędu wynoszący 2.
Mechanizmy te rozwiązują różne problemy:
Ustawienie
Co ogranicza
Dlaczego może to wyglądać na zbędne
guardrail_max_retries
Ponowne próby po niepowodzeniu walidacji wyników zadania
To samo zadanie jest celowo wykonywane ponownie z uwzględnieniem informacji zwrotnej z bariery ochronnej
max_retry_limit
Ponowne próby po błędach wykonania
Nieudana próba może spowodować powtórzenie wywołania narzędzia
max_iter
Iteracje rozumowania agenta/narzędzia
Niepewny agent może wykonać kilka podobnych wywołań narzędzi przed zakończeniem
Podczas debugowania tymczasowo zmniejsz te limity. Jeśli powtarzalność zniknie, sprawdź, dlaczego zadanie nie przeszło walidacji lub dlaczego agent uznał, że konieczna jest kolejna iteracja narzędzia. Nie ustawiaj po prostu wszystkich wartości ponownych prób na zero w środowisku produkcyjnym; ponowne próby mogą być odpowiednie w przypadku przejściowych błędów.
5. Prześledź, co naprawdę zostało wykonane przed ponownym napisaniem monitów
Rejestry wykonania pomagają oddzielić faktyczne drugie uruchomienie zadania od wielu kroków, ponownych prób lub wywołań narzędzi w ramach jednego zadania.
CrewAI udostępnia kilka haków obserwowalności. Na poziomie załogi bieżąca dokumentacja obejmuje kontrolki verbose, step_callback, task_callback, output_log_filei śledzenia. Agenci również obsługują step_callback. Są one przydatne do odpowiedzi na cztery pytania:
Czy harmonogram uruchomił to samo zadanie dwukrotnie?
Czy jeden agent wykonał wiele iteracji w ramach jednego zadania?
Czy bariera ochronna odrzuciła wyjście i spowodowała ponowną próbę?
Czy wywołanie narzędzia zostało powtórzone, mimo że samo zadanie zostało wykonane raz?
W celu przeprowadzenia początkowej diagnostyki włącz szczegółowe dane wyjściowe i plik dziennika JSON:
Następnie możesz dodać wywołania zwrotne, jeśli potrzebujesz ustrukturyzowanych liczników lub niestandardowej telemetrii. Zapoznaj się z dokumentacją atrybutów załogi CrewAI .
6. Zapobiegaj duplikowaniu wyzwalaczy przepływu
Przepływy wprowadzają kolejną klasę powtórzeń. Aktualna dokumentacja przepływów CrewAI mówi, że wszystkie spełnione @start()metody są wykonywane po rozpoczęciu lub wznowieniu przepływu. Jeśli zdefiniujesz kilka bezwarunkowych startów i dwa z nich ostatecznie uruchomią tę samą załogę, duplikacja będzie na grafie, a nie w samej załodze.
Podobnie, or_nasłuchiwacze mogą być uruchamiani, gdy dowolna metoda nadrzędna emituje dane wyjściowe. Przykład CrewAI pokazuje, że nasłuchiwacz jest uruchamiany jednokrotnie dla każdej emisji nadrzędnej. Należy z tego korzystać, and_gdy operacja podrzędna powinna czekać na spełnienie wszystkich wymagań wstępnych lub @router()gdy powinna zostać wykonana dokładnie jedna gałąź.
Zanim dodasz drugi @start(), zastanów się, czy rzeczywiście reprezentuje on niezależny punkt wejścia. Jeśli nie, użyj jednej metody startowej i jawnych nasłuchiwaczy.
7. Dodaj klucz uzupełniający dla idempotencji między przebiegami
Jest to najważniejszy wzorzec produkcyjny, gdy zadanie wykonuje zewnętrzny efekt uboczny, taki jak wysłanie wiadomości e-mail, naliczenie opłaty za metodę płatności, utworzenie rekordu CRM, opublikowanie wiadomości lub rozpoczęcie zadania.
Przepływy CrewAI obsługują stan strukturalny i @persistdekorator. Trwałość pozwala przepływowi odzyskać stan po restarcie. Jednak sam stan trwały nie decyduje o tym, czy akcja biznesowa powinna zostać pominięta. Zapisz własny deterministyczny klucz operacji i sprawdź go przed wykonaniem efektu ubocznego.
Trwałość i pamięć to przydatne elementy składowe, jednak w procesie produkcyjnym nadal potrzebna jest wyraźna reguła „już ukończone?” dla czynności, które muszą zostać wykonane raz.
from hashlib import sha256
import json
from pydantic import BaseModel
from crewai.flow.flow import Flow, start
from crewai.flow.persistence import persist

class JobState(BaseModel):
    completed_keys: list[str] = []
    report: str = ""

def operation_key(customer_id: str, period: str) -> str:
    payload = {"customer_id": customer_id, "period": period}
    raw = json.dumps(payload, sort_keys=True).encode()
    return sha256(raw).hexdigest()

@persist
class ReportFlow(Flow[JobState]):

    @start()
    def run_report(self):
        key = operation_key("customer-123", "2026-09")

        if key in self.state.completed_keys:
            return self.state.report

        result = reporting_crew.kickoff(
            inputs={"customer_id": "customer-123", "period": "2026-09"}
        )

        self.state.report = result.raw
        self.state.completed_keys.append(key)
        return self.state.report
Dokumenty CrewAI, które @persistmogą przechowywać stan Flow po restartach i które po wznowieniu z tym samym identyfikatorem stanu wczytują najnowszą migawkę. Zobacz dokumentację dotyczącą trwałości Flow w CrewAI .
Ważne zastrzeżenie produkcyjne: powyższy przykład jest przydatny w przypadku standardowej deduplikacji przepływu pracy, ale nie wystarcza w przypadku skutków ubocznych o znaczeniu finansowym lub prawnym. Proces może ulec awarii po pomyślnym wykonaniu akcji zewnętrznej, ale przed utrwaleniem klucza zakończenia. Aby zapewnić silne działanie typu „dokładnie raz”, należy użyć zewnętrznego magazynu transakcji lub klucza idempotentności docelowego interfejsu API i zarejestrować operację atomowo, o ile to możliwe.
8. Buforuj powtarzające się wywołania narzędzi, ale nie myl pamięci podręcznej z idempotencją zadań
Agenci i załogi CrewAI ujawniają błąd cache, który w oficjalnej dokumentacji jest opisywany jako buforowanie wyników działania narzędzia. Aktualna dokumentacja agenta pokazuje, że buforowanie jest domyślnie włączone, a wytyczne dotyczące wydajności zalecają pozostawienie go włączonego w przypadku powtarzalnego użycia narzędzia.
To pomaga, gdy agent wykonuje to samo kosztowne wyszukiwanie lub wywołuje to samo deterministyczne narzędzie więcej niż raz. Nie oznacza to , że dwukrotne wywołanie crew.kickoff()automatycznie pominie zadania zespołu. Zadanie nadal należy do grafu wykonania.
Użyj pamięci podręcznej do powtarzających się odczytów. Użyj klucza idempotentności do powtarzających się zapisów.
Działanie
Preferowana ochrona
Przeszukaj tę samą dokumentację
Pamięć podręczna narzędzi
Ponowne wykorzystanie wcześniejszej wiedzy w różnych zadaniach
Pamięć lub kontekst zadania
Pomiń zadanie opcjonalne, jeśli istnieje już wystarczająca ilość danych
Router, stan stanu and_lub przeprojektowanie grafu
Zapobiegaj duplikowaniu zewnętrznych zapisów podczas ponownych prób/ponownych uruchomień
Trwały klucz idempotencji lub zewnętrzny magazyn transakcyjny
9. Pamięć zmniejsza częstotliwość powtarzania odkryć, ale nie anuluje zadań
Zunifikowany system pamięci CrewAI przechowuje fakty po zadaniach i przywołuje odpowiedni kontekst przed zadaniami. Aktualna dokumentacja stwierdza, że po włączeniu pamięci załogi, dyskretne fakty są wyodrębniane z wyników zadań, a odpowiednie wspomnienia są wstrzykiwane do późniejszych komunikatów zadań.
Może to ograniczyć niepotrzebne ponowne odkrywanie, zwłaszcza gdy autor powinien wiedzieć, co badacz już odkrył. Pamięć to jednak kontekst wyszukiwania, a nie flaga pominięcia. Jawnie zaplanowane zadanie nadal działa, chyba że logika Crew lub Flow zdecyduje inaczej.
Użyj pamięci w przypadku odpowiedzi na pytanie „Co już wiemy?” Użyj stanu lub zadania warunkowego w przypadku odpowiedzi na pytanie „Czy ta operacja powinna zostać uruchomiona?” Zobacz Pamięć CrewAI .
10. Korzystaj ze strukturalnych wyników, aby decyzje o pominięciu były wiarygodne
Dane wyjściowe w języku naturalnym są trudne do wykorzystania w deterministycznym sterowaniu przepływem pracy. Zadania CrewAI mogą zwracać dane wyjściowe w formacie Pydantic lub JSON za pośrednictwem output_pydantici output_json. Ustrukturyzowany wynik ułatwia podjęcie decyzji, czy konieczne jest wzbogacenie, przegląd, eskalacja, czy inne zadanie.
Następnie kieruj się polami, zamiast prosić innego agenta o interpretację akapitu prozą. Zwykle zmniejsza to zarówno duplikację pracy, jak i niejasności w odpowiedziach.
Zalecana konfiguracja antyredundancyjna
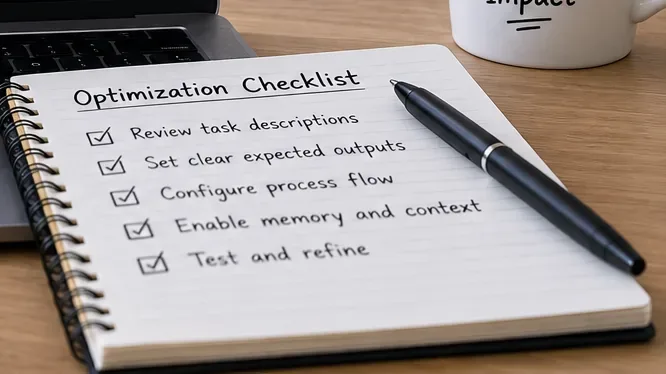
Przed zwiększeniem złożoności modelu przydatna jest kompaktowa lista kontrolna: większość problemów związanych z redundancją łatwiej rozwiązać na etapie projektowania zadań i przepływu sterowania.
W przypadku typowego procesu od badań do raportowania zacznij konserwatywnie:
Następnie dodawaj złożoność tylko wtedy, gdy wymaga tego wymaganie:
Dodaj pamięć, gdy fakty powinny być ponownie wykorzystywane w różnych zadaniach lub przebiegach.
Dodaj zadanie ConditionalTask, jeśli zadanie ma zostać uruchomione tylko wtedy, gdy poprzednie dane wyjściowe są niekompletne.
Stosuj proces hierarchiczny , gdy naprawdę zachodzi potrzeba dynamicznego przydzielania zadań menedżerom.
Włącz delegowanie tylko w przypadku agentów, którzy muszą przekazywać zadania współpracownikom.
Dodaj zabezpieczenia dla lepszej jakości wydruku, akceptując fakt, że uszkodzona osłona celowo powoduje konieczność ponawiania prób.
Dodaj trwałość przepływu, gdy stan musi przetrwać ponowne uruchomienia.
Dodaj zewnętrzną warstwę idempotentności, jeśli duplikowanie efektów ubocznych jest niedopuszczalne.
Ostateczna lista kontrolna rozwiązywania problemów
Czy Taskna liście zadań załogi zadeklarowano dwa razy to samo?
Czy dwa opisy zadań upoważniają do przeprowadzenia tych samych badań lub użycia tych samych narzędzi?
Czy późniejsze zadanie może contextzamiast tego wykorzystać zadanie wcześniejsze?
Czy powtarzane zadanie powinno być ConditionalTask?
Czy używasz orkiestracji hierarchicznej, gdy orkiestracja sekwencyjna byłaby wystarczająca?
Czy jest allow_delegationwłączona w przypadku agentów, którzy jej nie potrzebują?
Czy odrzucenie bariery ochronnej powoduje ponowną próbę?
Czy jest max_iterna tyle duży, że jedno zadanie wykonuje wiele podobnych wywołań narzędzi?
Czy wiele @start()metod lub or_słuchaczy zwalnia tę samą załogę?
Czy sekunda kickoff()oznacza celowe nowe uruchomienie czy przypadkowe duplikowanie wywołania?
Czy polegasz na pamięci lub pamięci podręcznej tak, jakby były to elementy sterujące idempotentnością na poziomie zadań?
Czy zapisy zewnętrzne mają deterministyczny klucz idempotentności?
Czy dzienniki mogą udowodnić, czy duplikat wystąpił na poziomie zadania, kroku agenta, narzędzia czy przepływu?
Podsumowanie
Zatrzymanie powtarzalnej pracy CrewAI to głównie problem orkiestracji. Jasno określ własność, łącz zadania w łańcuchy context, warunkowo pomijaj zadania, które zostały już wykonane, zawęź delegację, wiedz, kiedy ponowne próby są celowe i śledź wykonanie przed zmianą monitów. W przypadku przepływów i efektów ubocznych produkcji pójdź o krok dalej: utrwal deterministyczny klucz ukończenia lub użyj zewnętrznego mechanizmu idempotentności.
Użyteczny model mentalny jest prosty: kontekst zapobiega ponownemu odkryciu, warunki zapobiegają niepotrzebnym zadaniom, pamięć podręczna zapobiega powtarzaniu obliczeń narzędzia, a idempotentność zapobiega powtarzającym się efektom ubocznym . Rozwiązują one powiązane problemy, ale nie są zamienne.