Dobra konfiguracja Ollama–Obsidian to nie tylko taka, w której pole czatu zwraca tekst. W przypadku osobistego zarządzania wiedzą lepszym testem jest to, czy system potrafi wykorzystać zamierzone notatki, zachować Twoją kontrolę nad sejfem, odpowiadać w akceptowalnym czasie i przyznać, gdy notatki nie zawierają odpowiedzi. Jeśli te warunki nie są spełnione, zmiana modelu, konfiguracji wyszukiwania lub wtyczki jest bardziej użyteczna niż wielokrotne modyfikowanie promptów.
Według stanu na wrzesień 2026 roku lokalne API Ollama jest nadal domyślnie obsługiwane pod adresem http://localhost:11434, z trasami API pod /api, a dostęp lokalny nie wymaga uwierzytelniania. Ollama oferuje również modele osadzające (embeddings) do wyszukiwania semantycznego i generowania wspieranego wyszukiwaniem (RAG), co sprawia, że odpowiadanie na pytania dotyczące całego sejfu różni się zasadniczo od zwykłego czatu. Zobacz oficjalne wprowadzenie do API Ollama, dokumentację uwierzytelniania lokalnego oraz dokumentację osadzania.
W tym przewodniku używamy Copilot for Obsidian jako przykładu wtyczki społecznościowej, ponieważ jej projekt obecnie obsługuje lokalne modele Ollama i przepływy pracy zorientowane na sejf. Dokładne nazwy ustawień mogą się zmieniać między wersjami wtyczki, więc jeśli etykieta w Twojej instalacji różni się od zrzutów ekranu lub kroków poniżej, skorzystaj z aktualnego repozytorium Copilot for Obsidian i jego przewodnika konfiguracji modelu lokalnego.
Co powinna osiągnąć udana lokalna konfiguracja PKM?
Zanim cokolwiek zainstalujesz, zdefiniuj oczekiwany rezultat. Przydatna lokalna konfiguracja powinna przejść cztery praktyczne testy:
- Połączenie: Obsidian może połączyć się z modelem, który Ollama faktycznie obsługuje na Twoim komputerze.
- Osadzenie w kontekście (Grounding): gdy pytasz o notatkę lub swój sejf, odpowiedź odzwierciedla treść właściwej notatki, zamiast polegać wyłącznie na ogólnym treningu modelu.
- Wydajność: czas odpowiedzi i zużycie pamięci są na tyle akceptowalne, że realistycznie będziesz korzystać z tego przepływu pracy.
- Kontrola: wiesz, która wtyczka może czytać lub modyfikować notatki, z jakiego punktu końcowego modelu korzysta i czy włączone są opcjonalne funkcje sieciowe lub chmurowe.
Te kryteria mają znaczenie, ponieważ „połączony model lokalny” i „dobre osobiste zarządzanie wiedzą” to nie to samo. Czat może działać idealnie, podczas gdy wyszukiwanie w sejfie jest słabe, a silny model nadal może generować złe odpowiedzi, jeśli pobierane są niewłaściwe notatki.
Krok 1: Zainstaluj Ollama, pobierz model i zweryfikuj lokalne API
Zainstaluj Ollama, korzystając z oficjalnych instrukcji dla swojego systemu operacyjnego. Ollama obecnie obsługuje macOS, Windows i Linux; oficjalny szybki start jest najbezpieczniejszym punktem wyjścia, ponieważ instalacja i rekomendacje modeli zmieniają się w czasie.
Pobierz model czatu przed otwarciem Obsidian. Na przykład:
ollama pull gemma3
ollama ls
Nie musisz używać gemma3. Ważne jest, aby nazwa modelu, którą później wpiszesz w Obsidian, odpowiadała modelowi, który Ollama może wyświetlić lokalnie. Zacznij od modelu, który Twój komputer może uruchomić komfortowo, zamiast automatycznie wybierać największy dostępny model.
Następnie zweryfikuj API niezależnie od Obsidian:
curl http://localhost:11434/api/tags
Jeśli to polecenie zwraca listę JSON zawierającą Twój model, podstawowa usługa Ollama działa. Możesz również uruchomić ollama ps, gdy model jest aktywny. Ollama dokumentuje to polecenie jako sposób na sprawdzenie, czy model jest załadowany do pamięci CPU, GPU, czy mieszanki obu. Jeśli odpowiedzi są boleśnie wolne lub komputer staje się nieodpowiedzialny, jest to sygnał, aby przejść na mniejszy model lub zmniejszyć wymagania dotyczące kontekstu, zamiast zakładać, że problemem jest Obsidian.
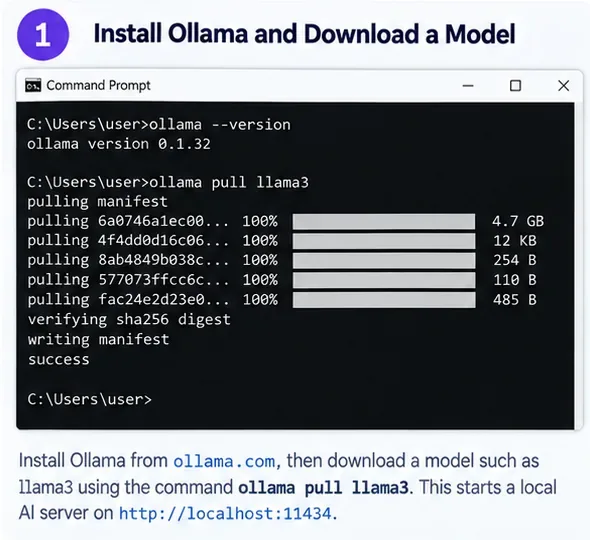
Ilustracja wygenerowana przez AI przedstawiająca krok instalacji Ollama i pobierania modelu. Numery wersji i szczegóły pobierania modelu widoczne na obrazie są ilustracyjne, a nie zapisem aktualnego wydania.
Krok 2: Zainstaluj wtyczkę Obsidian i połącz jej model czatu z Ollama
Obsidian traktuje wtyczki społecznościowe jako kod stron trzecich. Jego oficjalna dokumentacja ostrzega, że te wtyczki wykonują kod w Twoim imieniu, więc przejrzyj źródło wtyczki i uprawnienia, jeśli Twój sejf zawiera wrażliwe materiały. Aby zainstalować jedną z nich, otwórz Ustawienia → Wtyczki społecznościowe, włącz wtyczki społecznościowe, jeśli jest to konieczne, wybierz Przeglądaj, a następnie zainstaluj i włącz wtyczkę. Dokładny proces jest udokumentowany na oficjalnej stronie pomocy Obsidian dotyczącej wtyczek społecznościowych.
W tym przewodniku zainstaluj Copilot z katalogu społecznościowego i upewnij się, że wtyczka wskazuje na zweryfikowany projekt Copilot for Obsidian, do którego link znajduje się powyżej. Unikaj wybierania podobnie nazwanej wtyczki tylko dlatego, że pojawia się pierwsza w wynikach wyszukiwania.
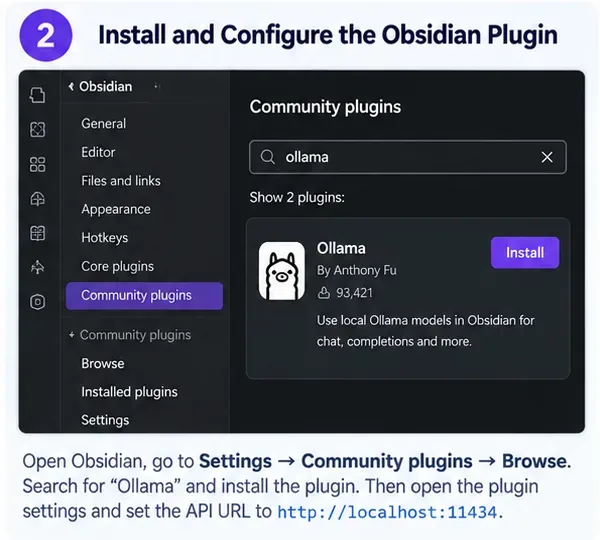
Koncepcyjna ilustracja wygenerowana przez AI przedstawiająca przeglądarkę wtyczek społecznościowych. Karta wtyczki, nazwa autora i liczba pobrań widoczne na obrazie są ilustracyjne i nie powinny być traktowane jako zweryfikowane dane katalogowe; użyj zweryfikowanego projektu Copilot, do którego link znajduje się w tym artykule.
Otwórz ustawienia Copilot i poszukaj obszaru konfiguracji modelu, obecnie zorganizowanego pod ustawieniami Models. Dodaj niestandardowy model czatu z następującymi wartościami:
- Dostawca: Ollama.
- Model: dokładna nazwa modelu lokalnego zgłoszona przez
ollama ls.
- Adres bazowy (Base URL):
http://localhost:11434.
- Klucz API: Ollama sama w sobie nie wymaga klucza dla dostępu localhost. Jeśli pole wtyczki wymaga wartości zastępczej, postępuj zgodnie z aktualnymi instrukcjami tej wtyczki, zamiast wymyślać klucz chmurowy.
Istnieje łatwy błąd w adresie URL, którego należy unikać. Gdy testujesz Ollama ręcznie, punkty końcowe API wyglądają jak http://localhost:11434/api/chat. Natywny dostawca Ollama w Copilot oczekuje jednak adresu bazowego serwera i konstruuje punkt końcowy wewnętrznie, więc użyj http://localhost:11434, chyba że aktualna wtyczka wyraźnie prosi o pełny punkt końcowy. Podobnie, nie dodawaj /v1 podczas korzystania z natywnego dostawcy Ollama. Osobne API zgodne z OpenAI w Ollama używa /v1, ale jest to inna ścieżka integracji.
Krok 3: Przetestuj osadzenie na poziomie notatki przed indeksowaniem całego sejfu
Nie zaczynaj od indeksowania tysięcy notatek. Najpierw udowodnij, że podstawowe połączenie czatu działa w małym, kontrolowanym teście. Utwórz tymczasową notatkę zawierającą trzy łatwe do zweryfikowania fakty, takie jak nazwa projektu, termin i decyzja. Następnie dołącz lub wspomnij tę notatkę w Copilot i poproś model o podsumowanie tylko tego, co mówi notatka.
Dobry wynik powinien dokładnie odtworzyć te fakty, unikać dodawania niepotwierdzonych twierdzeń i pozostać w zakresie, który zasugerowałeś. Zły wynik może odpowiadać z wiedzy ogólnej, ignorując notatkę, wymyślać szczegóły lub pomijać ważny fakt, który jest wyraźnie obecny.
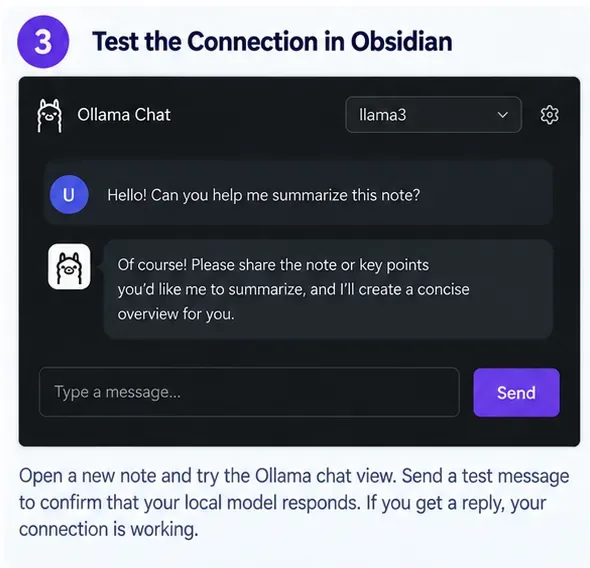
Koncepcyjna ilustracja wygenerowana przez AI przedstawiająca test lokalnego czatu w Obsidian. Demonstruje ona rodzaj wyniku do sprawdzenia, a nie rzeczywisty zrzut ekranu konkretnej wersji wtyczki.
Jeśli nie ma odpowiedzi, rozwiąż problemy od dołu do góry. Najpierw ponownie uruchom curl http://localhost:11434/api/tags. Jeśli to zawiedzie, problemem jest Ollama, a nie Obsidian. Jeśli API działa, ale Copilot nie, ponownie sprawdź nazwę modelu i adres bazowy. Dopiero po tych kontrolach powinieneś zbadać problem z pochodzeniem/CORS. Aktualny kod Copilot zawiera ścieżkę żądania przeznaczoną do obsługi lokalnego dostępu Ollama, podczas gdy jego przewodnik konfiguracji lokalnej dokumentuje również OLLAMA_ORIGINS dla konfiguracji wymagających bezpośredniego dostępu z pochodzenia Obsidian. Użyj metody udokumentowanej dla zainstalowanej wersji Copilot, zamiast automatycznie stosować stare obejścia zmiennych środowiskowych.
Krok 4: Dodaj wyszukiwanie świadome sejfu tylko, jeśli czat na poziomie notatki przejdzie test
W przypadku osobistego zarządzania wiedzą największa poprawa jakości często pochodzi z wyszukiwania, a nie z przejścia na większy model czatu. RAG oznacza, że system najpierw pobiera fragmenty Twoich notatek, które wydają się istotne, a następnie podaje te fragmenty modelowi językowemu jako kontekst. Pozwala to lokalnemu modelowi odpowiadać na pytania dotyczące informacji, na których nigdy nie był trenowany.
Aby wyszukiwanie również było lokalne, użyj modelu osadzającego Ollama. Aktualna dokumentacja Ollama zaleca modele takie jak embeddinggemma, qwen3-embedding i all-minilm. Na przykład:
ollama pull embeddinggemma
Skonfiguruj ten model w ustawieniach wyszukiwania sejfu lub osadzania QA w Copilot, używając dostawcy Ollama, a następnie zbuduj lub przebuduj lokalny indeks. Używaj tego samego modelu osadzającego do indeksowania i zapytań; Ollama wyraźnie to zaleca, ponieważ wektory wyprodukowane przez różne modele nie są bezpośrednio wymienne.

Koncepcyjna ilustracja wygenerowana przez AI przedstawiająca przepływ pracy z notatkami napędzany przez Ollama. Nazwy poleceń i układ menu są przykładami, a nie twierdzeniem dotyczącym dokładnego interfejsu użytkownika aktualnej wersji Copilot.
Gdy indeksowanie się zakończy, przetestuj wyszukiwanie pytaniami, na które znasz już odpowiedzi. Poproś o fakt, który pojawia się w jednej notatce, a następnie o relację wymagającą dwóch notatek. Na koniec poproś o coś, czego nie ma w sejfie. Najlepszym wynikiem nie jest najbardziej płynna odpowiedź; jest to ta, która wykorzystuje właściwe dowody i odmawia wymyślania brakujących faktów.
Jak ocenić, czy wynik jest wystarczająco dobry
| Kontrola jakości | Sygnał sukcesu | Kiedy zmienić podejście |
|---|
| Połączenie lokalne | /api/tags działa i ten sam model odpowiada w Obsidian | Jeśli curl zawiedzie, napraw najpierw Ollama; jeśli tylko Obsidian zawiedzie, sprawdź ustawienia modelu/URL wtyczki |
| Osadzenie w notatce | Znane fakty z dołączonej notatki są odtwarzane dokładnie | Jeśli czat ignoruje notatkę, napraw wybór kontekstu przed zmianą modeli |
| Wyszukiwanie w sejfie | Istotne notatki są konsekwentnie wyświetlane dla pytań o znane odpowiedzi | Jeśli wyszukiwanie jest słabe, ulepsz osadzanie/indeksowanie lub zawęź zakres indeksowania |
| Jakość generowania | Model oddziela potwierdzone fakty od niepewności | Jeśli wyszukiwanie jest dobre, ale odpowiedzi są słabe, spróbuj silniejszego modelu czatu |
| Opóźnienie | Możesz interagować bez powtarzających się długich przestojów | Jeśli Ollama jest głównie ograniczona przez CPU lub pamięć, użyj mniejszego modelu lub mniej kontekstu |
| Prywatność | Skonfigurowany punkt końcowy to localhost, a opcjonalne funkcje chmurowe/sieciowe są wyłączone | Jeśli aktywny jest zdalny punkt końcowy lub narzędzie sieciowe, przepływ pracy nie jest już w pełni lokalny |
Kiedy większy model nie jest właściwym rozwiązaniem
Jeśli odpowiedzi są błędne, ponieważ system pobiera niewłaściwe notatki, aktualizacja modelu czatu może poprawić styl prozy, nie naprawiając dowodów. Najpierw ulepsz wyszukiwanie. Odwrotnie, jeśli właściwe fragmenty są pobierane, ale model nie potrafi ich wiarygodnie zsyntetyzować, wtedy lepszy model czatu może pomóc.
Sprzęt również wyznacza praktyczny sufit. Ollama zauważa, że pliki modeli mogą zajmować znaczną ilość pamięci, a większe konteksty zużywają więcej pamięci. Użyj ollama ps, aby zobaczyć, jak aktualny model jest ładowany. Przepływ pracy, który technicznie działa, ale trwa tak długo, że przestajesz z niego korzystać, nie jest udanym systemem PKM.
Ograniczenia prywatności i bezpieczeństwa „lokalnego” AI w Obsidian
API localhost Ollama samo w sobie nie wymaga uwierzytelniania, co jest wygodne na jednym komputerze, ale oznacza również, że nie należy przypadkowo udostępniać portu 11434 w sieci. Trzymaj go związanego lokalnie, chyba że celowo zabezpieczasz konfigurację zdalną.
Pamiętaj również, że „Ollama jest lokalna” nie oznacza automatycznie, że „cały przepływ pracy Obsidian jest offline”. Wtyczki społecznościowe mogą zawierać integracje z dostawcami chmurowymi, wyszukiwanie w sieci, telemetrię lub narzędzia agentowe. Przejrzyj aktualne ustawienia wtyczki i wyłącz funkcje, których nie zamierzasz używać. Jeśli Twoim celem jest ścisłe przetwarzanie offline, przetestuj z odłączoną siecią po zainstalowaniu wszystkich modeli i wtyczek.
Ostateczna autokontrola
Twoja konfiguracja jest gotowa do codziennego osobistego zarządzania wiedzą, gdy wszystkie poniższe stwierdzenia są prawdziwe: API Ollama odpowiada lokalnie; Obsidian używa dokładnie tego modelu lokalnego, który zamierzałeś; kontrolowany test notatki zwraca poprawne fakty; wyszukiwanie w sejfie znajduje właściwe notatki dla pytań o znane odpowiedzi; niepotwierdzone pytania nie wywołują pewnej fabrykacji; a wydajność jest wystarczająco szybka, że faktycznie będziesz korzystać z tego przepływu pracy.
Jeśli tylko pierwsze dwa stwierdzenia są prawdziwe, pomyślnie połączyłeś Ollama z Obsidian, ale nie masz jeszcze niezawodnego asystenta zarządzania wiedzą. Traktuj jakość wyszukiwania, zachowanie modelu i konfigurację prywatności jako oddzielne części systemu i zmieniaj tę część, która faktycznie zawodzi.









