Strona główna
» Domeny
»
Jak stworzyć zautomatyzowanego agenta przetwarzania faktur przy użyciu sztucznej inteligencji typu open source
Jak stworzyć zautomatyzowanego agenta przetwarzania faktur przy użyciu sztucznej inteligencji typu open source
Zautomatyzowany agent przetwarzający faktury nie musi zaczynać od dużego, autonomicznego systemu AI. W pierwszej, użytecznej wersji, agenta można sobie wyobrazić jako kontrolowany obieg pracy, który otrzymuje fakturę, wywołuje odpowiedni dokument i uruchamia narzędzia AI, weryfikuje wynik, decyduje, czy człowiek powinien go przejrzeć, a dopiero potem zapisuje lub eksportuje zatwierdzone dane.
To rozróżnienie ma znaczenie w finansach. Model językowy może pomóc przekształcić chaotyczne układy faktur w pola strukturalne, ale nie powinien być jedynym czynnikiem decydującym o tym, czy faktura jest prawidłowa i bezpieczna do zaksięgowania. Przyjazny dla początkujących projekt tego przewodnika sprawia, że ekstrakcja danych ma charakter probabilistyczny, a ważne kontrole księgowe są deterministyczne.
Na koniec otrzymasz lokalny prototyp, który akceptuje faktury w formacie PDF lub obrazy, wyodrębnia pola takie jak dostawca, numer faktury, daty, waluta, sumy i pozycje zamówienia, weryfikuje te pola pod kątem reguł, kieruje wątpliwe dokumenty do przeglądu, przechowuje ślad audytu i udostępnia proces za pomocą interfejsu API.
Co musisz wiedzieć zanim zaczniesz?
Warto znać cztery terminy:
OCR (optyczne rozpoznawanie znaków) zamienia tekst widoczny na obrazie lub skanie na tekst czytelny dla maszyny.
Analiza składniowa dokumentu pozwala zachować więcej struktury niż zwykłe OCR, np. kolejność czytania, tabele, nagłówki i obszary układu.
LLM (model dużego języka) może mapować zmienny tekst faktury na spójną strukturę JSON.
W przypadku systemu z udziałem człowieka system zatrzymuje się i prosi osobę o sprawdzenie przypadków, które nie przeszły kontroli, zamiast udawać, że każdy wynik jest poprawny.
Od września 2026 roku kilka aktywnie utrzymywanych projektów open source obejmuje te warstwy. Docling obsługuje formaty PDF, obrazy, dokumenty biurowe i inne formaty dokumentów; PaddleOCR zapewnia funkcje OCR i interpretowania dokumentów i jest udostępniany na platformie Apache 2.0; a projekt Tesseract dokumentuje swoją obecną linię 5.x jako silnik OCR open source w oficjalnym podręczniku Tesseract .
W przypadku wnioskowania z modelu lokalnego, dokumentacja serwera llama.cpp opisuje punkty końcowe zgodne z OpenAI oraz dane wyjściowe JSON z ograniczeniami schematu. To sprawia, że jest to przydatne dla usługi ekstrakcji, ponieważ można poprosić lokalnie hostowany model o zwrócenie zdefiniowanego obiektu zamiast nieograniczonej prozy.
Ważne jest jedno ostrzeżenie dotyczące licencji: silnik wnioskowania open source nie oznacza automatycznie, że każdy model ma status open source. Sprawdź licencję dla konkretnego punktu kontrolnego modelu, który wdrażasz, szczególnie w przypadku zastosowań komercyjnych.
Którego stosu powinien używać początkujący?
Warstwa
Praktyczny wybór
Dlaczego tu jest
Konwersja dokumentów
Docling
Konwertuje pliki PDF i obrazy na ustrukturyzowaną reprezentację dokumentu i eksportowalny tekst.
Zapasowy OCR
PaddleOCR lub Tesseract
Przydatne, gdy faktura jest skanem lub zdjęciem i wyodrębnienie tekstu wymaga OCR.
Lokalna ekstrakcja AI
llama.cpp + odpowiedni model instrukcji
Mapuje zmienny tekst faktury do stabilnego schematu JSON, zachowując przy tym lokalne wnioskowanie.
Walidacja schematu
Pydantyczny
Sprawdza poprawność danych Pythona pod kątem zadeklarowanych typów pól i ograniczeń.
API
Szybkie API
Akceptuje przesyłanie faktur i zwraca wyniki przetwarzania.
Składowanie
SQLite dla prototypu; PostgreSQL dla usługi współdzielonej
Przechowuje znormalizowane dane, status przeglądu, tożsamość pliku źródłowego i zdarzenia audytu.
Orkiestracja
Najpierw zwykły Python, później opcjonalny LangGraph
Funkcja deterministyczna jest łatwiejsza do debugowania. Dodaj strukturę agenta stanowego, gdy rozgałęzianie i weryfikacja przez człowieka stają się bardziej złożone.
Oficjalna dokumentacja Pydantic wyjaśnia, że modele dziedziczą po BaseModel, walidują dane przychodzące i mogą emitować schemat JSON poprzez model_json_schema(). Zobacz Walidacja modelu Pydantic . Jeśli później będziesz potrzebować trwałego, stanowego rozgałęzienia, dokumentacja LangGraph opisuje obsługę długotrwałych agentów stanowych, trwałości i przepływów pracy z udziałem człowieka.
Krok 1: Skonfiguruj projekt i określ wąski pierwszy cel
Nie zaczynaj od „automatyzacji należności”. Zacznij od jednej klasy dokumentów i jednej umowy wyjściowej. Dobry MVP to: faktury od dostawców w języku angielskim, format PDF lub obraz, jedna jednostka prawna, jeden zestaw walut i brak automatycznego rozliczania płatności.
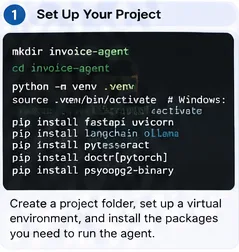
Zainstaluj moduł OCR osobno, jeśli go potrzebujesz. Aktualna instrukcja instalacji Doclinga korzysta z pip install docling; Aktualna dokumentacja instalacji PaddleOCR odróżnia podstawowy pakiet OCR od opcjonalnych grup zależności parsowania dokumentów i ekstrakcji informacji. Skorzystaj z instrukcji instalacji Doclinga lub instrukcji instalacji PaddleOCR 3.x zamiast kopiować starą listę zależności.
Krok 1: Najpierw utwórz mały, odizolowany projekt w Pythonie. Typ pierwszej faktury i schemat wyjściowy powinny być na tyle wąskie, aby umożliwić dokładne przetestowanie.
Krok 2: Konwersja faktur na dane tekstowe i układowe
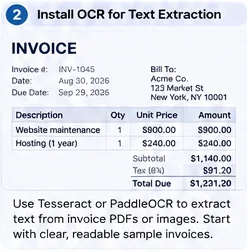
Pliki PDF w wersji cyfrowej mogą już zawierać użyteczny tekst. Zeskanowane pliki PDF i zdjęcia wymagają funkcji OCR. Twój parser powinien ukryć tę różnicę przed resztą procesu: późniejsze etapy powinny otrzymać znormalizowany tekst dokumentu oraz wszelkie przydatne informacje o układzie lub tabelach.
Minimalna konwersja Doclinga wygląda następująco:
from docling.document_converter import DocumentConverter

converter = DocumentConverter()

def parse_document(path: str) -> str:
    result = converter.convert(path)
    return result.document.export_to_markdown()
Oficjalny przewodnik szybkiego startu Doclinga wykorzystuje ten sam schemat konwersji i eksportu. W przypadku kolekcji intensywnie korzystających z OCR, przetestuj PaddleOCR lub Tesseract na własnych skanach. Dokumentacja projektu PaddleOCR zaleca nowszą rodzinę PP-StructureV3 do analizy dokumentów, natomiast Tesseract można wywołać z wiersza poleceń lub interfejsu API w przypadku OCR tekstu drukowanego.
Krok 2: Zacznij od czytelnych przykładowych faktur zawierających pola, które chcesz wyodrębnić, a następnie dodaj bardziej szczegółowe skany dopiero po zakończeniu podstawowego procesu.
Krok 3: Określ dokładnie, jakie dane agent może wygenerować
Schemat ekstrakcji to umowa między sztuczną inteligencją a logiką księgową. Unikaj rozbudowanego schematu „wszystko, co może pojawić się na fakturze”. Zacznij od pól, które można zwalidować.
from datetime import date
from decimal import Decimal
from pydantic import BaseModel, Field, ConfigDict

class LineItem(BaseModel):
    description: str
    quantity: Decimal | None = None
    unit_price: Decimal | None = None
    amount: Decimal

class Invoice(BaseModel):
    model_config = ConfigDict(extra="forbid")

    vendor_name: str
    invoice_number: str
    invoice_date: date
    due_date: date | None = None
    currency: str = Field(min_length=3, max_length=3)
    subtotal: Decimal | None = None
    tax: Decimal | None = None
    total: Decimal
    line_items: list[LineItem] = []
extra="forbid"jest przydatny w tym kontekście, ponieważ nieoczekiwane pola LLM nie powinny bezpowrotnie stać się częścią dokumentacji księgowej. Należy również pamiętać, że walidacja Pydantic potwierdza strukturę i typy, ale nie dowodzi , że wyodrębniony dostawca lub kwota odpowiadają obrazowi faktury.
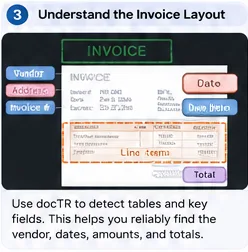
Krok 3: Zdefiniuj pola docelowe zgodnie z potrzebami biznesowymi, a następnie wykorzystaj informacje o układzie i tabeli, aby zachować źródło tych wartości.
Krok 4: Użyj modelu lokalnego, aby odwzorować tekst dokumentu na ustrukturyzowany kod JSON
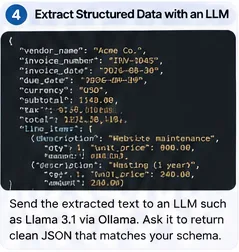
Uruchom odpowiedni model instrukcji za serwerem HTTP llama.cpp. Dokładny rozmiar modelu zależy od sprzętu i złożoności faktury. Nie zakładaj, że większy model jest automatycznie lepszy; przeprowadź testy dokładności pola, opóźnień i pamięci na własnym zestawie faktur.
llama.cpp obsługuje obecnie odpowiedzi JSON z ograniczeniami schematu. Możesz wygenerować ten schemat z Pydantic i przesłać go wraz z żądaniem ekstrakcji:
import json
import httpx

def extract_invoice(document_text: str) -> Invoice:
    schema = Invoice.model_json_schema()

    prompt = f"""
Extract one supplier invoice from the text below.
Do not invent values. If an optional field is absent, use null.
Currency must be a three-letter code.
Return only data that fits the required schema.

DOCUMENT:
{document_text}
"""

    payload = {
        "model": "local-model",
        "messages": [{"role": "user", "content": prompt}],
        "temperature": 0,
        "response_format": {
            "type": "json_schema",
            "schema": schema
        }
    }

    r = httpx.post(
        "http://127.0.0.1:8080/v1/chat/completions",
        json=payload,
        timeout=120
    )
    r.raise_for_status()

    content = r.json()["choices"][0]["message"]["content"]
    return Invoice.model_validate_json(content)
Generowanie z ograniczeniami schematu pomaga w uzyskaniu poprawnej struktury, ale nie gwarantuje poprawności semantycznej. W pełni poprawny obiekt JSON może nadal zawierać nieprawidłową sumę. Dlatego następny krok jest obowiązkowy.
Krok 4: Zapytaj model lokalny o ściśle ustrukturyzowany obiekt, a nie o tekst swobodny, aby walidacja w dalszej części strumienia otrzymywała przewidywalne pola.
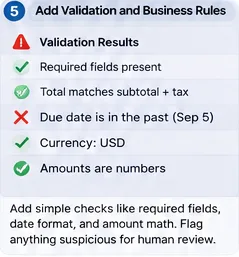
Krok 5: Dodaj deterministyczne kontrole księgowe i reguły przeglądu
Nie pytaj LLM: „Czy jesteś pewny?” i zaufaj odpowiedzi. Samodzielnie zgłoszona pewność modelu nie jest skalibrowaną kontrolą. Stwórz kontrole, które można ponownie obliczyć na podstawie wyodrębnionych danych i Twoich systemów.
Przydatne pierwsze zasady obejmują:
wymagane pola są obecne;
numer faktury nie jest już zarejestrowany dla tego samego dostawcy;
waluta jest dozwolona dla danego sprzedawcy lub podmiotu;
kwoty pozycji budżetowych w przybliżeniu sumują się do sum częściowych;
suma częściowa plus podatek jest w przybliżeniu równa sumie całkowitej;
data wystawienia faktury i termin płatności są wiarygodne;
dostawca jest obecny w Twojej głównej bazie dostawców lub został skierowany do wdrożenia;
odniesienia do zamówień zakupu są zgodne, gdy wymagane jest dopasowanie zamówień zakupu.
from decimal import Decimal

def validate_business_rules(inv: Invoice) -> list[str]:
    errors = []

    if inv.subtotal is not None and inv.tax is not None:
        expected = inv.subtotal + inv.tax
        if abs(expected - inv.total) > Decimal("0.02"):
            errors.append("subtotal_plus_tax_does_not_match_total")

    line_sum = sum((x.amount for x in inv.line_items), Decimal("0"))
    if inv.subtotal is not None and abs(line_sum - inv.subtotal) > Decimal("0.02"):
        errors.append("line_items_do_not_match_subtotal")

    if inv.due_date and inv.due_date < inv.invoice_date:
        errors.append("due_date_before_invoice_date")

    return errors
Przekieruj każdą nieudaną kontrolę do kolejki weryfikacji. Przy pierwszym wdrożeniu, rozsądne jest skierowanie wszystkich faktur do weryfikacji, podczas gdy będziesz mierzyć jakość ekstrakcji. Progi automatyzacji powinny pochodzić z dowodów zebranych na własnych, oznaczonych fakturach, a nie z ogólnego procentu skopiowanego z innego systemu.
Krok 5: Traktuj reguły arytmetyczne, wykrywania duplikatów, dopasowywania dostawców i dat jako kontrole deterministyczne; kieruj wyjątki do osoby.
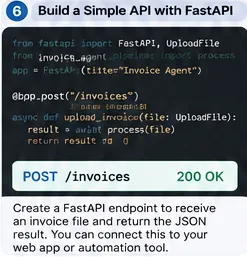
Krok 6: Owiń procesor w mały interfejs API
Interfejs API pozwala formularzowi przesyłania, pracownikowi poczty e-mail, monitorowi folderów współdzielonych lub integracji księgowej wywołać tę samą funkcję przetwarzania. Oficjalny przewodnik FastAPI dotyczący przesyłania plików zawiera zalecenia UploadFiledotyczące przesyłania plików i zaznacza, że korzysta on z pliku spooled, co jest lepszym rozwiązaniem niż ładowanie dużych plików w całości do pamięci.
from pathlib import Path
from tempfile import NamedTemporaryFile
from fastapi import FastAPI, UploadFile, HTTPException

app = FastAPI()

@app.post("/invoices")
async def process_upload(file: UploadFile):
    if file.content_type not in {
        "application/pdf",
        "image/png",
        "image/jpeg"
    }:
        raise HTTPException(415, "Unsupported file type")

    suffix = Path(file.filename or "").suffix

    with NamedTemporaryFile(suffix=suffix, delete=False) as tmp:
        tmp.write(await file.read())
        path = tmp.name

    result = process_invoice(path)
    return result
Zapoznaj się z aktualną dokumentacją pliku żądania FastAPI, aby poznać obsługiwane wzorce przesyłania. W środowisku produkcyjnym należy również egzekwować limity rozmiaru plików, skanować w poszukiwaniu złośliwego oprogramowania (jeśli to konieczne), uwierzytelniać osoby wywołujące, stosować identyfikatory żądań oraz bezpiecznie czyścić pliki tymczasowe.
Krok 6: Udostępnij jeden punkt końcowy przetwarzania po zakończeniu działania lokalnego potoku, aby wiele kanałów wejściowych mogło ponownie wykorzystać tę samą ścieżkę walidacji.
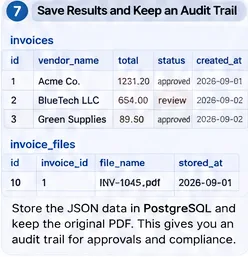
Krok 7: Przechowuj oryginalne dowody, znormalizowane wyniki i zdarzenia audytu
Nigdy nie przechowuj tylko końcowego pliku JSON. Zachowaj wystarczającą ilość dowodów, aby odtworzyć, co się wydarzyło: oryginalną tożsamość pliku, skrót, wersję parsera, identyfikator modelu, wersję monitu, wyodrębniony plik JSON, wyniki walidacji, decyzję o weryfikacji, znaczniki czasu oraz nazwę użytkownika lub usługi, która zatwierdziła zmianę.
Prosty prototyp może korzystać z SQLite. Usługa wielodostępna może korzystać z PostgreSQL z ograniczeniami unikalności i kluczy obcych. Aktualna dokumentacja PostgreSQL obejmuje ograniczenia tabel , które są przydatne do ochrony kluczy i relacji niezależnie od potoku sztucznej inteligencji.
CREATE TABLE invoices (
    id BIGSERIAL PRIMARY KEY,
    vendor_id BIGINT NOT NULL,
    invoice_number TEXT NOT NULL,
    invoice_date DATE NOT NULL,
    currency CHAR(3) NOT NULL,
    total NUMERIC(18,2) NOT NULL,
    status TEXT NOT NULL,
    source_sha256 TEXT NOT NULL,
    extracted_json JSONB NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    UNIQUE (vendor_id, invoice_number)
);
Skrót źródłowy to drugi sposób wykrywania przypadkowego ponownego przesłania. Utrzymuj bardziej rygorystyczne uprawnienia do przechowywania plików niż w przypadku ogólnych logów aplikacji, ponieważ faktury często zawierają adresy, dane bankowe, identyfikatory podatkowe i inne dane wrażliwe dla firmy.
Krok 7: Zachowaj znormalizowane dane faktury i metadane pliku źródłowego, aby zatwierdzenia, duplikaty i późniejsze korekty pozostały możliwe do zweryfikowania.
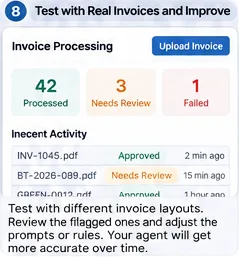
Krok 8: Przetestuj przy użyciu rzeczywistych zmian faktury przed automatyzacją dalszych działań
Prototyp działający na pięciu czystych plikach PDF nie jest gotowy do produkcji. Zbuduj zestaw ewaluacyjny z etykietami, który będzie odzwierciedlał faktycznie otrzymane dane wejściowe: różnych dostawców, skany, obrócone strony, małe czcionki, faktury wielostronicowe, rabaty, ujemne pozycje, podatki, koszty wysyłki, wiele walut, brakujące zamówienia zakupu i zduplikowane zgłoszenia.
Śledź metryki na poziomie pola osobno. „Dokładność faktury” może ukryć fakt, że nazwa dostawcy jest łatwa do zidentyfikowania, a ilość pozycji zamówienia jest zawodna. Przynajmniej zmierz:
dokładność dokładnego dopasowania numeru faktury, waluty i dat;
dokładność tolerancji liczbowej dla sumy częściowej, podatku i całości;
precyzja pozycji zamówienia i możliwość odwołania się do nich, jeśli pozycje zamówienia mają znaczenie w dalszej części łańcucha dostaw;
procent przekazany do przeglądu przez człowieka;
wskaźnik fałszywych automatycznych zatwierdzeń;
opóźnienie przetwarzania i wskaźnik awaryjności;
precyzja wykrywania duplikatów.
Przechowuj błędy jako przypadki testowe. Za każdym razem, gdy naprawiasz regułę parsera, monit, schemat lub model, ponownie uruchom cały zestaw ewaluacyjny. Zapobiega to sytuacji, w której udoskonalenie jednego dostawcy dyskretnie zepsuje układ innego dostawcy.
Krok 8: Zmierz kolejkę przeglądów i przypadki błędów na reprezentatywnych fakturach, zanim pozwolisz agentowi na zautomatyzowanie dalszych działań księgowych.
Jak agent powinien zdecydować, co stanie się dalej?
Zachowaj jawność maszyny stanowej. „Agent” może na początku być zwykłą funkcją Pythona:
Działa to już w sposób agentowy, ponieważ koordynuje narzędzia i wybiera gałąź. Nie potrzebujesz LLM do wybierania każdego kolejnego kroku. Dodaj LangGraph lub inny framework orkiestracji, gdy potrzebujesz trwałych, wieloetapowych przeglądów, ponownych prób, asynchronicznych wywołań zwrotnych lub kilku wyspecjalizowanych narzędzi, których kolejność wykonywania zmienia się w zależności od przypadku.
Jakich błędów powinni unikać początkujący?
Umożliwienie LLM pełnienia funkcji kontroli księgowej
Model powinien być ekstrahowany i normalizowany; kod i zaufane dane systemowe powinny być weryfikowane. Arytmetyka, sprawdzanie duplikatów, status dostawcy, dopasowywanie zamówień i limity akceptacji należą do logiki deterministycznej.
Usuwanie dokumentu źródłowego po ekstrakcji
Zachowaj oryginalną fakturę lub kontrolowane odwołanie do niej. Recenzenci potrzebują dowodów, a Ty potrzebujesz sposobu na odtworzenie błędów po aktualizacji modelu lub parsera.
Korzystanie z jednego monitu bez wersji
Przechowuj wersję monitu i identyfikator modelu dla każdej przetworzonej faktury. W przeciwnym razie nie będziesz w stanie wyjaśnić, dlaczego dwie faktury przetworzone w odstępie kilku miesięcy zachowywały się inaczej.
Automatyczne publikowanie każdego wyniku zgodnego ze schematem
Ważność JSON-a to nie to samo, co ważność faktury. Zacznij od weryfikacji przez człowieka, a następnie automatyzuj tylko przypadki niskiego ryzyka, gdy ocena wykaże akceptowalną wydajność.
Ignorowanie licencji modelu i danych
Biblioteki i wagi modeli mogą mieć różne licencje. PaddleOCR i Tesseract publikują licencje open source, natomiast licencja modelu uruchamianego za pośrednictwem llama.cpp zależy od konkretnego punktu kontrolnego. Potwierdź to przed wdrożeniem.
Tworzenie interfejsu użytkownika przed sprawdzeniem jakości ekstrakcji
Dopracowany panel nie zrekompensuje nieprawidłowych kwot. Najpierw przetestuj parsowanie dokumentu, ekstrakcję schematu i walidację; dodaj interfejs recenzji, gdy już będziesz wiedzieć, co recenzenci faktycznie chcą zobaczyć.
Kiedy należy stosować wyłącznie OCR, modele układu, a kiedy LLM?
Zbliżać się
Najlepiej pasuje
Główne ograniczenie
OCR + zasady
Niewielka liczba bardzo stabilnych szablonów dostawców
Zasady stają się kruche, gdy układy ulegają zmianom.
Model układu dokumentu
Tabele, formularze i pola, w których pozycja ma znaczenie
Może wymagać przeszkolenia w zakresie konkretnego zadania lub przetwarzania końcowego.
OCR/parser dokumentów + lokalny LLM
Wiele formatów faktur ze wspólnym schematem docelowym
Musi zostać ograniczony i zweryfikowany; wnioskowanie wymaga większych obliczeń.
Model wizyjno-językowy
Złożone dokumenty, w których tekst i układ wizualny są ściśle powiązane
Wyższe wymagania sprzętowe i dodatkowa złożoność oceny.
Aktualna dokumentacja LayoutLMv3 firmy Hugging Face opisuje model Document-AI, który łączy tekst i wizualne informacje o układzie. Dokumentacja PP-StructureV3 firmy PaddleOCR również koncentruje się na układzie, tabelach i analizie ustrukturyzowanego dokumentu. Są to opcje, gdy zwykły tekst i LLM nie wystarczą.
Jaka jest sensowna ścieżka od prototypu do produkcji?
Działaj etapami. Najpierw uruchom lokalnie folder z oznaczonymi fakturami. Po drugie, dodaj API i pamięć masową. Po trzecie, wprowadź kolejkę weryfikacji przez człowieka. Po czwarte, zintegruj wyszukiwania tylko do odczytu, takie jak dane główne dostawcy lub zamówienia zakupu. Po piąte, zezwól na kontrolowany eksport do obszaru przejściowego księgowości. Dopiero po potwierdzeniu kontroli przez monitoring, rozważ automatyczne księgowanie w ściśle określonych przypadkach niskiego ryzyka.
Na każdym etapie należy zachować trzy rzeczy: dowody (oryginalny dokument i wyodrębnione źródło), determinizm (reguły biznesowe, które można uruchomić ponownie) i możliwość śledzenia (który parser, model, monit i recenzent wygenerowali ostateczny rekord).
Ostateczna lista kontrolna
Analizator faktur działa zarówno z plikami PDF w formie cyfrowej, jak i ze skanami, które faktycznie otrzymujesz.
Dane wyjściowe ekstrakcji są ograniczone do wersjonowanego schematu Pydantic.
Model nie jest uprawniony do wymyślania brakujących wartości.
Sumy, daty, duplikaty, tożsamość dostawcy i zasady zamówień są sprawdzane poza LLM.
Niespełnienie reguł skutkuje stanem przeglądu przez człowieka zamiast cichej korekty.
Rejestrowane są oryginalny dokument, skrót źródłowy, model, wersja monitu i wynik walidacji.
Interfejs API ogranicza typ i rozmiar pliku oraz podlega uwierzytelnianiu przed użyciem w środowisku produkcyjnym.
Twój zestaw testowy zawiera rzeczywiste wariacje układu i przypadki skrajne.
Sprawdzono licencje modeli i bibliotek pod kątem planowanego wdrożenia.
Zapisy w księgowości downstream są wprowadzane stopniowo i podlegają audytowi.
Jeśli te mechanizmy kontroli są wdrożone, masz coś więcej niż tylko demo OCR: masz fundament niezawodnego agenta do przetwarzania faktur. Komponenty open source mogą się zmieniać z czasem, ale architektura pozostaje trwała – analizuj dowody, wyodrębniaj do schematu, weryfikuj za pomocą kodu, przekazuj niepewność ludziom i rejestruj każdą decyzję.