Strona główna
» Domeny
»
Jak tworzyć niestandardowe GPT, które nie zapominają o plikach wiedzy
Jak tworzyć niestandardowe GPT, które nie zapominają o plikach wiedzy
Aktualny stan, sprawdzono 13 września 2026 r.: OpenAI informuje, że osobiste konta ChatGPT, w tym Free, Go, Plus i Pro, nie mogą tworzyć ani publikować nowych GPT. Istniejące GPT nadal mogą być używane i, jeśli to możliwe, edytowane. W przestrzeniach roboczych Business, Enterprise i Edu tworzenie zależy od ustawień i uprawnień przestrzeni roboczej. OpenAI informuje również, że niestandardowe przepływy pracy GPT są przenoszone do wtyczek, a migracja planowana jest na 17 września 2026 r., a wycofanie tych GPT dla przedsiębiorstw planowane jest na 11 grudnia 2026 r. Jeśli czytasz to później, sprawdź najnowszy stan w dokumentacji OpenAI dotyczącej tworzenia i edytowania GPT przed utworzeniem nowego przepływu pracy.
Niestandardowy GPT, który wydaje się „zapominać” o pliku wiedzy, zazwyczaj go nie utracił. W FAQ OpenAI dotyczącym przesyłania plików podano, że pliki przesłane jako wiedza GPT są zachowywane do momentu usunięcia niestandardowego GPT. Częstszym problemem jest pobieranie: model niekoniecznie odczytuje w całości każdy przesłany plik dla każdego pytania. Pobiera materiał, który wydaje się istotny dla pytania, więc jakość źródła, struktura pliku, instrukcje i testy wpływają na to, czy pojawi się właściwy fragment.
Należy również oddzielić „wiedzę” od „pamięci”. W dokumentacji ChatGPT (GPT) OpenAI czytamy, że GPT nie korzystają z zapisanej pamięci, osobistych instrukcji ani poprzednich konwersacji; każda konwersacja rozpoczyna się od nowa. Przesłana wiedza jest zatem skonfigurowanym źródłem odniesienia, a nie pamięcią konwersacyjną gromadzoną z poprzednich konwersacji.
Jak powinien wyglądać wiarygodny wynik
Celem nie jest zmuszanie GPT do wspominania o pliku za każdym razem. Celem jest zapewnienie, aby odpowiedzi zależne od źródła były konsekwentnie oparte na właściwym materiale, a jednocześnie aby pytania bez uzasadnienia kończyły się bezpieczną porażką, zamiast dawać pewne przypuszczenia.
Sygnał jakości
Jak wygląda „dobro”
Kiedy zmienić konfigurację
Poprawność
Odpowiedź jest zgodna z wiarygodnym plikiem dla danego pytania.
Jeżeli odpowiedź jest błędna, mimo że znany jest fakt, należy uprościć źródło lub zawęzić pytanie.
Grunt
GPT może podać nazwę pliku pomocniczego lub sekcji, gdy zostanie o to poproszony.
Jeżeli natomiast odpowiedź opiera się na wiedzy ogólnej, należy wzmocnić instrukcje o priorytecie źródła i przeprowadzić ponowny test.
Wstrzymanie się od głosu
Jeżeli pliki nie zawierają odpowiedzi, GPT wyraźnie to zaznacza.
Jeśli wymyśli politykę, cenę, datę lub procedurę, dodaj wyraźną zasadę, że nie wolno zgadywać.
Jeśli drobne zmiany w sformułowaniach powodują duże rozbieżności, należy zmniejszyć niejednoznaczność zarówno w plikach, jak i instrukcjach.
Aktualizacja integralności
Po przejrzeniu źródła te same pytania ewaluacyjne odzwierciedlają nową treść.
Jeśli nadal występują stare odpowiedzi, sprawdź, czy dołączono zaktualizowany plik, zapisz GPT i ponownie uruchom testy.
Osiem kroków, które uczynią korzystanie z plików wiedzy bardziej niezawodnym
1. Potwierdź, że Twoje konto lub obszar roboczy nadal może tworzyć lub edytować GPT
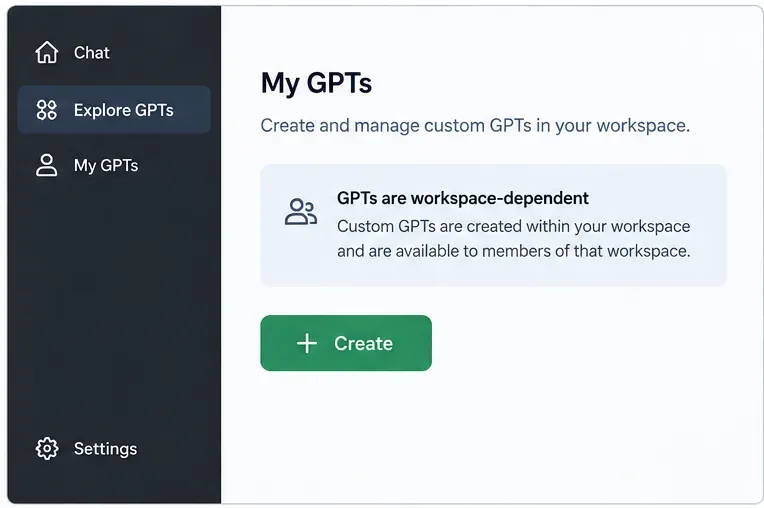
Zacznij od kwalifikowalności, ponieważ brak przycisku Utwórz może być teraz oczekiwanym zachowaniem, a nie problemem z przeglądarką. Aktualne wytyczne OpenAI dotyczące GPT w ChatGPT mówią, że tworzenie nowych GPT nie jest dostępne na kontach osobistych. Zarządzane obszary robocze nadal mogą udostępniać tworzenie GPT na podstawie polityki administratora i uprawnień roli. Jeśli posiadasz już istniejący GPT, sprawdź, czy edycja jest nadal dostępna na Twoim koncie.
W przypadku kwalifikujących się zarządzanych przestrzeni roboczych należy rozpocząć od obszaru GPT; dostępność zależy od uprawnień przestrzeni roboczej.
Nie trać czasu na rozwiązywanie problemów z odzyskiwaniem wiedzy, dopóki nie upewnisz się, że pracujesz w obsługiwanym edytorze. Jeśli Twoja organizacja już przechodzi na wtyczki, potraktuj pozostały niestandardowy GPT jako kandydata do migracji, a nie jako nową długoterminową zależność.
2. Oddziel instrukcje dotyczące zachowania od wiedzy
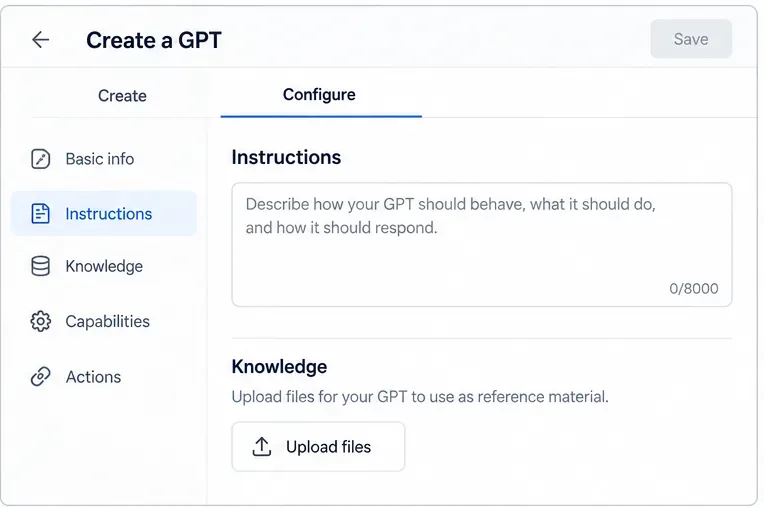
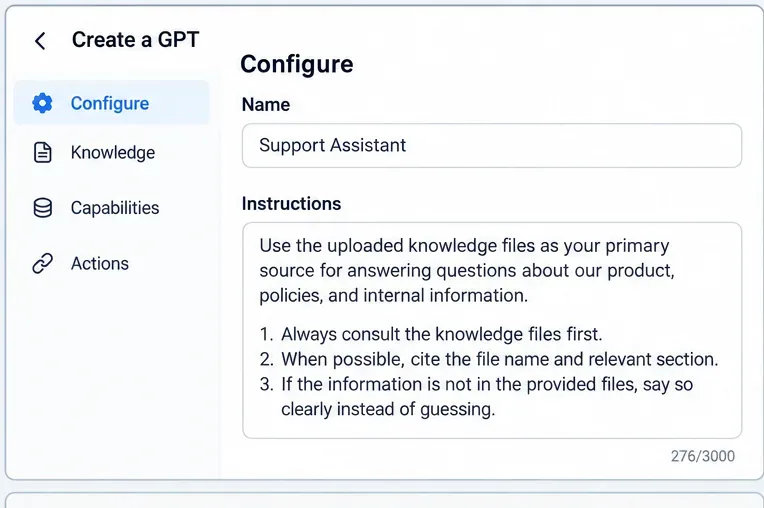
Użyj pola „Instrukcje” dla reguł takich jak ton, kolejność decyzji, format cytowania, zachowanie eskalacji oraz działania GPT w przypadku braku odpowiedzi ze źródła. Użyj pola „Wiedza” dla materiałów referencyjnych: podręczników, dokumentacji produktów, zasad, często zadawanych pytań, specyfikacji lub wewnętrznych przewodników. OpenAI wyraźnie zaleca takie rozdzielenie, ponieważ wiedza najlepiej sprawdza się jako materiał źródłowy, podczas gdy instrukcje definiują zachowanie.
Zachowaj zasady zachowania w Instrukcjach, a materiały referencyjne w Wiedzy.
To rozróżnienie ma znaczenie dla niezawodności. Zdanie takie jak „Nigdy nie podawaj przeterminowanej ceny” powinno znaleźć się w Instrukcji. Faktyczna tabela cen powinna znaleźć się w Wiedzy. Mieszanie reguł w dużym pliku PDF z odniesieniami utrudnia kontrolowanie i testowanie zachowania.
3. Przygotuj pliki do pobrania, a nie tylko do odczytu przez ludzi
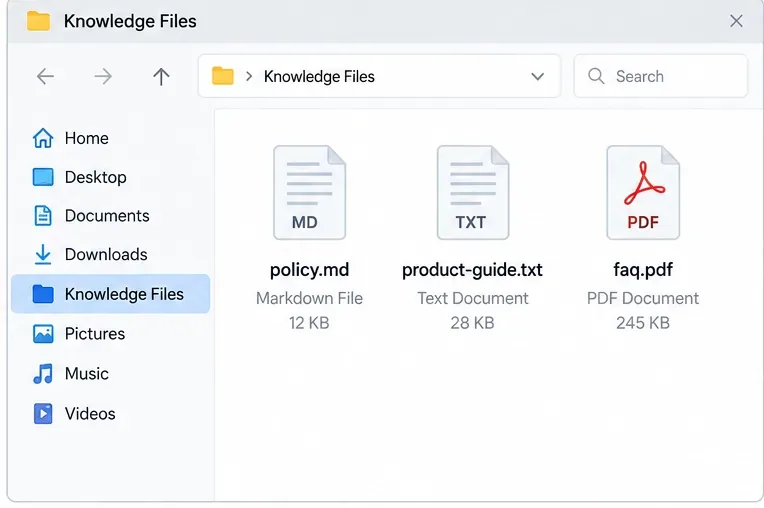
Preferuj przejrzyste pliki z tekstem, opisowymi nagłówkami, krótkimi sekcjami, stabilną terminologią i jednoznacznymi datami wydania. Pięknie zaprojektowana broszura może być gorsza niż zwykły plik Markdown lub tekstowy, jeśli kluczowe informacje są rozproszone w kolumnach, na etykietach, zrzutach ekranu lub w dekoracyjnych układach.
Pliki z tekstem do przodu, czytelnymi nazwami i prostą strukturą są łatwiejsze do niezawodnego pobrania.
Jest to szczególnie ważne w przypadku plików PDF. W FAQ OpenAI dotyczącym wizualnego wyszukiwania w plikach PDF podano, że pliki PDF przesłane jako GPT Knowledge są przetwarzane z wyszukiwaniem wyłącznie tekstowym. Innymi słowy, wykres, diagram lub zrzut ekranu w pliku PDF nie powinien być jedynym miejscem, w którym występuje krytyczna reguła. Dodaj tekstowe wyjaśnienie lub tekstowy plik towarzyszący.
Usuń również nieaktualne duplikaty. Jeśli w jednym pliku podano termin zwrotu wynoszący 14 dni, a w innym 30 dni, wyszukiwanie może ujawnić oba fragmenty. Nazwy plików, takie jak returns-policy-2026-09.md i widoczny tekst „data wejścia w życie”, ułatwiają weryfikację wersji.
4. Prześlij mały, spójny zbiór wiedzy i zweryfikuj go
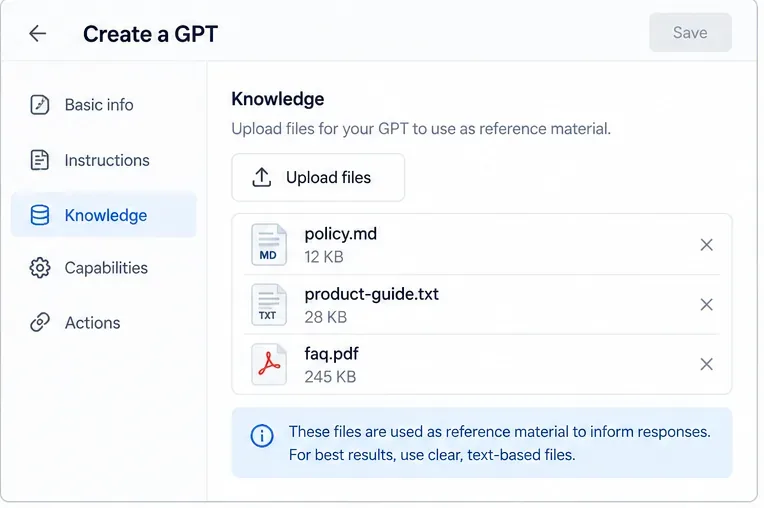
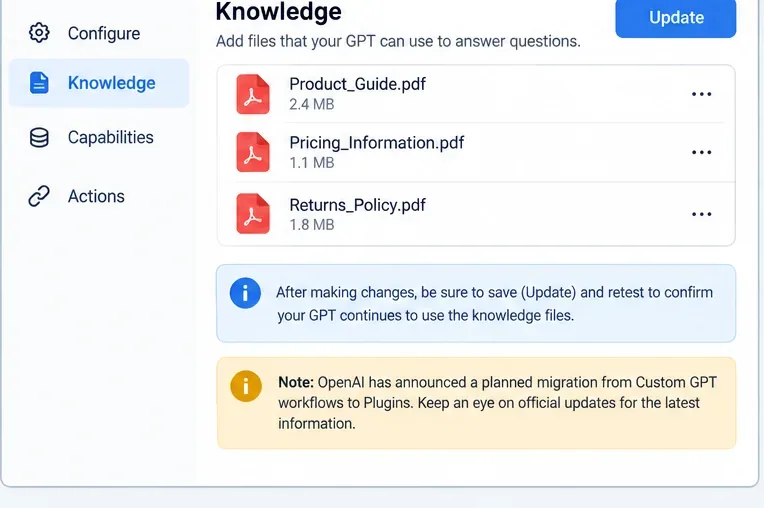
Prześlij tylko te pliki, których GPT faktycznie potrzebuje. Wskazówki OpenAI dotyczące plików korporacyjnych wskazują, że mniejsza liczba dokumentów, a bardziej szczegółowe, generalnie poprawia dokładność wyszukiwania opartego na plikach. Po przesłaniu sprawdź, czy każdy oczekiwany plik znajduje się na liście wiedzy, zanim przejdziesz dalej.
Prześlij zestaw referencyjny, a następnie przed testowaniem sprawdź, czy wszystkie oczekiwane pliki się pojawiają.
Obecnie występuje niespójność w dokumentacji dotyczącej liczby plików. Wskazówki edytora GPT mówią, że można dołączyć do GPT maksymalnie 20 plików, podczas gdy w FAQ dotyczącym przesyłania plików podano limit do 10 plików na GPT przez cały okres obowiązywania GPT. Oba dokumenty podają sztywny limit 512 MB na plik, a w FAQ dotyczącym przesyłania plików podano limit 2 milionów tokenów dla plików tekstowych i dokumentów. Ponieważ oficjalne strony nie są zgodne co do liczby plików, nie projektuj krytycznego przepływu pracy wokół wyższej liczby bez sprawdzenia aktualnego edytora i dokumentacji swojego konta.
5. Dodaj instrukcje zorientowane na wyszukiwanie
Nie opieraj się na niejasnych instrukcjach, takich jak „Użyj przesłanych plików”. Określ, co powinno się stać, gdy pytanie należy do dziedziny opartej na wiedzy. Praktyczny schemat postępowania jest następujący: najpierw zapoznaj się z przesłaną wiedzą; preferuj ją nad ogólną wiedzą modelową w przypadku faktów dotyczących konkretnej firmy; wskaż plik lub sekcję pomocniczą, gdy jest to praktyczne; i powiedz, że informacje są niedostępne, gdy pliki nie uzasadniają odpowiedzi.
Instrukcje zorientowane na wyszukiwanie powinny określać priorytet źródła, sposób cytowania i sposób powrotu do poprzedniego stanu bez zgadywania.
Wskazówki dotyczące rozwiązywania problemów OpenAI zalecają węższe monity, które odnoszą się bardziej bezpośrednio do załączonych dokumentów, gdy wiedza nie jest właściwie wykorzystywana. Zalecają również przechowywanie reguł i schematów działania przepływów pracy w instrukcjach, zamiast ukrywania ich w przesyłanych plikach. Zobacz Rozwiązywanie problemów z GPT .
Unikaj sprzecznych instrukcji. „Zawsze odpowiadaj użytkownikowi” kłóci się z „Nigdy nie odpowiadaj, chyba że plik to umożliwia”. Zastąp ten konflikt wyraźnym rozwiązaniem awaryjnym, takim jak: „Jeśli pliki wiedzy nie zawierają wymaganego faktu, zaznacz, że podane źródła nie potwierdzają odpowiedzi i zasugeruj zatwierdzony następny krok”.
6. Przeprowadź pozytywne testy uziemienia w wersji zapoznawczej
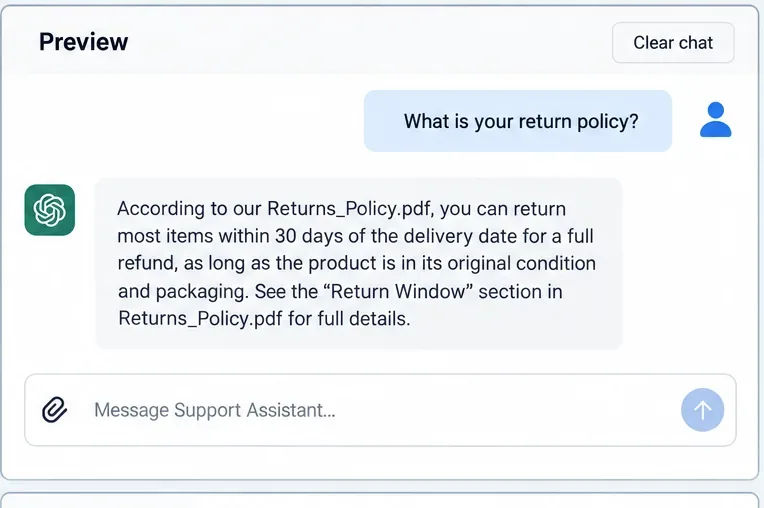
Pytania testowe, których poprawne odpowiedzi na pewno znajdują się w plikach. Nie sprawdzaj tylko najłatwiejszego zdania z pierwszej strony. Uwzględnij pytania wymagające przywoływania różnych sekcji, rozpoznawania alternatywnych sformułowań i rozróżniania podobnych zasad.
Pozytywny wynik testu daje poprawną odpowiedź i identyfikuje plik lub sekcję uzupełniającą.
Dla każdego testu zapisz oczekiwaną odpowiedź, oczekiwany plik źródłowy oraz informację, czy GPT zacytował lub zidentyfikował to źródło na żądanie. Niestandardowe wytyczne OpenAI Academy dotyczące GPT zalecają utworzenie zestawu ewaluacyjnego składającego się z około 10–15 reprezentatywnych pytań z poprawnymi odpowiedziami. Jest to wystarczająco duży zestaw, aby wykryć powtarzające się wzorce błędów bez przekształcania każdej edycji w duży projekt testowy.
Oceniaj wynik pod kątem tego, czy jest on obsługiwany, a nie tylko tego, czy brzmi płynnie. Dopracowana odpowiedź z niewłaściwą polityką to porażka. Krótsza odpowiedź, która dokładnie cytuje dokument kontrolny, jest zazwyczaj lepszym rezultatem.
7. Przeprowadź testy negatywne i przeformułuj testy
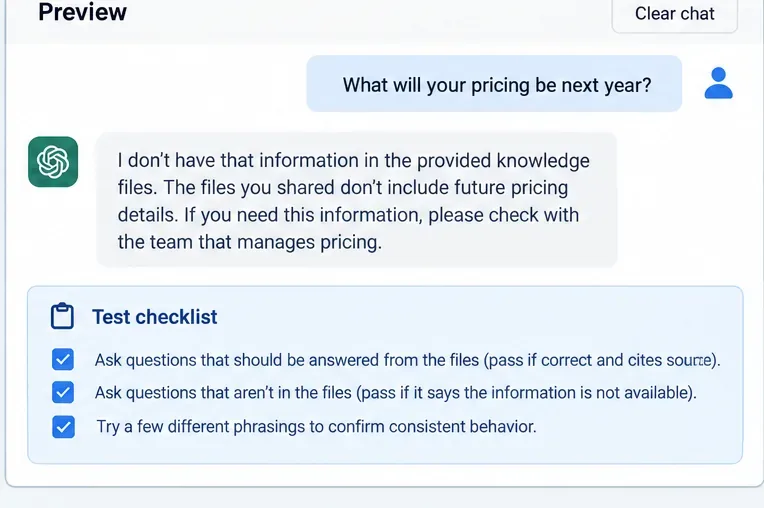
Niezawodny asystent wiedzy musi wiedzieć to, czego nie wie. Zadawaj pytania, których celowo brakuje w plikach: o przyszłą cenę, nieopublikowaną funkcję, politykę dla kraju nieobjętego podręcznikiem lub datę wykraczającą poza zakres dokumentu. Pożądanym rezultatem jest wyraźne ograniczenie, a nie wiarygodny wynalazek.
Negatywne testy mają znaczenie: GPT powinien przyznać, że odpowiedzi nie ma w plikach, i zachować spójność przy każdym sformułowaniu.
Następnie przeformułuj kilka pytań pozytywnych i negatywnych na kilka sposobów. Jeśli pytanie „Jaki jest okres zwrotu?” działa, ale pytanie „Jak długo mam na odesłanie?” nie działa, problem może dotyczyć zakresu odzyskiwania, a nie braku wiedzy. Popraw nagłówki, terminologię lub instrukcje przed dodaniem kolejnych plików.
8. Aktualizacje wersji, ponowne testy i wiedza, kiedy statyczna wiedza jest niewłaściwym narzędziem
Za każdym razem, gdy zmieniasz źródło, usuń przestarzałą wersję, dołącz aktualną, zapisz lub zaktualizuj GPT i ponownie uruchom ten sam zestaw ewaluacyjny. Prowadzenie niewielkiego dziennika zmian poza GPT może pomóc w ustaleniu, czy regresja wynikała z nowych instrukcji, zmienionego źródła, czy zmiany platformy.
Po zmianie plików źródłowych lub instrukcji zapisz aktualizację i uruchom ponownie ten sam zestaw ewaluacyjny.
Wiedza statyczna ma swoje ograniczenia. Jeśli źródło stale się zmienia, dostęp musi odzwierciedlać uprawnienia użytkownika lub asystent potrzebuje aktualnych danych operacyjnych, wielokrotne przesyłanie plików jest niepewne. Dokumentacja aplikacji OpenAI z synchronizacją opisuje indeksowane, połączone źródła, które są aktualizowane z poszanowaniem uprawnień źródłowych. OpenAI kieruje również niestandardowe przepływy pracy GPT w stronę wtyczek, więc często zmieniająca się baza wiedzy jest dobrym kandydatem do architektury połączonej lub migrowanej, a nie rosnącej ilości plików statycznych.
Jak zdiagnozować GPT, który nadal „zapomina” plik
Jeśli znany fakt zostanie pominięty, najpierw udowodnij, że fakt ten rzeczywiście występuje w załączonym, aktualnym pliku. Następnie zadaj węższe pytanie, podając nazwę dokumentu lub tematu. Jeśli wąskie pytanie zadziała, popraw wskazówki wyszukiwania, upraszczając nagłówki, dzieląc zbyt obszerny dokument lub usuwając konkurencyjne wersje. Jeśli wąskie pytanie nadal nie daje rezultatu, przekształć kluczowy materiał w bardziej przejrzysty tekst i przetestuj ponownie.
Nie rozwiązuj od razu każdego błędu, dodając kolejne instrukcje. Nadmierna liczba lub sprzeczność reguł może sprawić, że zachowanie będzie mniej przewidywalne. Podobnie, nie dodawaj kolejnych plików, dopóki nie upewnisz się, że istniejący zestaw jest czysty. Sygnałem jakości, którego oczekujesz, jest powtarzalność: ten sam mały zestaw ewaluacyjny powinien przejść pomyślnie po każdej zmianie, szczególnie w przypadku pytań o wysokim ryzyku, dotyczących polityki, kwestii prawnych, cenowych lub operacyjnych.
Praktyczne ograniczenie: można poprawić wyszukiwanie, ale nie zagwarantować jego skuteczności
Żaden monit nie sprawi, że model generatywny będzie konsultował każdy plik wiedzy dla każdej odpowiedzi z absolutną pewnością. Niezawodny, niestandardowy GPT to zatem zaprojektowany przepływ pracy, a nie jednorazowe przesłanie: ukierunkowane pliki źródłowe, wyraźne instrukcje dotyczące priorytetu źródła, zdefiniowane zachowanie wstrzymywania się od głosu i powtarzalna ewaluacja. Jeśli te elementy sterujące nadal nie zapewniają wymaganej dokładności lub świeżości, zmień architekturę, zamiast nadal dostrajać tę samą statyczną konfigurację.
W przypadku kwalifikujących się GPT proces ten może znacząco ograniczyć problem „zapomniałem pliku”. Jednak w przypadku nowych prac rozpoczętych pod koniec 2026 roku, decyzja długoterminowa powinna również uwzględniać zapowiadane przez OpenAI przejście z niestandardowych przepływów pracy GPT na wtyczki oraz dostępność połączonych źródeł wiedzy.