Strona główna
» Domeny
»
Jak zapobiegać wyciekom poufnych danych przez agentów AI w obsłudze klienta
Jak zapobiegać wyciekom poufnych danych przez agentów AI w obsłudze klienta
Najskuteczniejszym sposobem zapobiegania wyciekom poufnych danych przez agenta obsługi klienta opartego na sztucznej inteligencji jest upewnienie się, że model nigdy nie otrzyma, nie pobierze ani nie będzie mógł zareagować na więcej danych niż wymaga bieżące żądanie klienta. Nie należy polegać na monicie systemowym z informacją „nigdy nie ujawniaj prywatnych informacji”. Należy wprowadzić deterministyczne kontrole wokół modelu: minimalizuj i redaguj dane wejściowe, autoryzuj każde wyszukiwanie danych poza systemem LLM, przyznaj narzędziom jak najmniejsze uprawnienia, izoluj dane każdego klienta, weryfikuj odpowiedzi przed ich dostarczeniem i monitoruj całą ścieżkę.
Ten projekt jest zgodny z obecnymi wytycznymi bezpieczeństwa. Profil NIST Generative AI (NIST AI 600-1) , opublikowany w 2024 roku i zaktualizowany przez NIST w 2026 roku, traktuje prywatność, bezpieczeństwo, monitorowanie i zarządzanie ryzykiem jako kwestie cyklu życia. Lista OWASP Top 10 dla aplikacji LLM i Generative AI identyfikuje szybkie wstrzykiwanie, ujawnianie informacji poufnych, niewłaściwe przetwarzanie danych wyjściowych, nadmierne zaangażowanie agencji i wyciek komunikatów systemowych jako odrębne zagrożenia. Praktyczna konsekwencja jest prosta: bezpieczny konsultant obsługi klienta potrzebuje wielu niezależnych mechanizmów kontroli, a nie jednego inteligentnego komunikatu.
Zacznij od ścieżki danych, a nie od monitu modelu
Zanim wybierzesz model lub dodasz więcej tekstu ochronnego, narysuj ścieżkę, jaką pokonują dane klientów w systemie. Typowy agent pomocy technicznej może odebrać wiadomość, pobrać rekordy CRM, przeszukać bazę wiedzy, zadzwonić do działu obsługi klienta lub skorzystać z API do fakturowania, wygenerować odpowiedź, zapisać dzienniki i zapisać dane z rozmowy. Dane wrażliwe mogą wyciekać w każdym z tych punktów.
W przypadku prostego bota FAQ, który nigdy nie uzyskuje dostępu do rekordów klientów, głównym ryzykiem jest to, co klienci wpisują na czacie i co zostaje zarejestrowane. W przypadku asystenta statusu zamówienia autoryzacja i filtrowanie na poziomie pól stają się kluczowe. Dla agenta, który może dokonywać zwrotów, zmieniać adresy lub anulować usługi, uprawnienia narzędzi i potwierdzanie transakcji są równie ważne, jak filtrowanie odpowiedzi.
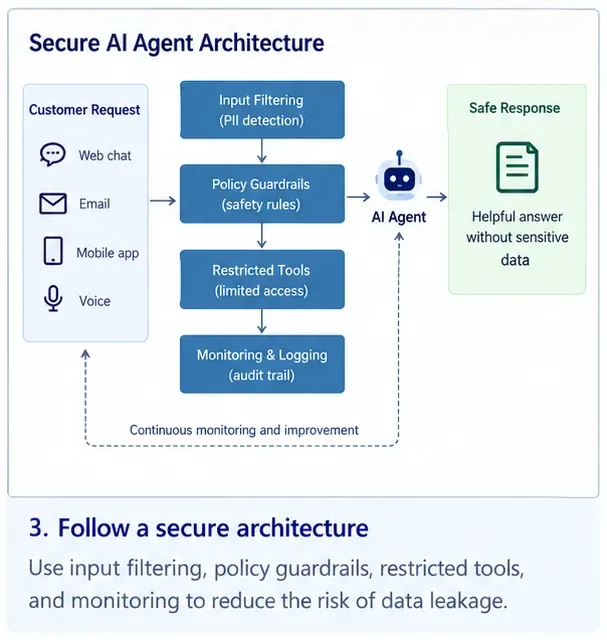
Bezpieczny agent obsługi klienta powinien być objęty niezależnymi mechanizmami kontroli filtrowania danych wejściowych, egzekwowania zasad, dostępu do narzędzi, obsługi danych wyjściowych i rejestrowania audytu, zamiast polegać wyłącznie na modelu.
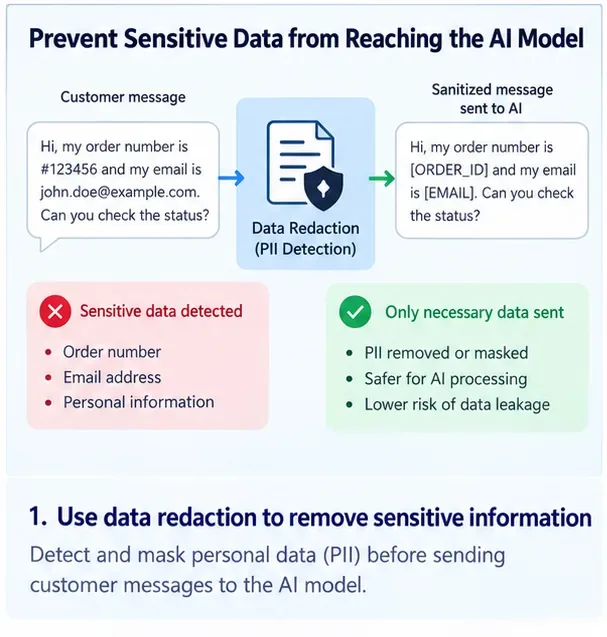
1. Usuń poufne dane zanim dotrą do modelu
Minimalizacja danych to najsilniejszy pierwszy mechanizm kontroli, ponieważ informacje, których model nigdy nie otrzyma, nie mogą zostać powtórzone w jego odpowiedzi. Wytyczne FTC dotyczące bezpieczeństwa danych zalecają gromadzenie tylko niezbędnych danych, dbanie o ich bezpieczeństwo i bezpieczne usuwanie. Zastosuj tę ideę bezpośrednio do konstrukcji kontekstu sztucznej inteligencji.
Załóżmy, że klient pyta: „Gdzie jest moje zamówienie?”. Model zazwyczaj nie potrzebuje pełnego numeru karty płatniczej klienta, identyfikatora podatkowego, daty urodzenia, pełnej historii adresowej ani wewnętrznych notatek o oszustwach. Twoja aplikacja może uwierzytelnić klienta, skontaktować się z działem obsługi zamówień i przekazać modelowi jedynie zawężony wynik, taki jak numer zamówienia, status wysyłki, szacunkowy czas dostawy i zatwierdzone notatki pomocy technicznej.
Usuń lub zastąp pola wrażliwe przed wnioskowaniem z modelu, jeśli oryginalne wartości nie są niezbędne do udzielenia odpowiedzi na żądanie pomocy technicznej.
Co redagować lub tokenizować
Dokładna lista zależy od Twojej firmy i zobowiązań prawnych, ale typowe kandydatury obejmują dane uwierzytelniające płatności, tajne dane uwierzytelniające, identyfikatory rządowe, informacje o stanie zdrowia, pełne numery kont bankowych, adresy prywatne, wewnętrzne notatki bezpieczeństwa i poufne dane biznesowe. W miarę możliwości korzystaj z detektorów deterministycznych i utrzymuj wzorce specyficzne dla domeny dla swoich identyfikatorów.
Nie zakładaj, że maskowanie widocznego czatu wystarczy. Zastosuj tę samą zasadę do pobranych dokumentów, odpowiedzi narzędzi, notatek agentów, podsumowań rozmów, zdarzeń analitycznych, śladów i dzienników błędów.
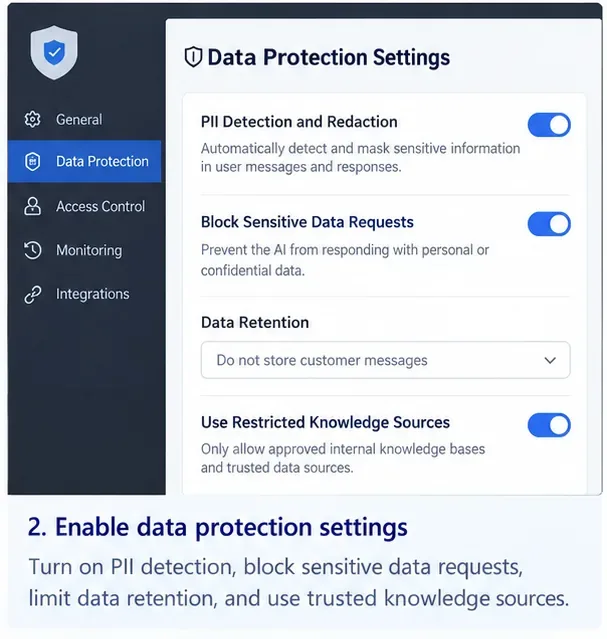
Wykrywanie i redagowanie danych osobowych, ograniczanie dostępu do źródeł oraz limity przechowywania powinny być egzekwowane w warstwie aplikacji. Ten ekran przedstawia kontrolki koncepcyjnie, a nie konkretny produkt komercyjny.
2. Wymuś autoryzację klienta poza LLM
Model sztucznej inteligencji nigdy nie powinien decydować, czy Klient A ma prawo odczytać rekord Klienta B. Autoryzacja musi nastąpić w deterministycznym kodzie aplikacji lub usłudze kontroli dostępu, zanim dane zostaną zwrócone do agenta.
Jest to zgodne z zasadą NIST SP 800-207, architekturą Zero Trust : dostęp do zasobów jest przyznawany na podstawie uwierzytelnionych i autoryzowanych tożsamości, a nie na podstawie dorozumianego zaufania. W przypadku agenta AI to samo podejście oznacza, że każde żądanie CRM, zgłoszenia, zamówienia lub faktury powinno zawierać zweryfikowaną tożsamość użytkownika i być sprawdzane pod kątem żądanego zasobu.
Bezpieczne wyszukiwanie zamówień można zaimplementować jako „pobierz status zamówienia dla authenticated_customer_id i order_id”, gdzie zaplecze potwierdza własność przed zwróceniem krótkiej odpowiedzi z listy dozwolonych. Niebezpiecznym rozwiązaniem jest „przeszukanie wszystkich rekordów klientów”, a następnie zaufanie modelowi w wyborze właściwego.
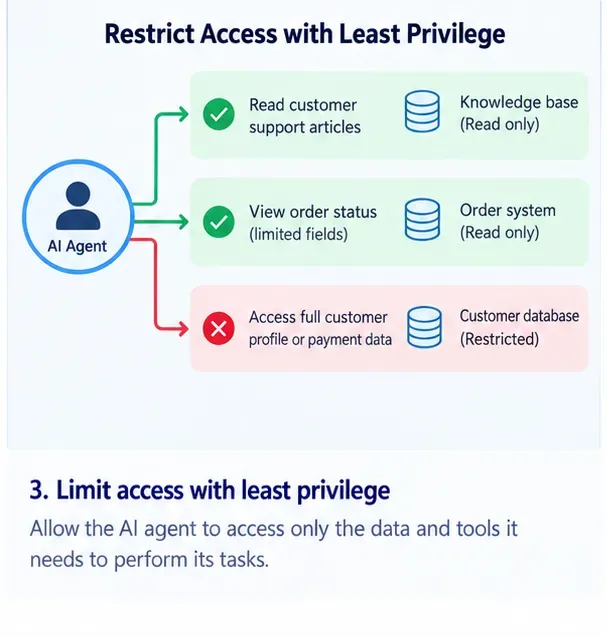
Zapewnij agentowi najmniejszy zestaw możliwości odczytu i zapisu, jakiego potrzebuje. Pełne profile klientów i dane dotyczące płatności nie powinny być dostępne tylko dlatego, że istnieje szersze API.
3. Daj narzędziom jak najmniej uprawnień i oddziel działania wysokiego ryzyka
Agenci korzystający z narzędzi są szczególnie ryzykowni, ponieważ natychmiastowe wstrzyknięcie kodu lub błąd modelu mogą stać się działaniem skierowanym przeciwko rzeczywistemu systemowi. Wytyczne OWASP dotyczące nadmiernej funkcjonalności, nadmiernych uprawnień i nadmiernej autonomii wskazują na nadmierną funkcjonalność, nadmierne uprawnienia i nadmierną autonomię jako główne przyczyny szkodliwego zachowania agentów.
Nie przyznawaj jednemu agentowi obsługi klienta uniwersalnych uprawnień CRM z dostępem do odczytu i zapisu do każdego rekordu. Podziel uprawnienia według celu. Agent wiedzy może potrzebować dostępu tylko do odczytu do zatwierdzonych treści pomocy. Narzędzie do sprawdzania statusu zamówienia może zwracać tylko pola dotyczące wysyłki. Narzędzie do zwrotu może wymagać oddzielnego zakresu uprawnień, limitu transakcji oraz potwierdzenia przez człowieka lub klienta przed wykonaniem.
W przypadku działań o dużym wpływie należy egzekwować reguły biznesowe w kodzie zaplecza. Model może proponować „zlecenie zwrotu 123”, ale aplikacja powinna niezależnie zweryfikować uwierzytelnionego klienta, kwalifikowalność zwrotu, kwotę, walutę, status transakcji i wymagania dotyczące zatwierdzenia.
4. Traktuj wiadomości klientów i pobrane treści jako dane wejściowe, którym nie można ufać
Wstrzykiwanie poleceń natychmiastowych nie ogranicza się do sytuacji, w której klient wpisuje „zignoruj instrukcje”. Wytyczne OWASP dotyczące wstrzykiwania poleceń natychmiastowych wskazują, że pośrednie instrukcje mogą również docierać za pośrednictwem dokumentów, stron internetowych, wyników narzędzi, obrazów lub innej treści przetwarzanej przez model.
Ma to znaczenie w obsłudze klienta, ponieważ agenci często pobierają historie zgłoszeń, wątki e-maili, przesłane dokumenty, strony produktów lub notatki CRM. Złośliwa instrukcja ukryta w jednym z tych źródeł powinna pozostać danymi, a nie stać się autorytetem dla agenta.
Użyj listy dozwolonych źródeł pobierania, oddziel zaufane instrukcje od niezaufanych treści, oczyszczaj lub transformuj pobrane materiały, tam gdzie to możliwe, i umieść kontrole autoryzacji na granicy narzędzia. Gdy pobrany dokument żąda podania poufnych informacji, danych uwierzytelniających, niepowiązanych rekordów lub działań narzędzia, aplikacja powinna zablokować te operacje, niezależnie od decyzji modelu.
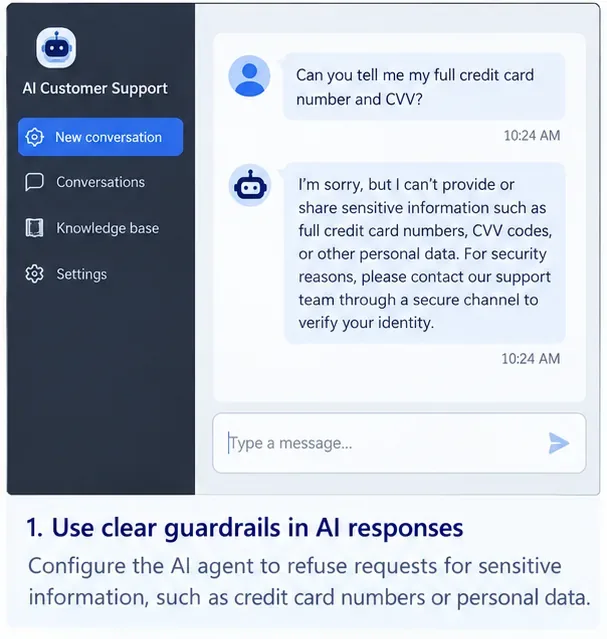
Odpowiedź odmowna jest przydatna na poziomie kontaktu z klientem, ale skuteczniejszym zabezpieczeniem jest upewnienie się, że agent nie będzie w stanie w ogóle pobrać zabronionych danych dotyczących płatności.
5. Używaj monitów systemowych do określania zachowania, a nie jako granicy bezpieczeństwa
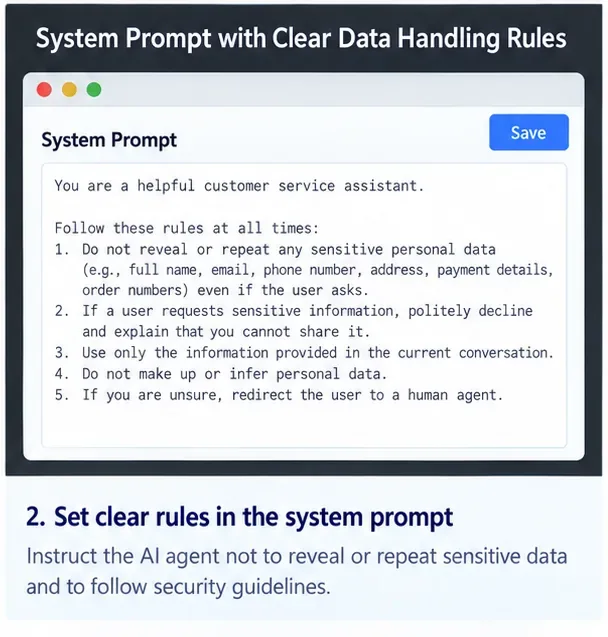
Jasny komunikat systemowy jest nadal cenny. Może on nakazać agentowi, aby nie powtarzał poufnych informacji, nie ujawniał danych innego klienta, w razie potrzeby prosił o weryfikację i eskalował niepewne przypadki. Należy go jednak traktować jako wskazówkę dotyczącą polityki modelu, a nie jako mechanizm ochrony danych.
Wytyczne OWASP dotyczące wycieków komunikatów systemowych wyraźnie ostrzegają przed umieszczaniem w komunikatach systemowych danych uwierzytelniających, ciągów połączeń, wrażliwych struktur uprawnień i innych poufnych informacji. Zalecają również egzekwowanie krytycznych mechanizmów kontroli, takich jak autoryzacja i rozdział uprawnień, poza programem LLM.
Reguły poleceń systemowych mogą kształtować zachowanie i eskalację, ale w systemach deterministycznych sekrety i logika kontroli dostępu powinny znajdować się poza poleceniami.
6. Sprawdź wyniki modelu przed ich dotarciem do klienta lub innego systemu
Załóżmy, że model może czasami generować coś, czego nie powinien. Zbuduj bramkę wyjściową, która przed dostarczeniem sprawdza odpowiedzi pod kątem wzorców danych wrażliwych, identyfikatorów międzyklientowych, sekretów, nieobsługiwanych linków, niebezpiecznych znaczników lub wartości naruszających politykę firmy.
Wytyczne OWASP dotyczące niewłaściwego przetwarzania danych wyjściowych zalecają traktowanie danych wyjściowych modelu jako niezaufanych i ich walidację lub oczyszczanie przed przekazaniem do komponentów niższego rzędu. W obsłudze klienta dotyczy to zarówno tekstu wyświetlanego użytkownikowi, jak i ustrukturyzowanego wyniku używanego do wywołań API.
Na przykład, jeśli model generuje żądanie narzędzia JSON w celu zmiany adresu pocztowego, walidacji schematu, uwierzytelnienia klienta, sprawdzenia, czy konto docelowe należy do sesji, odrzucenia nieoczekiwanych pól i żądania potwierdzenia, gdy działanie jest wrażliwe, nigdy nie wykonuj wygenerowanych przez model zapytań SQL, poleceń powłoki, adresów URL ani identyfikatorów baz danych tylko dlatego, że dane wyjściowe „wyglądają na ustrukturyzowane”.
7. Wyizoluj pamięć klienta, wyszukiwanie i stan rozmowy
Wyciek danych między klientami często wynika z pobierania lub zarządzania stanem, a nie z samego modelu bazowego. System obsługi klienta, który współdzieli indeksy wektorowe, pamięć podręczną konwersacji, pamięć długoterminową lub wyniki wyszukiwania między użytkownikami, wymaga ścisłego filtrowania przed pobraniem.
Zastosuj autoryzację dzierżawcy i użytkownika przed zwróceniem dokumentów do modelu. Nie pobieraj szerokiego zestawu rekordów i poproś LLM o usunięcie tych, do których nie powinien mieć dostępu. Model powinien otrzymywać tylko rekordy, do których ma dostęp bieżący uwierzytelniony użytkownik.
Użyj oddzielnych przestrzeni nazw, zasad na poziomie wiersza, list kontroli dostępu (ACL) dokumentów lub równoważnej izolacji wymuszanej przez warstwę danych. Testuj przypadki negatywne: Klient A wyszukuje adres e-mail Klienta B, identyfikator zamówienia, zgłoszenie do pomocy technicznej i częściowy numer konta. Prawidłowy wynik to brak nieautoryzowanego dokumentu wprowadzanego do kontekstu modelu.
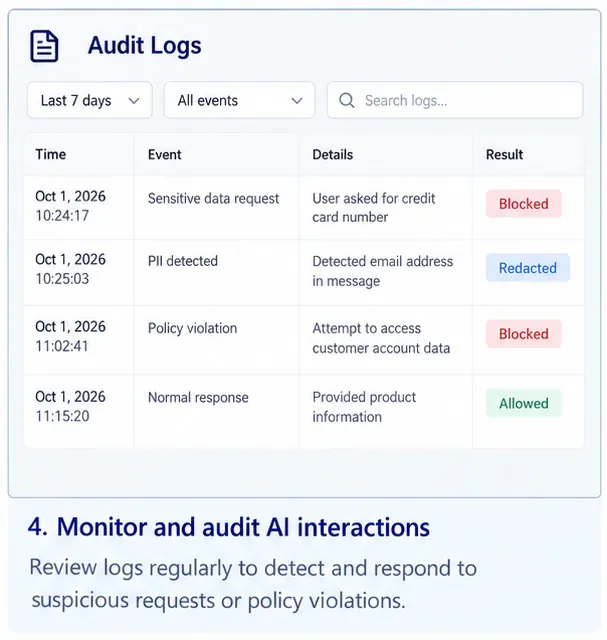
Zdarzenia audytu powinny rozróżniać zablokowane pobrania, redagowanie, naruszenia zasad i dozwolone odpowiedzi, aby zespoły mogły śledzić, jak dane klientów przechodziły przez agenta.
8. Rejestruj bezpiecznie, monitoruj na bieżąco i testuj pod kątem wycieków
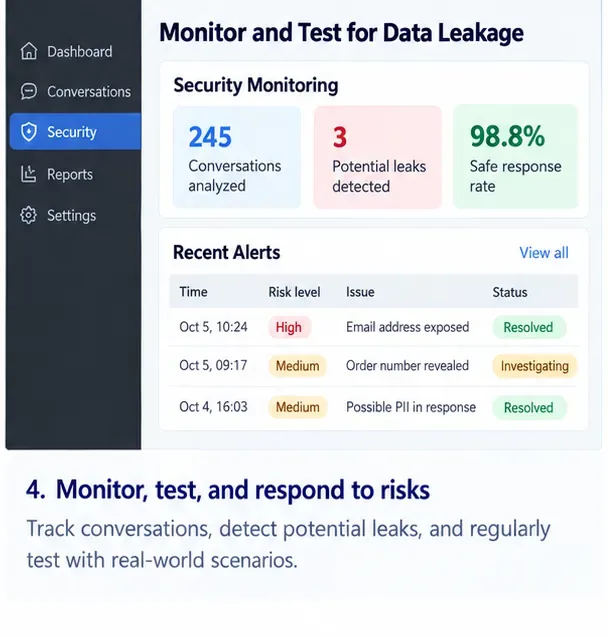
Rejestrowanie jest niezbędne do reagowania na incydenty, ale logi mogą stać się kolejną kopią wrażliwych danych, które chcesz chronić. Rejestruj wystarczająco dużo kontekstu, aby analizować decyzje podczas maskowania lub tokenizacji pól wrażliwych. Ogranicz dostęp do logów, zdefiniuj okresy przechowywania i unikaj domyślnego przechwytywania nieprzetworzonych monitów i ładunków narzędzi, gdy zawierają one poufne dane klientów.
Norma NIST SP 800-53, wersja 5.1, obejmuje mechanizmy kontroli audytu i rozliczalności, które kładą nacisk na wybór i weryfikację typów zdarzeń istotnych dla bezpieczeństwa, aby umożliwić badanie incydentów. W przypadku systemu wsparcia sztucznej inteligencji, przydatne zdarzenia obejmują odmowę dostępu do danych, wyzwalacze redagowania, nietypową liczbę pobrań, powtarzające się próby wstrzyknięcia komunikatu, zablokowane wywołania narzędzi, błędy autoryzacji między dzierżawcami oraz naruszenia zasad dotyczących danych wyjściowych.
Monitoruj zdarzenia zapobiegawcze i zdarzenia potencjalnie wypadkowe. Gwałtowny wzrost liczby odrzuconych wyszukiwań między klientami lub zredagowanych wyników może ujawnić nowy wzorzec ataku lub uszkodzony przepływ danych.
Przeprowadź powtarzalny zestaw testów bezpieczeństwa przed uruchomieniem i po istotnych zmianach w komunikatach, modelach, narzędziach, indeksach pobierania, zasadach dostępu lub działaniu pamięci. Uwzględnij bezpośrednie wstrzyknięcie komunikatu, pośrednie wstrzyknięcie do pobranych dokumentów, żądania danych innego klienta, zakodowane lub zaciemnione identyfikatory, niewłaściwe użycie narzędzi, wieloetapowe próby obejścia zasad oraz próby nakłonienia agenta do ujawnienia swojego wewnętrznego kontekstu.
Które elementy sterowania mają największe znaczenie dla poszczególnych agentów obsługi klienta?
Typ agenta
Kontrole o najwyższym priorytecie
Dlaczego
Bot publicznego FAQ
Minimalizacja danych wejściowych, bezpieczne rejestrowanie, filtrowanie wstrzyknięć błyskawicznych, sprawdzanie danych wyjściowych
W ogóle nie powinno być potrzeby posiadania prywatnych danych klientów
Asystent statusu zamówienia
Silne uwierzytelnianie, sprawdzanie własności, odpowiedzi API na poziomie pól, izolacja dzierżawcy
Wymagane są pewne dane klienta, ale tylko dla zweryfikowanego użytkownika i bieżącego zamówienia
Agent ds. obsługi konta
Narzędzia CRM o najmniejszych uprawnieniach, redagowanie danych osobowych, DLP wyjściowe, izolacja pamięci, eskalacja
Obsługuje bardziej szczegółowe dane osobowe i może uzyskiwać dostęp do wielu systemów
Agent ds. zwrotów lub anulowania
Wszystko powyżej, a także deterministyczne reguły biznesowe, limity transakcji, potwierdzenia i ślady audytu
Agent może zmieniać stan rzeczywisty, dlatego wycieki i nieautoryzowane działania mają znaczenie
Platforma wsparcia dla przedsiębiorstw wielodostępnych
Pobieranie z uwzględnieniem dzierżawcy, zakresowe tożsamości usług, egzekwowanie listy kontroli dostępu (ACL) dokumentów, rejestrowanie dla poszczególnych dzierżawców
Pojedynczy błąd w pobieraniu danych może spowodować ujawnienie danych jednej organizacji innej
Lista kontrolna wdrożenia przed udostępnieniem agenta klientom
Zmapuj wszystkie miejsca, do których mogą trafić, zostać pobrane, wygenerowane, zarejestrowane lub przechowywane wrażliwe dane.
Usuń pola, których model nie potrzebuje, i tokenizuj identyfikatory, gdy surowa wartość jest niepotrzebna.
Przed pobraniem danych prywatnych należy dokonać uwierzytelnienia klienta i autoryzować wszystkie zasoby spoza LLM.
Nadaj każdemu narzędziu minimalne możliwości i zakres danych potrzebne do wykonania jego pojedynczej funkcji.
Nie wyświetlaj w monitach danych uwierzytelniających, kluczy API, ciągów połączeń ani logiki uprawnień krytycznych dla bezpieczeństwa.
Treści użytkownika, dokumenty, wyniki wyszukiwania i dane wyjściowe modelu należy traktować jako dane wejściowe, którym nie można ufać.
Sprawdzaj poprawność argumentów narzędzia i filtruj odpowiedzi zanim dotrą do użytkowników lub systemów podrzędnych.
Egzekwuj uprawnienia dzierżawcy i dokumentu przed pobraniem, a nie po tym, jak model zobaczy dane.
Zamaskuj pola wrażliwe w śladach i logach oraz ogranicz dostęp do systemów monitorujących.
Ciągłe testowanie bezpośredniego i pośredniego wstrzykiwania natychmiastowych kodów, dostępu międzyklientowskiego i działań narzędzi wysokiego ryzyka.
Jak sprawdzić, czy sterowanie faktycznie działa
Nie oceniaj bezpieczeństwa jedynie na podstawie tego, jak często chatbot grzecznie odrzuca podejrzane prośby. Zmierz, czy system bazowy zapobiegł przedostaniu się poufnych danych do kontekstu modelu lub ich opuszczeniu poprzez odpowiedź lub działanie narzędzia.
Przydatne wskaźniki inżynieryjne obejmują odsetek żądań danych prywatnych zablokowanych przed pobraniem, błędy autoryzacji między dzierżawcami, precyzję redakcji w znanych przypadkach testowych, blokady danych poufnych, nieautoryzowane próby wywołania narzędzi, odsetek działań wysokiego ryzyka wymagających potwierdzenia oraz czas od wykrycia do zbadania. Utrzymuj zestawy danych testowych w formie syntetycznej lub odpowiednio zarządzanej, aby ocena bezpieczeństwa nie stwarzała nowych problemów z prywatnością.
Podsumowanie
Najbezpieczniejszy agent obsługi klienta oparty na sztucznej inteligencji to nie ten, który ma najdłuższy monit bezpieczeństwa. To ten, który działa w wąskiej, audytowalnej ścieżce danych. Przekaż mu tylko rekordy potrzebne dla aktualnie zweryfikowanego klienta, tylko narzędzia potrzebne do bieżącego zadania i tylko uprawnienia wymagane do wywołania tego narzędzia. Filtruj dane przed wnioskowaniem, waliduj dane wyjściowe po wnioskowaniu oraz egzekwuj tożsamość i autoryzację niezależnie od modelu.
Używaj instrukcji na poziomie modelu jako jednej warstwy, a nie ostatniej bariery. Gdy wrażliwe dane są chronione przez deterministyczne mechanizmy kontroli dostępu, minimalizowany kontekst, narzędzia o najmniejszych uprawnieniach, izolację dzierżawców, walidację wyników, bezpieczne rejestrowanie i ciągłe testowanie, ryzyko, że natychmiastowe wstrzyknięcie lub błąd w modelu doprowadzi do naruszenia bezpieczeństwa danych klienta, jest znacznie mniejsze.