Strona główna
» Domeny
»
Przewodnik krok po kroku: Automatyzacja cotygodniowego monitorowania konkurencji przy użyciu agentów AI
Przewodnik krok po kroku: Automatyzacja cotygodniowego monitorowania konkurencji przy użyciu agentów AI
Monitorowanie konkurencji często zawodzi z prostego powodu: badania są rozproszone między zbyt wieloma kartami przeglądarki, zbyt wieloma osobami i zbyt wieloma definicjami tego, co stanowi istotną zmianę. Jedna osoba sprawdza strony z cenami, inna śledzi notatki wydawnicze, ktoś inny skanuje wiadomości branżowe, a do piątku zespół ma stertę linków, ale brak wiarygodnej odpowiedzi na kluczowe pytanie: co zmieniło się w tym tygodniu i czy ma to znaczenie?
Agent AI może zmniejszyć tę ręczną pracę, ale agent jest tylko jednym z elementów systemu. Niezawodny cotygodniowy przepływ pracy wymaga również listy źródeł, formatu dowodów, punktu odniesienia z poprzedniego tygodnia, harmonogramu i etapu przeglądu przez człowieka. Jeśli pominiesz te elementy, możesz równie skutecznie automatyzować szum, co wgląd w sytuację.
Ten przewodnik buduje przepływ pracy od najprostszych decyzji po te bardziej techniczne. Konkretna implementacja wykorzystuje obecny OpenAI Agents SDK oraz GitHub Actions, ponieważ ich oficjalna dokumentacja obsługuje wyszukiwanie w sieci, strukturyzowane wyjścia, śledzenie (tracing) i harmonogramowane przepływy pracy. Sama architektura jest neutralna wobec dostawcy: możesz zastąpić dowolny z tych komponentów, jeśli inny runtime agenta lub harmonogram lepiej pasuje do Twojego stosu technologicznego.
Co powinien faktycznie robić cotygodniowy agent monitorujący konkurencję?
W minimalnym zakresie system powinien odpowiadać na cztery pytania: co się zmieniło, skąd pochodzą dowody, jak zmiana różni się od ostatniego znanego stanu i czy osoba decyzyjna powinna się tym zainteresować. „Agent AI” oznacza tutaj przepływ pracy oparty na LLM, który posiada instrukcje i narzędzia oraz może wykonywać sekwencję działań w kierunku celu. Obecny OpenAI Agents SDK opisuje agentów w ten sam ogólny sposób: model skonfigurowany z instrukcjami, narzędziami i opcjonalnym zachowaniem runtime, takim jak bariery ochronne (guardrails) i strukturyzowane wyjścia. Zobacz oficjalną dokumentację OpenAI Agents SDK.
Nie projektuj pierwszej wersji tak, aby „monitorować wszystko”. Zacznij od małego zakresu, który nadal możesz audytować ręcznie. Gdy zaufasz potokowi danych, rozszerz go.
Krok 1: Zdefiniuj konkurentów, sygnały i cotygodniowe pytania
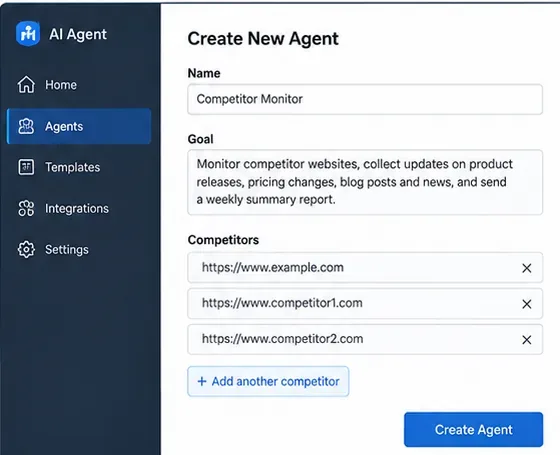
Utwórz brief monitorujący, zanim napiszesz jakikolwiek kod agenta. Dla każdego konkurenta zdecyduj, które zmiany są warte raportowania. Typowe sygnały obejmują zmiany cen publicznych, premiery produktów, notatki wydawnicze, nowe integracje, zmiany pozycjonowania, ważne aktualizacje dokumentacji, publiczne partnerstwa, ogłoszenia dotyczące kadry zarządzającej oraz główne wzorce zatrudnienia. Dokładna lista powinna odpowiadać decyzjom, które faktycznie podejmuje Twój zespół.
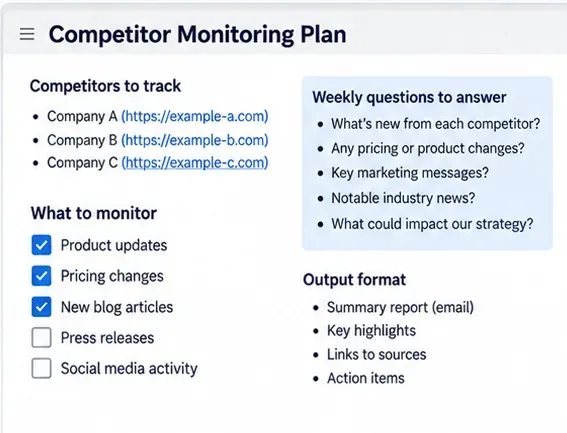
Przydatny brief oddziela sygnały od pytań. „Strona z cenami uległa zmianie” to sygnał. „Czy nowy plan czyni konkurenta bardziej atrakcyjnym dla małych zespołów?” to pytanie analityczne. Agent powinien zbierać pierwsze i wnioskować na temat drugiego dopiero po uzyskaniu dowodów.
Koncepcyjna ilustracja wygenerowana przez AI przedstawiająca brief monitorujący; nie jest to zrzut ekranu rzeczywistego produktu.
Dla pierwszego cotygodniowego przebiegu napisz jedno zdanie definiujące sukces. Na przykład: „Do poniedziałku rano przygotuj podsumowanie istotnych zmian z poprzednich siedmiu dni dla pięciu wymienionych konkurentów, z linkami do źródeł i bez niepopartych twierdzeń”. To zdanie stanie się później praktycznym testem akceptacji.
Krok 2: Zbuduj rejestr źródeł zamiast polegać na otwartym wyszukiwaniu
Wyszukiwanie w sieci jest przydatne do odkrywania, ale system monitorowania nie powinien polegać wyłącznie na rankingach wyszukiwania. Zbuduj mały rejestr źródeł z polami takimi jak konkurent, typ źródła, URL, priorytet, oczekiwana częstotliwość aktualizacji i pytanie, na które źródło może odpowiedzieć.
Sygnał
Preferowane źródło
Dlaczego jest przydatne
Ceny
Oficjalne strony z cenami i planami
Najbliższe źródło aktualnej oferty handlowej
Zmiany w produkcie
Notatki wydawnicze, changelog, blog produktowy
Zazwyczaj podaje daty i kontekst funkcjonalności
Pozycjonowanie
Strona główna, strony produktowe, strony kampanii
Pokazuje, jak firma prezentuje produkt
Wiadomości korporacyjne
Biuro prasowe i blog firmowy
Przydatne dla partnerstw, finansowania, przywództwa i premier
Kontekst rynkowy
Szacowane publiczne źródła wiadomości
Dodaje niezależny kontekst do twierdzeń własnych
Preferuj strony publiczne, oficjalne kanały informacyjne, udokumentowane API i źródła, do których masz autoryzację dostępu. Nie projektuj agenta tak, aby omijał logowania, paywalle, ograniczenia robots.txt lub kontrole dostępu. Dla platform społecznościowych preferuj oficjalne API lub publiczne kanały informacyjne, jeśli są dostępne, zamiast kruchego scrapingu.
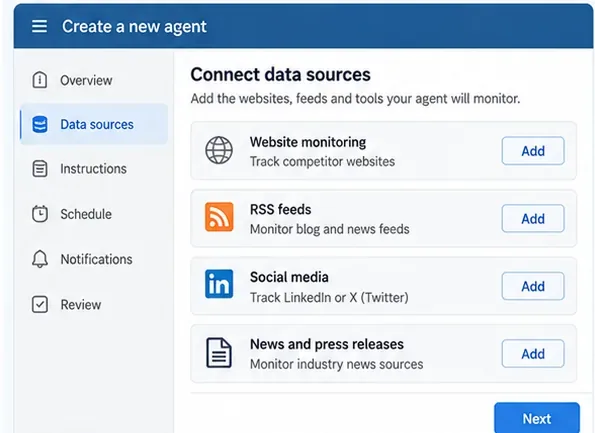
Koncepcyjna ilustracja wygenerowana przez AI przedstawiająca rejestr źródeł; używaj tylko źródeł, do których masz pozwolenie na dostęp.
Obecny OpenAI Agents SDK zawiera hostowane narzędzie WebSearchTool dla agentów korzystających z modeli OpenAI Responses. Oficjalna dokumentacja narzędzi rozróżnia również hostowane wyszukiwanie w sieci od lokalnych narzędzi funkcji, co jest przydatne, jeśli chcesz, aby agent wywoływał własny pobieracz URL, bazę danych, czytnik RSS lub usługę wykrywania zmian. Zobacz oficjalny przewodnik po narzędziach Agents SDK.
Krok 3: Zdefiniuj schemat dowodów, zanim poprosisz model o podsumowanie
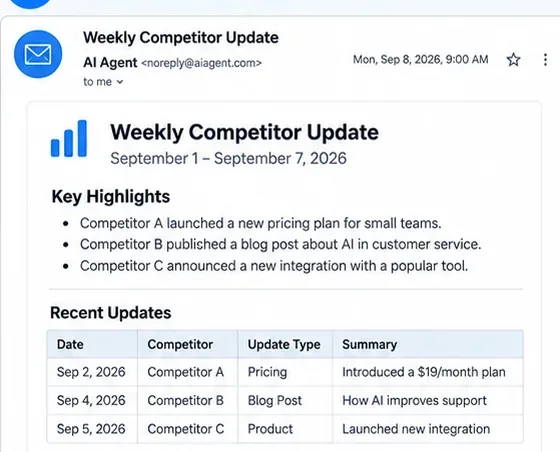
Najłatwiejszym sposobem na uzyskanie niespójnych cotygodniowych raportów jest poproszenie o „podsumowanie wiadomości o konkurencji”. Zamiast tego zdefiniuj strukturyzowane ustalenie. W minimalnym zakresie każde ustalenie powinno zawierać konkurenta, kategorię, datę obserwacji, krótkie podsumowanie, URL źródła, fragment dowodu lub notatkę źródłową oraz flagę pewności lub przeglądu.
Dodaj pola previous_state i current_state, gdy sygnał można bezpośrednio porównać, np. cenę planu, dostępność funkcji, nagłówek lub udokumentowaną integrację. Sprawia to, że raport dotyczy zmiany, a nie tego, co model przypadkiem znalazł w danym tygodniu.
Strukturyzowane wyjście ułatwia również testowanie przepływu pracy. Agents SDK obecnie obsługuje output_type dla agenta, a oficjalna dokumentacja zaleca normalne typy Pythona, takie jak modele Pydantic lub dataclasses, dla strukturyzowanych wyników. Zobacz oficjalny przewodnik po konfiguracji agenta.
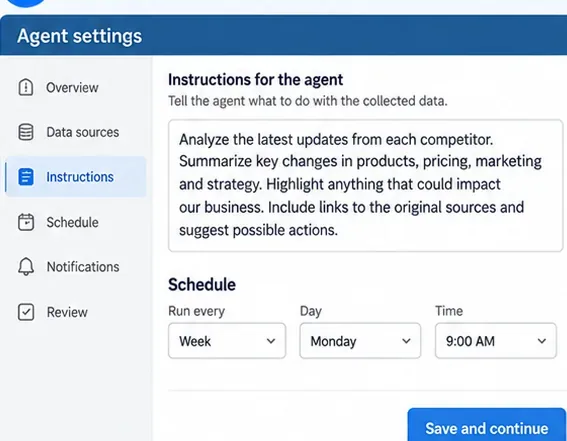
Koncepcyjna ilustracja wygenerowana przez AI przedstawiająca instrukcje agenta i harmonogramowanie; nie jest to rzeczywisty interfejs produktu.
Ostatnie pole jest ważne. Dobry system monitorowania powinien być w stanie powiedzieć „nie znaleziono istotnych zmian”, zamiast wymyślać aktualizację, aby wypełnić miejsce.
Krok 4: Przeprowadź ręczny pilotaż przed automatyzacją czegokolwiek
Uruchom przepływ pracy ręcznie przez jeden okres raportowy i porównaj wynik z własnym przeglądem tych samych źródeł. Ten pilotaż ujawnia problemy, które trudniej zauważyć po zaplanowaniu: nieaktualne wyniki wyszukiwania, zduplikowane artykuły, niejasna taksonomia kategorii, niepoparte wnioski, brakujące URL-e źródeł oraz ustalenia, które są technicznie nowe, ale strategicznie nieistotne.
Dla każdego proponowanego ustalenia zadaj pytanie: czy źródło jest własne (first-party) lub niezależnie wiarygodne, czy zmiana mieści się w zamierzonym oknie dat, czy mogę wskazać dokładny dowód i czy ta sama pozycja zostałaby zgłoszona ponownie w przyszłym tygodniu, gdyby nic się nie zmieniło? Jeśli odpowiedź na ostatnie pytanie brzmi „tak”, nadal potrzebujesz punktu odniesienia lub reguły deduplikacji.
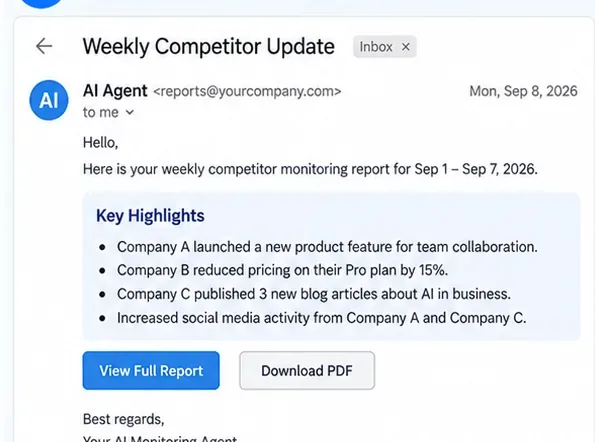
Koncepcyjna ilustracja wygenerowana przez AI przedstawiająca raport pilotażowy z linkami do dowodów.
Nie traktuj fragmentów wyszukiwania jako rekordu dowodowego. Przechowuj URL źródła oraz, jeśli Twoje warunki i prawa dostępu na to pozwalają, znormalizowany zrzut lub wyodrębniony tekst używany do porównań. Wyszukiwanie powinno pomagać w lokalizowaniu dowodów; nie powinno stawać się ich substytutem.
Krok 5: Wdroż agenta z wyszukiwaniem w sieci, strukturyzowanym wyjściem i punktem odniesienia
Gdy ręczny pilotaż przynosi użyteczne ustalenia, podłącz agenta do kodu. Stan na wrzesień 2026 roku: Python Agents SDK od OpenAI może łączyć Agent, hostowane WebSearchTool i strukturyzowane output_type. Poniższy przykład jest celowo mały: demonstruje warstwę agenta, a nie warstwę przechowywania danych.
from pydantic import BaseModel
from agents import Agent, Runner, WebSearchTool

class Finding(BaseModel):
    competitor: str
    category: str
    summary: str
    source_url: str
    evidence: str
    observed_at: str
    needs_human_review: bool

class WeeklyReport(BaseModel):
    findings: list[Finding]
    executive_summary: str

agent = Agent(
    name="Weekly competitor monitor",
    instructions=(
        "Monitor only the competitors and topics in the input. "
        "Use public web sources. Every finding must include a source URL "
        "and evidence. Prefer first-party sources for product and pricing claims. "
        "Do not invent a change when no material change is supported."
    ),
    tools=[WebSearchTool()],
    output_type=WeeklyReport,
)

result = Runner.run_sync(
    agent,
    "Review the configured competitors for the reporting window and return the report."
)

report = result.final_output
Instalacja pakietu i wzorzec runnera są udokumentowane w oficjalnym szybkim starcie Agents SDK. SDK dokumentuje również Runner.run_sync() jako synchroniczną otoczkę wokół normalnego przebiegu agenta.
Koncepcyjna ilustracja wygenerowana przez AI przedstawiająca przepływ pracy agenta; szczegóły implementacji zależą od Twojego stosu technologicznego.
Dodaj deterministyczne wykrywanie zmian, gdzie to możliwe
Nie proś modelu o ponowne odkrywanie każdego starego stanu z pamięci. Trwale zapisuj punkt odniesienia. Dla każdego źródła przechowuj ostatnią udaną obserwację: znormalizowany tekst, hash zawartości, wybrane pola takie jak cena lub nazwa planu, znacznik czasu obserwacji i URL źródła. Przy następnym uruchomieniu najpierw porównaj nową obserwację z punktem odniesienia. Następnie podaj agentowi różnicę do zinterpretowania.
Ten hybrydowy projekt jest bardziej niezawodny niż „AI porównuje dwie całe strony internetowe”, ponieważ deterministyczny kod obsługuje dokładne porównanie, podczas gdy model obsługuje klasyfikację, trafność i wyjaśnienia. Jeśli strona zmienia tylko stopkę lub parametry śledzenia, Twój normalizator może usunąć ten szum, zanim zobaczy go agent.
Krok 6: Zaplanuj przepływ pracy co tydzień i trzymaj poświadczenia z dala od kodu
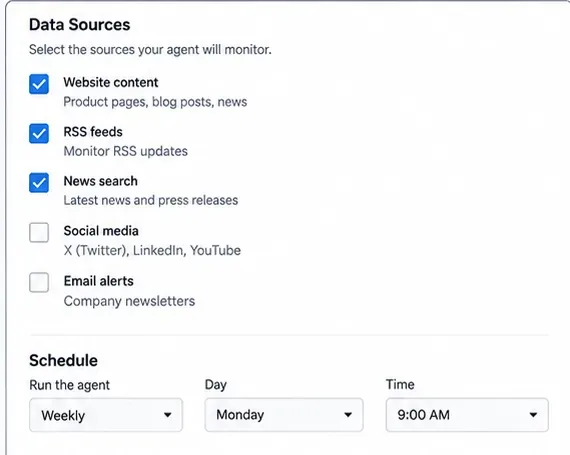
Możesz uruchamiać monitor z dowolnego harmonogramu pasującego do Twojego środowiska. GitHub Actions to praktyczna opcja dla przepływu pracy opartego na repozytorium. Obecna dokumentacja GitHuba mówi, że harmonogramowane przepływy pracy używają składni cron POSIX, działają na domyślnej gałęzi, domyślnie w UTC i opcjonalnie mogą określać strefę czasową IANA. GitHub ostrzega również, że uruchomienia mogą być opóźniane w okresach wysokiego obciążenia, szczególnie na początku godziny, dlatego minuta taka jak 17 jest preferowana nad 00, gdy dokładne wykonanie na początku godziny nie jest konieczne. Zobacz oficjalną dokumentację harmonogramów GitHub Actions.
Przechowuj klucze API jako zaszyfrowane sekrety, a nie commituj ich do repozytorium. Oficjalny przewodnik po sekretach GitHuba wyjaśnia sekrety repozytorium, środowiska i organizacji oraz zaleca unikanie przypadkowego ujawnienia w logach przepływu pracy.
Koncepcyjna ilustracja wygenerowana przez AI przedstawiająca warstwę harmonogramowania; artykuł używa GitHub Actions jako konkretnego przykładu.
Jeden szczegół operacyjny łatwo przeoczyć: GitHub informuje, że harmonogramowane przepływy pracy w publicznych repozytoriach są automatycznie wyłączane po 60 dniach braku aktywności w repozytorium. Jeśli ten przepływ pracy jest krytyczny dla misji, monitoruj monitor – zapisuj czas ostatniego udanego uruchomienia i alertuj, gdy oczekiwane cotygodniowe zadanie nie zostanie ukończone.
Krok 7: Umieść bramkę przeglądu przez człowieka między „ustaleniem” a „decyzją”
Cotygodniowe monitorowanie konkurencji to przepływ pracy typu czytaj-i-podsumuj, więc nie powinien automatycznie zmieniać cen, publikować treści ani modyfikować roadmapy produktu. Osoba powinna przeglądać istotne twierdzenia, zanim wpłyną one na decyzję. Przegląd może być lekki: zatwierdź, odrzuć, połącz z innym ustaleniem lub oznacz jako „obserwuj w przyszłym tygodniu”.
Wymagaj silniejszego przeglądu dla kategorii o wysokim wpływie, takich jak ceny, twierdzenia prawne, incydenty bezpieczeństwa, zwolnienia, przejęcia lub oświadczenia oparte na raportach stron trzecich. Dla zmian w produktach i cenach preferuj własną stronę konkurenta jako główne dowody, nawet jeśli artykuł w wiadomościach pomógł Ci je odkryć.
Koncepcyjna ilustracja wygenerowana przez AI przedstawiająca etap przeglądu przez człowieka przed udostępnieniem lub podjęciem działań na podstawie ustaleń.
Jeśli Twoja implementacja później doda narzędzia zdolne do podejmowania działań, Agents SDK zawiera bariery ochronne (guardrails) i mechanizmy zatwierdzania z udziałem człowieka. Oficjalna dokumentacja barier ochronnych opisuje bariery wejściowe, wyjściowe i narzędziowe, podczas gdy przewodnik po człowieku w pętli wyjaśnia wstrzymywanie wrażliwych wywołań narzędzi w celu zatwierdzenia.
Krok 8: Śledź trendy, śledź błędy i samokontroluj system
Użyteczny cotygodniowy raport staje się bardziej wartościowy po kilku przebiegach, ponieważ możesz odróżnić izolowane zdarzenia od wzorców. Przechowuj każde zatwierdzone ustalenie w prostej tabeli lub bazie danych z konkurentem, kategorią, datą, źródłem i statusem przeglądu. Następnie możesz odpowiadać na pytania, takie jak który konkurent najczęściej zmieniał ceny, które motywy powtarzają się w notatkach wydawniczych lub które monitorowane źródła nie generują już użytecznych sygnałów.
Koncepcyjna ilustracja wygenerowana przez AI przedstawiająca śledzenie trendów i samokontrolę podczas wielu cotygodniowych przebiegów.
Dla samego agenta zachowaj obserwowalność. OpenAI Agents SDK zawiera wbudowane śledzenie (tracing), które rejestruje generacje modeli, wywołania narzędzi, przekazania (handoffs), bariery ochronne i zdarzenia niestandardowe. Oficjalny przewodnik po śledzeniu opisuje, jak ślady i zakresy (spans) mogą być używane do debugowania i monitorowania przepływów pracy. Bądź rozważny w kwestii danych wrażliwych, ponieważ ładunki śledzenia mogą zawierać dane wejściowe/wyjściowe modeli i narzędzi w zależności od konfiguracji.
Samokontrola przed zaufaniem cotygodniowemu raportowi
Każde istotne ustalenie ma działający URL źródła i datę wewnątrz okna raportowego.
Własne twierdzenia dotyczące produktów i cen są poparte dowodami własnymi, gdy tylko to możliwe.
System porównuje się z poprzednim znanym stanem, zamiast po prostu powtarzać stare wiadomości.
„Brak istotnych zmian” jest akceptowalnym wynikiem dla dowolnego konkurenta.
Zduplikowane artykuły z wielu źródeł są łączone, a nie liczone jako osobne zmiany.
Zaplanowane zadanie ma zarejestrowany znacznik czasu sukcesu, a pominięte uruchomienia są wykrywalne.
Klucze API i inne poświadczenia są przechowywane jako sekrety i nie pojawiają się w logach ani raportach.
Człowiek przegląda ustalenia o wysokim wpływie, zanim zespół podejmie na ich podstawie działania.
Częste błędy, które czynią AI monitorowanie konkurencji niezawodnym
Monitorowanie wyłącznie za pomocą zapytań wyszukiwania
Wyszukiwanie jest doskonałe do odkrywania, ale niestabilne jako historyczny punkt odniesienia. Zachowuj jawne URL-e źródeł i trwale zapisuj wcześniejsze obserwacje.
Prośba modelu o „ważne wiadomości” bez schematu
Ważność jest subiektywna. Zdefiniuj kategorie, wymagania dotyczące dowodów i flagę przeglądu, aby wyjście mogło być audytowane.
Pozwalanie agentowi na podsumowywanie bez dat
Wynik może być trafny, ale stary. Zawsze uwzględniaj okno raportowe i wymagaj daty obserwacji lub publikacji, gdy źródło ją podaje.
Wysyłanie każdej odkrytej pozycji do interesariuszy
Oddziel kolekcjonowanie od raportowania. Warstwa kolekcjonowania może znaleźć wiele kandydujących pozycji; końcowy raport powinien zawierać tylko zmiany poparte dowodami, zdeduplikowane i spełniające Twoje reguły trafności.
Automatyzowanie działań zbyt wcześnie
Najbezpieczniejsza pierwsza wersja jest tylko do odczytu: kolekcjonuj, porównuj, podsumowuj i proś o przegląd. Dodaj działania zapisu dopiero po zmierzeniu fałszywych pozytywnych i zrozumieniu trybów awarii.
Prosta architektura, którą możesz ponownie wykorzystać
Trwały wzorzec to: rejestr źródeł → kolekcjonowanie → normalizacja → porównanie z punktem odniesienia → analiza agenta → strukturyzowane ustalenia → przegląd przez człowieka → cotygodniowy raport → magazyn trendów. Agent AI jest najsilniejszy w etapach interpretacji, podczas gdy zwykły kod jest zazwyczaj lepszy do dokładnego harmonogramowania, przechowywania stanu, haszowania, ponownych prób i deterministycznych porównań.
Jeśli przepływ pracy przechodzi samokontrolę przez kilka kolejnych przebiegów, możesz ostrożnie go rozbudować: dodaj więcej konkurentów, dodaj wyspecjalizowanych agentów do zmian cen lub produktów, dodaj bazę danych lub kieruj zatwierdzone raporty do e-maila, Slacka lub wewnętrznej bazy wiedzy. Celem nie jest stworzenie najbardziej autonomicznego agenta. Chodzi o stworzenie najmniejszego powtarzalnego systemu, który dostarcza Twojemu zespołowi terminowe, poparte źródłami zmiany konkurencji co tydzień.