การตรวจสอบคู่แข่งมักล้มเหลวด้วยเหตุผลง่ายๆ คือ งานวิจัยกระจัดกระจายอยู่ตามแท็บเบราว์เซอร์หลายแท็บ บุคลากรหลายคน และนิยามของ "การเปลี่ยนแปลงที่มีความหมาย" ที่ไม่ตรงกัน คนหนึ่งตรวจสอบหน้าราคา อีกคนดูบันทึกการปล่อยเวอร์ชัน (Release Notes) อีกคนสแกนข่าวในอุตสาหกรรม และเมื่อถึงวันศุกร์ ทีมงานมีเพียงกองลิงก์แต่ไม่มีคำตอบที่เชื่อถือได้สำหรับคำถามที่สำคัญ: อะไรเปลี่ยนแปลงไปในสัปดาห์นี้ และมันสำคัญหรือไม่?
AI agent สามารถลดงานที่ต้องทำด้วยมือได้ แต่ agent เป็นเพียงส่วนหนึ่งของระบบเท่านั้น เวิร์กโฟลว์รายสัปดาห์ที่เชื่อถือได้ยังต้องมีรายการแหล่งข้อมูล รูปแบบหลักฐาน เส้นฐานของสัปดาห์ก่อนหน้า ตัวตั้งเวลา (Scheduler) และขั้นตอนการตรวจสอบโดยมนุษย์ หากคุณข้ามส่วนประกอบเหล่านี้ คุณอาจกำลังทำระบบอัตโนมัติที่สร้าง "สัญญาณรบกวน" (Noise) ได้อย่างมีประสิทธิภาพพอๆ กับการสร้าง "ข้อมูลเชิงลึก" (Insight)
คู่มือนี้สร้างเวิร์กโฟลว์ตั้งแต่การตัดสินใจที่ง่ายที่สุดไปจนถึงด้านเทคนิคมากขึ้น การนำไปใช้จริงใช้ OpenAI Agents SDK เวอร์ชันปัจจุบันและ GitHub Actions เนื่องจากเอกสารทางการรองรับการค้นหาเว็บ ผลลัพธ์ที่มีโครงสร้าง การติดตามผล (Tracing) และเวิร์กโฟลว์แบบตั้งเวลา สถาปัตยกรรมนี้ไม่ผูกติดกับผู้ขายรายใด (Vendor-neutral): คุณสามารถเปลี่ยนองค์ประกอบใดก็ได้หากมี Agent runtime หรือ Scheduler อื่นที่เข้ากับระบบของคุณได้ดีกว่า
Agent สำหรับตรวจสอบคู่แข่งรายสัปดาห์ควรทำอะไรจริงๆ?
อย่างน้อยที่สุด ระบบควรตอบคำถามสี่ข้อ: อะไรเปลี่ยนแปลง, หลักฐานมาจากไหน, การเปลี่ยนแปลงนั้นแตกต่างจากสถานะที่ทราบล่าสุดอย่างไร และบุคคลควรให้ความสำคัญหรือไม่ ในที่นี้ "AI agent" หมายถึงเวิร์กโฟลว์ที่ขับเคลื่อนด้วย LLM ซึ่งมีคำสั่งและเครื่องมือ และสามารถดำเนินการตามลำดับเพื่อบรรลุเป้าหมาย OpenAI Agents SDK เวอร์ชันปัจจุบันอธิบาย agent ในลักษณะเดียวกัน: โมเดลที่กำหนดค่าด้วยคำสั่ง เครื่องมือ และพฤติกรรมรันไทม์เพิ่มเติมเช่น Guardrails และผลลัพธ์ที่มีโครงสร้าง ดูที่ เอกสารทางการของ OpenAI Agents SDK
อย่าออกแบบเวอร์ชันแรกให้ "ตรวจสอบทุกอย่าง" เริ่มจากขอบเขตเล็กๆ ที่คุณยังสามารถตรวจสอบด้วยตนเองได้ เมื่อคุณไว้วางใจในไปป์ไลน์แล้ว จึงค่อยขยายขอบเขต
ขั้นตอนที่ 1: กำหนดคู่แข่ง สัญญาณ และคำถามรายสัปดาห์
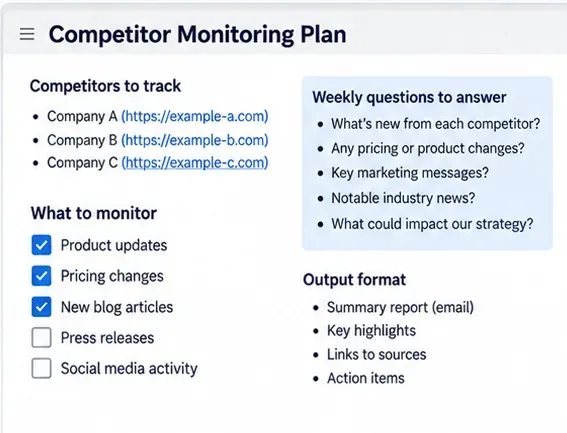
สร้างเอกสารสรุปการตรวจสอบ (Monitoring Brief) ก่อนที่คุณจะเขียนโค้ด agent สำหรับแต่ละคู่แข่ง ให้ตัดสินใจว่าการเปลี่ยนแปลงใดที่ควรค่าแก่การรายงาน สัญญาณทั่วไป ได้แก่ การเปลี่ยนแปลงราคาสาธารณะ การเปิดตัวผลิตภัณฑ์ บันทึกการปล่อยเวอร์ชัน การเชื่อมต่อใหม่ (New Integrations) การเปลี่ยนแปลงตำแหน่งทางการตลาด (Positioning) การอัปเดตเอกสารสำคัญ พันธมิตรสาธารณะ การประกาศผู้บริหาร และรูปแบบการจ้างงานที่สำคัญ รายการที่แน่นอนควรสอดคล้องกับการตัดสินใจที่ทีมของคุณทำจริง
เอกสารสรุปที่มีประโยชน์จะแยก สัญญาณ ออกจาก คำถาม "หน้าราคาเปลี่ยนแปลง" คือสัญญาณ "แผนบริการใหม่ทำให้คู่แข่งน่าสนใจมากขึ้นสำหรับทีมขนาดเล็กหรือไม่" คือคำถามเชิงวิเคราะห์ Agent ควรเก็บรวบรวมสัญญาณแรก และให้เหตุผลเกี่ยวกับคำถามที่สองก็ต่อเมื่อมีหลักฐานเท่านั้น
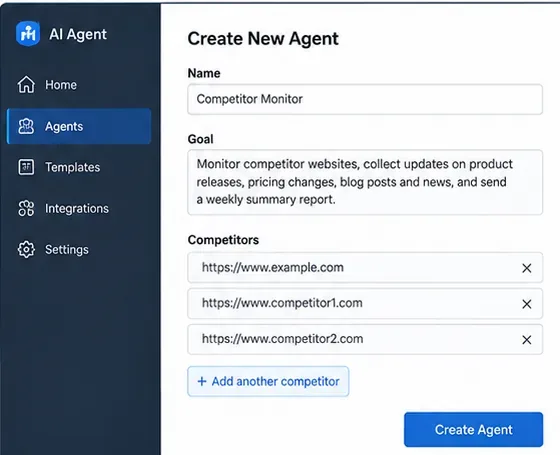
ภาพประกอบเชิงแนวคิดที่สร้างโดย AI ของเอกสารสรุปการตรวจสอบ; ไม่ใช่ภาพหน้าจอของผลิตภัณฑ์จริง สำหรับการรันรายสัปดาห์ครั้งแรก ให้เขียนประโยคหนึ่งประโยคที่นิยามความสำเร็จ ตัวอย่างเช่น: "ภายในเช้าวันจันทร์ ให้สร้างสรุปที่เชื่อมโยงแหล่งที่มาของการเปลี่ยนแปลงที่สำคัญในช่วงเจ็ดวันก่อนหน้าสำหรับคู่แข่งห้ารายที่ระบุชื่อ โดยไม่มีการกล่าวอ้างที่ไม่มีหลักฐานรองรับ" ประโยคนี้จะกลายเป็นเกณฑ์การยอมรับ (Acceptance Test) ในทางปฏิบัติในภายหลัง
ขั้นตอนที่ 2: สร้างทะเบียนแหล่งข้อมูลแทนการพึ่งพาการค้นหาแบบเปิดกว้าง
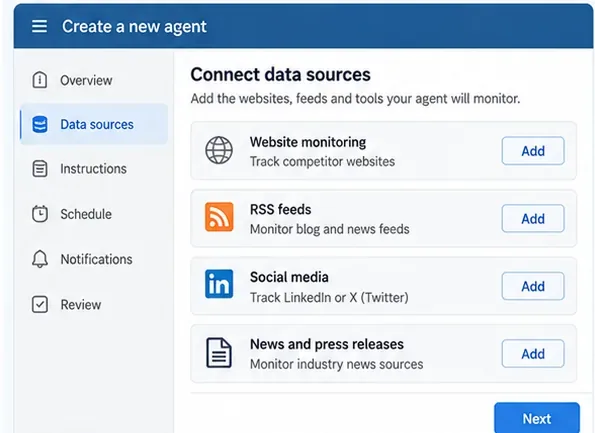
การค้นหาเว็บมีประโยชน์สำหรับการค้นพบ แต่ระบบตรวจสอบไม่ควรพึ่งพาอันดับการค้นหาเพียงอย่างเดียว สร้างทะเบียนแหล่งข้อมูลขนาดเล็กที่มีฟิลด์ต่างๆ เช่น คู่แข่ง ประเภทแหล่งข้อมูล URL ความสำคัญ ความถี่ในการอัปเดตที่คาดหวัง และคำถามที่แหล่งข้อมูลนั้นสามารถตอบได้
สัญญาณ แหล่งข้อมูลที่แนะนำ เหตุผลที่มีประโยชน์
ราคา หน้าราคาและแผนบริการอย่างเป็นทางการ แหล่งข้อมูลที่ใกล้เคียงที่สุดกับข้อเสนอทางการค้าปัจจุบัน การเปลี่ยนแปลงผลิตภัณฑ์ บันทึกการปล่อยเวอร์ชัน, Changelog, บล็อกผลิตภัณฑ์ มักให้วันที่และบริบทของฟีเจอร์ ตำแหน่งทางการตลาด หน้าแรก, หน้าผลิตภัณฑ์, หน้าแคมเปญ แสดงวิธีที่บริษัทนำเสนอผลิตภัณฑ์ ข่าวองค์กร ห้องข่าว (Press Room) และบล็อกบริษัท มีประโยชน์สำหรับพันธมิตร การระดมทุน ภาวะผู้นำ และการเปิดตัว บริบทตลาด แหล่งข่าวสาธารณะที่น่าเชื่อถือ เพิ่มบริบทที่เป็นอิสระให้กับข้อกล่าวอ้างจากแหล่งแรก
ให้เน้นหน้าเว็บสาธารณะ ฟีดอย่างเป็นทางการ API ที่มีเอกสารประกอบ และแหล่งข้อมูลที่คุณได้รับอนุญาตให้เข้าถึง อย่าออกแบบ agent ให้ข้ามการเข้าสู่ระบบ กำแพงจ่ายเงิน (Paywalls) ข้อจำกัดของ Robots หรือการควบคุมการเข้าถึง สำหรับแพลตฟอร์มโซเชียล ให้เน้น API อย่างเป็นทางการหรือฟีดสาธารณะเมื่อมีอยู่ แทนการ Scraping ที่เปราะบาง
ภาพประกอบเชิงแนวคิดที่สร้างโดย AI ของทะเบียนแหล่งข้อมูล; ใช้เฉพาะแหล่งข้อมูลที่คุณได้รับอนุญาตให้เข้าถึงเท่านั้น OpenAI Agents SDK เวอร์ชันปัจจุบันรวม WebSearchTool แบบโฮสต์สำหรับ agent ที่ใช้โมเดล OpenAI Responses เอกสารเครื่องมือทางการยังแยกความแตกต่างระหว่างการค้นหาเว็บแบบโฮสต์กับเครื่องมือฟังก์ชันในเครื่อง ซึ่งจะมีประโยชน์หากคุณต้องการให้ agent เรียกใช้ตัวดึง URL ฐานข้อมูล ตัวอ่าน RSS หรือบริการตรวจจับการเปลี่ยนแปลงของคุณเอง ดูที่ คู่มือเครื่องมือ Agents SDK ทางการ
ขั้นตอนที่ 3: กำหนด Schema หลักฐานก่อนขอให้โมเดลสรุป
วิธีที่ง่ายที่สุดในการได้รายงานรายสัปดาห์ที่ไม่สอดคล้องกันคือการขอ "สรุปข่าวคู่แข่ง" แทนที่จะทำเช่นนั้น ให้กำหนดผลการค้นพบที่มีโครงสร้าง อย่างน้อยที่สุด ทุกผลการค้นพบควรมีคู่แข่ง หมวดหมู่ วันที่สังเกตการณ์ สรุปสั้นๆ URL แหล่งที่มา ข้อความหลักฐานหรือหมายเหตุแหล่งที่มา และธงความเชื่อมั่นหรือการตรวจสอบ
เพิ่มฟิลด์สำหรับ previous_state และ current_state เมื่อสัญญาณสามารถเปรียบเทียบโดยตรงได้ เช่น ราคาแผนบริการ ความพร้อมใช้งานของฟีเจอร์ พาดหัวข่าว หรือการเชื่อมต่อที่มีเอกสารประกอบ สิ่งนี้ทำให้รายงานเน้นที่ การเปลี่ยนแปลง แทนที่จะเป็นสิ่งที่โมเดลบังเอิญพบในสัปดาห์นั้น
ผลลัพธ์ที่มีโครงสร้างยังทำให้เวิร์กโฟลว์ทดสอบได้ง่ายขึ้น Agents SDK รองรับ output_type บน agent ในปัจจุบัน และเอกสารทางการแนะนำให้ใช้ประเภท Python ปกติเช่น Pydantic models หรือ dataclasses สำหรับผลลัพธ์ที่มีโครงสร้าง ดูที่ คู่มือการกำหนดค่า agent ทางการ
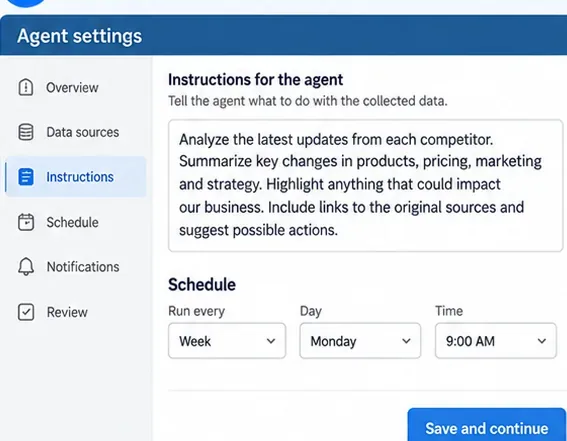
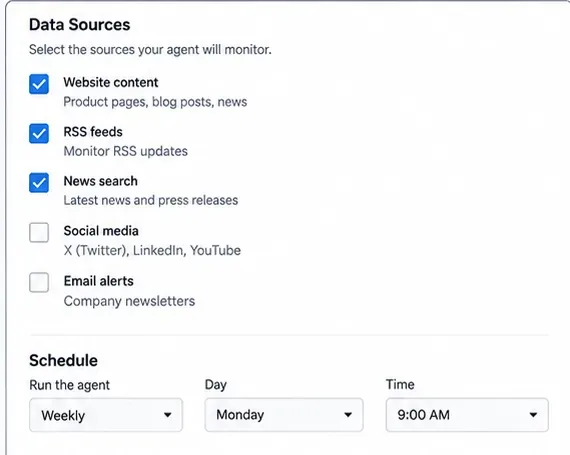
ภาพประกอบเชิงแนวคิดที่สร้างโดย AI ของคำสั่ง agent และการตั้งเวลา; ไม่ใช่ส่วนต่อประสานผลิตภัณฑ์จริง สัญญาผลลัพธ์ในทางปฏิบัติ
Finding
- competitor
- category
- observed_at
- summary
- source_url
- evidence
- previous_state
- current_state
- confidence
- needs_human_review

WeeklyReport
- period_start
- period_end
- findings[]
- executive_summary
- no_material_change_competitors[]
ฟิลด์สุดท้ายมีความสำคัญ ระบบตรวจสอบที่ดีควรสามารถระบุว่า "ไม่พบการเปลี่ยนแปลงที่สำคัญ" แทนที่จะสร้างการอัปเดตขึ้นมาเพื่อเติมช่องว่าง
ขั้นตอนที่ 4: ดำเนินการนำร่องด้วยตนเองก่อนทำระบบอัตโนมัติ
รันเวิร์กโฟลว์ด้วยตนเองสำหรับหนึ่งช่วงเวลาการรายงาน และเปรียบเทียบผลลัพธ์กับการตรวจสอบของคุณเองจากแหล่งข้อมูลเดียวกัน การนำร่องนี้เผยให้เห็นปัญหาที่ยากจะสังเกตเห็นหลังจากตั้งเวลาแล้ว: ผลการค้นหาที่ล้าสมัย ข่าวซ้ำ หมวดหมู่ที่ไม่ชัดเจน การอนุมานที่ไม่มีหลักฐานรองรับ URL แหล่งข้อมูลที่หายไป และผลการค้นพบที่ใหม่ในเชิงเทคนิคแต่ไม่เกี่ยวข้องในเชิงกลยุทธ์
สำหรับแต่ละผลการค้นพบที่เสนอ ให้ถามว่า: แหล่งที่มาเป็นแหล่งแรกหรือเป็นอิสระที่น่าเชื่อถือหรือไม่, การเปลี่ยนแปลงอยู่ในช่วงเวลาที่ตั้งใจไว้หรือไม่, ฉันสามารถชี้ไปที่หลักฐานที่แน่นอนได้หรือไม่, และรายการเดียวกันนี้จะถูกรายงานอีกครั้งในสัปดาห์หน้าหากไม่มีอะไรเปลี่ยนแปลงหรือไม่ หากคำตอบสำหรับคำถามสุดท้ายคือใช่ คุณยังต้องมีเส้นฐานหรือกฎการกำจัดข้อมูลซ้ำ
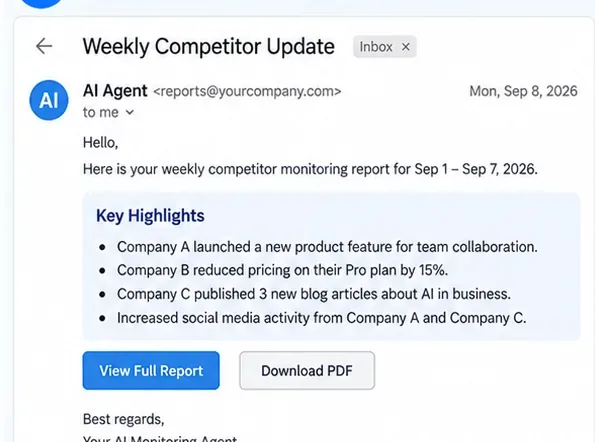
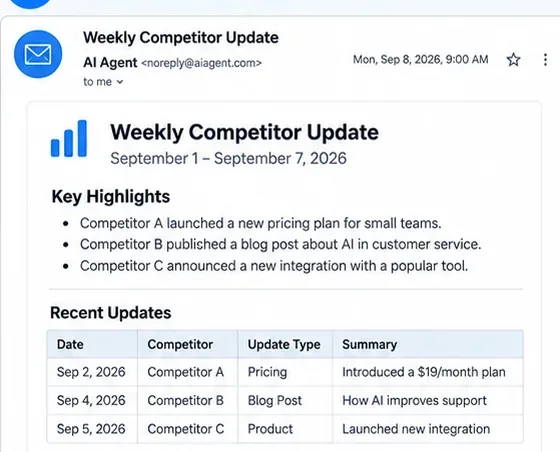
ภาพประกอบเชิงแนวคิดที่สร้างโดย AI ของรายงานการนำร่องด้วยตนเองพร้อมลิงก์หลักฐาน อย่าถือว่าข้อความสรุปจากการค้นหา (Search snippets) เป็นบันทึกหลักฐาน ให้เก็บ URL แหล่งที่มา และหากข้อกำหนดและสิทธิ์การเข้าถึงของคุณอนุญาต ให้เก็บภาพรวมแบบมาตรฐานหรือข้อความที่แยกออกมาสำหรับการเปรียบเทียบ การค้นหาควรช่วยค้นหาหลักฐาน; มันไม่ควรกลายเป็นตัวแทนของหลักฐาน
ขั้นตอนที่ 5: นำ Agent ไปใช้จริงพร้อมการค้นหาเว็บ ผลลัพธ์ที่มีโครงสร้าง และเส้นฐาน
เมื่อการนำร่องด้วยตนเองให้ผลการค้นพบที่มีประโยชน์ ให้เชื่อม agent เข้ากับโค้ด ณ เดือนกันยายน 2026 OpenAI Python Agents SDK สามารถรวม Agent, WebSearchTool แบบโฮสต์ และ output_type ที่มีโครงสร้าง ตัวอย่างต่อไปนี้ตั้งใจให้มีขนาดเล็ก: มันสาธิตชั้น agent ไม่ใช่ชั้นการจัดเก็บข้อมูล
from pydantic import BaseModel
from agents import Agent, Runner, WebSearchTool

class Finding(BaseModel):
    competitor: str
    category: str
    summary: str
    source_url: str
    evidence: str
    observed_at: str
    needs_human_review: bool

class WeeklyReport(BaseModel):
    findings: list[Finding]
    executive_summary: str

agent = Agent(
    name="Weekly competitor monitor",
    instructions=(
        "Monitor only the competitors and topics in the input. "
        "Use public web sources. Every finding must include a source URL "
        "and evidence. Prefer first-party sources for product and pricing claims. "
        "Do not invent a change when no material change is supported."
    ),
    tools=[WebSearchTool()],
    output_type=WeeklyReport,
)

result = Runner.run_sync(
    agent,
    "Review the configured competitors for the reporting window and return the report."
)

report = result.final_output
การติดตั้งแพ็กเกจและรูปแบบ Runner มีเอกสารประกอบใน คู่มือเริ่มต้น Agents SDK ทางการ SDK ยังระบุ Runner.run_sync() เป็นตัวห่อซิงโครนัสรอบการรัน agent ปกติ
ภาพประกอบเชิงแนวคิดที่สร้างโดย AI ของเวิร์กโฟลว์ agent; รายละเอียดการนำไปใช้ขึ้นอยู่กับระบบของคุณ เพิ่มการตรวจจับการเปลี่ยนแปลงแบบกำหนดได้ (Deterministic) ในจุดที่ทำได้
อย่าขอให้โมเดลค้นพบสถานะเก่าทั้งหมดจากความจำใหม่ ให้เก็บรักษาเส้นฐาน สำหรับแต่ละแหล่งข้อมูล ให้เก็บการสังเกตการณ์ที่สำเร็จล่าสุด: ข้อความแบบมาตรฐาน, แฮชเนื้อหา, ฟิลด์ที่เลือกเช่นราคาหรือชื่อแผนบริการ, เวลาที่สังเกตการณ์ และ URL แหล่งที่มา ในการรันครั้งถัดไป ให้เปรียบเทียบการสังเกตการณ์ใหม่กับเส้นฐานก่อน จากนั้นจึงให้ agent ตีความ ความแตกต่าง
การออกแบบแบบผสมผสานนี้เชื่อถือได้มากกว่า "AI เปรียบเทียบเว็บไซต์ทั้งหมดสองเว็บ" เพราะโค้ดแบบกำหนดได้จัดการการเปรียบเทียบที่แม่นยำ ในขณะที่โมเดลจัดการการจำแนกประเภท ความเกี่ยวข้อง และการอธิบาย หากหน้าเว็บเปลี่ยนเฉพาะส่วนท้ายหรือพารามิเตอร์การติดตาม ตัวมาตรฐานของคุณสามารถลบสัญญาณรบกวนนั้นออกก่อนที่ agent จะเห็น
ขั้นตอนที่ 6: ตั้งเวลาเวิร์กโฟลว์แบบรายสัปดาห์และเก็บข้อมูลรับรองให้อยู่นอกโค้ด
คุณสามารถรันตัวตรวจสอบจากตัวตั้งเวลาใดก็ได้ที่เข้ากับสภาพแวดล้อมของคุณ GitHub Actions เป็นตัวเลือกที่ปฏิบัติได้จริงสำหรับเวิร์กโฟลว์ที่อิงจาก Repository เอกสาร GitHub ปัจจุบันระบุว่าเวิร์กโฟลว์แบบตั้งเวลาใช้ไวยากรณ์ Cron แบบ POSIX รันบน Branch เริ่มต้น ใช้เวลา UTC เป็นค่าเริ่มต้น และสามารถระบุเขตเวลา IANA ได้โดยสมัครใจ GitHub ยังเตือนว่าการรันอาจล่าช้าในช่วงที่มีโหลดสูง โดยเฉพาะอย่างยิ่งในช่วงต้นชั่วโมง ดังนั้นนาทีเช่น 17 จึงดีกว่า 00 เมื่อไม่จำเป็นต้องรันตรงต้นชั่วโมงพอดี ดูที่ เอกสารการตั้งเวลา GitHub Actions ทางการ
name: weekly-competitor-monitor

on:
  schedule:
    - cron: '17 9 * * 1'
      timezone: 'America/New_York'
  workflow_dispatch:

jobs:
  monitor:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v7
      - uses: actions/setup-python@v7
        with:
          python-version: '3.12'
      - run: pip install -r requirements.txt
      - run: python monitor.py
        env:
          OPENAI_API_KEY: ${{ secrets.OPENAI_API_KEY }}
เก็บคีย์ API เป็นความลับที่เข้ารหัสแทนการส่งเข้า Repository คู่มือความลับทางการ ของ GitHub อธิบายความลับระดับ Repository, Environment และ Organization และแนะนำให้หลีกเลี่ยงการเปิดเผยโดยไม่ตั้งใจในบันทึกเวิร์กโฟลว์
ภาพประกอบเชิงแนวคิดที่สร้างโดย AI ของชั้นการตั้งเวลา; บทความใช้ GitHub Actions เป็นตัวอย่างที่เป็นรูปธรรม รายละเอียดการปฏิบัติงานหนึ่งข้อที่มักถูกมองข้าม: GitHub ระบุว่าเวิร์กโฟลว์แบบตั้งเวลาใน Repository สาธารณะจะถูกปิดใช้งานโดยอัตโนมัติหลังจาก 60 วันที่ไม่มีการใช้งาน Repository หากเวิร์กโฟลว์นี้มีความสำคัญต่อภารกิจ ให้ตรวจสอบตัวตรวจสอบ—บันทึกเวลาการรันที่สำเร็จล่าสุดและแจ้งเตือนเมื่องานรายสัปดาห์ที่คาดหวังไม่เสร็จสมบูรณ์
ขั้นตอนที่ 7: วางประตูการตรวจสอบโดยมนุษย์ระหว่าง "ผลการค้นพบ" และ "การตัดสินใจ"
การตรวจสอบคู่แข่งรายสัปดาห์เป็นเวิร์กโฟลว์แบบอ่านและสรุป ดังนั้นจึงไม่ควรเปลี่ยนราคา เผยแพร่เนื้อหา หรือเปลี่ยนแผนผลิตภัณฑ์โดยอัตโนมัติ บุคคลควรตรวจสอบข้อกล่าวอ้างที่สำคัญก่อนที่มันจะส่งผลต่อการตัดสินใจ การตรวจสอบสามารถเป็นแบบเบาๆ: อนุมัติ, ปฏิเสธ, รวมกับผลการค้นพบอื่น หรือทำเครื่องหมายว่า "จับตาดูในสัปดาห์หน้า"
ต้องการการตรวจสอบที่เข้มงวดขึ้นสำหรับหมวดหมู่ที่มีผลกระทบสูง เช่น ราคา ข้อกล่าวอ้างทางกฎหมาย เหตุการณ์ด้านความปลอดภัย การเลิกจ้าง การเข้าซื้อกิจการ หรือคำกล่าวอ้างที่พึ่งพาการรายงานจากบุคคลที่สาม สำหรับการเปลี่ยนแปลงผลิตภัณฑ์และราคา ให้เน้นหน้าเว็บของคู่แข่งเองเป็นหลักฐานหลักแม้ว่าข่าวจะช่วยให้คุณค้นพบมันก็ตาม
ภาพประกอบเชิงแนวคิดที่สร้างโดย AI ของขั้นตอนการตรวจสอบโดยมนุษย์ก่อนที่ผลการค้นพบจะถูกแบ่งปันหรือดำเนินการ หากการนำไปใช้ของคุณเพิ่มเครื่องมือที่สามารถดำเนินการในภายหลัง Agents SDK รวมกลไก Guardrails และการอนุมัติแบบ Human-in-the-loop เอกสาร Guardrails ทางการ อธิบาย Guardrails สำหรับอินพุต เอาต์พุต และเครื่องมือ ในขณะที่ คู่มือ Human-in-the-loop อธิบายการหยุดชั่วคราวสำหรับการเรียกเครื่องมือที่อ่อนไหวเพื่อรอการอนุมัติ
ขั้นตอนที่ 8: ติดตามแนวโน้ม ติดตามความล้มเหลว และตรวจสอบระบบด้วยตนเอง
รายงานรายสัปดาห์ที่มีประโยชน์จะมีคุณค่ามากขึ้นหลังจากการรันหลายครั้ง เพราะคุณสามารถแยกเหตุการณ์เดี่ยวออกจากแนวโน้มได้ เก็บผลการค้นพบที่อนุมัติแต่ละรายการในตารางหรือฐานข้อมูลอย่างง่ายที่มีคู่แข่ง หมวดหมู่ วันที่ แหล่งที่มา และสถานะการตรวจสอบ จากนั้นคุณสามารถตอบคำถามต่างๆ เช่น คู่แข่งรายใดเปลี่ยนราคาบ่อยที่สุด ธีมใดเกิดขึ้นซ้ำในบันทึกการปล่อยเวอร์ชัน หรือแหล่งข้อมูลที่ตรวจสอบใดที่ไม่ได้ให้สัญญาณที่มีประโยชน์อีกต่อไป
ภาพประกอบเชิงแนวคิดที่สร้างโดย AI ของการติดตามแนวโน้มและการตรวจสอบตนเองผ่านการรันรายสัปดาห์หลายครั้ง สำหรับตัว agent เอง ให้รักษาความสามารถในการสังเกต (Observability) OpenAI Agents SDK รวมการติดตามผลในตัวที่บันทึกการสร้างโมเดล การเรียกเครื่องมือ การส่งต่อ Guardrails และเหตุการณ์ที่กำหนดเอง คู่มือการติดตามผลทางการ อธิบายวิธีใช้ Traces และ Spans เพื่อแก้ไขข้อบกพร่องและตรวจสอบเวิร์กโฟลว์ ให้ระมัดระวังเกี่ยวกับข้อมูลอ่อนไหวเพราะ Payload ของ Trace อาจรวมถึงอินพุต/เอาต์พุตของโมเดลและเครื่องมือขึ้นอยู่กับค่าที่กำหนด
ตรวจสอบตนเองก่อนไว้วางใจรายงานรายสัปดาห์
ทุกผลการค้นพบที่สำคัญมี URL แหล่งที่มาที่ใช้งานได้และวันที่ภายในช่วงเวลาการรายงาน
ข้อกล่าวอ้างผลิตภัณฑ์และราคาจากแหล่งแรกได้รับการสนับสนุนด้วยหลักฐานจากแหล่งแรกเมื่อเป็นไปได้
ระบบเปรียบเทียบกับสถานะที่ทราบล่าสุดแทนที่จะเพียงทำซ้ำข่าวเก่า
"ไม่พบการเปลี่ยนแปลงที่สำคัญ" เป็นผลลัพธ์ที่ยอมรับได้สำหรับคู่แข่งทุกราย
ข่าวซ้ำจากหลายสำนักถูกรวมเข้าด้วยกันแทนที่จะนับเป็นการเปลี่ยนแปลงแยกกัน
งานที่ตั้งเวลามีบันทึกเวลาความสำเร็จ และการรันที่พลาดสามารถตรวจจับได้
คีย์ API และข้อมูลรับรองอื่นๆ ถูกเก็บเป็นความลับและไม่ปรากฏในบันทึกหรือรายงาน
มนุษย์ตรวจสอบผลการค้นพบที่มีผลกระทบสูงก่อนที่ทีมจะดำเนินการ
ข้อผิดพลาดทั่วไปที่ทำให้การตรวจสอบคู่แข่งด้วย AI ไม่เชื่อถือได้
ตรวจสอบผ่านคำค้นหาเท่านั้น
การค้นหาดีเยี่ยมสำหรับการค้นพบแต่ไม่เสถียรในฐานะเส้นฐานทางประวัติศาสตร์ ให้เก็บ URL แหล่งข้อมูลที่ชัดเจนและรักษาการสังเกตการณ์ก่อนหน้า
ขอให้โมเดลหา "ข่าวสำคัญ" โดยไม่มี Schema
ความสำคัญเป็นเรื่องอัตวิสัย กำหนดหมวดหมู่ ข้อกำหนดหลักฐาน และธงการตรวจสอบเพื่อให้ผลลัพธ์สามารถตรวจสอบย้อนกลับได้
ให้ agent สรุปโดยไม่มีวันที่
ผลลัพธ์อาจเกี่ยวข้องแต่เก่า ให้รวมช่วงเวลาการรายงานเสมอและกำหนดให้มีวันที่สังเกตหรือตีพิมพ์เมื่อแหล่งที่มาให้ข้อมูลนั้น
ส่งทุกสิ่งที่ค้นพบให้ผู้มีส่วนได้ส่วนเสีย
แยกการรวบรวมออกจากการรายงาน ชั้นการรวบรวมอาจพบรายการผู้สมัครจำนวนมาก; รายงานสุดท้ายควรมีเฉพาะการเปลี่ยนแปลงที่มีหลักฐานรองรับ กำจัดข้อมูลซ้ำแล้ว และตรงตามกฎความเกี่ยวข้องของคุณ
ทำระบบอัตโนมัติสำหรับการดำเนินการเร็วเกินไป
เวอร์ชันแรกที่สุดปลอดภัยคือแบบอ่านอย่างเดียว: รวบรวม เปรียบเทียบ สรุป และขอการตรวจสอบ เพิ่มการดำเนินการเขียนก็ต่อเมื่อคุณสามารถวัดผลบวกลวง (False positives) และเข้าใจโหมดความล้มเหลวได้
สถาปัตยกรรมง่ายๆ ที่คุณสามารถนำกลับมาใช้ใหม่
รูปแบบที่ยั่งยืนคือ: ทะเบียนแหล่งข้อมูล → การรวบรวม → การทำให้เป็นมาตรฐาน → การเปรียบเทียบเส้นฐาน → การวิเคราะห์โดย agent → ผลการค้นพบที่มีโครงสร้าง → การตรวจสอบโดยมนุษย์ → รายงานรายสัปดาห์ → ที่เก็บแนวโน้ม AI agent แข็งแกร่งที่สุดในขั้นตอนการตีความ ในขณะที่โค้ดปกติมักดีกว่าสำหรับการตั้งเวลาที่แม่นยำ การจัดเก็บสถานะ การแฮช การลองใหม่ และการเปรียบเทียบแบบกำหนดได้
หากเวิร์กโฟลว์ผ่านการตรวจสอบตนเองสำหรับการรันติดต่อกันหลายครั้ง คุณสามารถขยายอย่างระมัดระวัง: เพิ่มคู่แข่ง เพิ่ม agent เฉพาะทางสำหรับการเปลี่ยนแปลงราคาหรือผลิตภัณฑ์ เพิ่มฐานข้อมูล หรือส่งรายงานที่อนุมัติไปยังอีเมล Slack หรือฐานความรู้ภายในของคุณ เป้าหมายไม่ใช่การสร้าง agent ที่อัตโนมัติที่สุด แต่เป็นการสร้างระบบที่เล็กที่สุดและทำซ้ำได้ซึ่งให้ทีมของคุณทราบการเปลี่ยนแปลงของคู่แข่งที่มีหลักฐานรองรับและทันเวลาทุกสัปดาห์