คุณสามารถทำให้ชั้นการทำงานอัตโนมัติของ Pipeline สำหรับปรับใช้เนื้อหา AI เป็นแบบฟรีได้โดยการโฮสต์ n8n Community Edition ด้วยตนเอง แต่เวิร์กโฟลว์ n8n ที่ขับเคลื่อนด้วย Claude ไม่ได้รับประกันว่าจะมีต้นทุนเป็นศูนย์ตั้งแต่ต้นจนจบ ความแตกต่างนี้มีความสำคัญ n8n ระบุว่า Community Edition แบบโฮสต์ด้วยตนเองสามารถใช้งานฟรีได้ตลอดไป ในขณะที่ Claude API ของ Anthropic เป็นบริการสำหรับนักพัฒนาที่คิดค่าใช้จ่ายตามการใช้งาน แผนแชท Claude ฟรีบนเว็บไซต์ Claude ไม่เหมือนกันกับการใช้งาน API ภายใน n8n
ณ วันที่ 11 กันยายน 2026 n8n ระบุในเอกสารว่า Community Edition เป็นเวอร์ชันโฮสต์ด้วยตนเองแบบฟรีที่มีชุดฟีเจอร์หลักเกือบทั้งหมด ราคา API ปัจจุบันของ Anthropic ระบุราคา Claude Sonnet 5 ไว้ที่ $2 ต่อล้านอินพุตโทเคน และ $10 ต่อล้านเอาต์พุตโทเคน และ Claude Haiku 4.5 ที่ $1 ต่อล้านอินพุตโทเคน และ $5 ต่อล้านเอาต์พุตโทเคน ราคาและโมเดลอาจเปลี่ยนแปลงได้ ดังนั้นควรตรวจสอบก่อนนำไปใช้งานจริง ดูที่ เอกสาร Community Edition ของ n8n และ หน้าราคาปัจจุบันของ Anthropic
ดังนั้นเวอร์ชันปฏิบัติได้จริงของคำว่า “ฟรี” คือ: ซอฟต์แวร์ n8n ฟรีบนโครงสร้างพื้นฐานที่คุณควบคุม บวกกับค่าใช้จ่ายการใช้งาน Claude API ที่เวิร์กโฟลว์ของคุณสร้างขึ้นมา หากคุณมีโครงสร้างพื้นฐานและเครดิต API อยู่แล้ว ต้นทุนส่วนเพิ่มของคุณอาจเป็นศูนย์ชั่วคราว หากไม่มี ให้คาดหวังอย่างน้อยต้นทุนการใช้งานโมเดลและอาจมีต้นทุนโฮสติ้งด้วย
สิ่งที่ Pipeline นี้จะทำ
เวิร์กโฟลว์ด้านล่างจะรับรายการต้นทางหนึ่งรายการ—เช่น บทความบล็อก ร่างจดหมายข่าว ถอดความพอดแคสต์ ถอดความเว็บบินาร์ หรือบันทึกยาว ๆ—และเปลี่ยนให้เป็นร่างเนื้อหาที่มีโครงสร้างหลายรายการ ผลลัพธ์เริ่มต้นที่มีประโยชน์คือ:
โพสต์สไตล์ LinkedIn หนึ่งโพสต์
โพสต์โซเชียลสั้น ๆ สามโพสต์
หัวเรื่องอีเมลและบทนำหนึ่งชุด
ฮุกวิดีโอและสคริปต์สั้น ๆ หนึ่งชุด
ประเด็นสำคัญห้าข้อ
ธงตรวจสอบเมื่อแหล่งข้อมูลมีข้อมูลไม่เพียงพอ
Pipeline นี้ตั้งใจที่จะสร้าง ร่าง ก่อน การเผยแพร่โดยอัตโนมัติสามารถเพิ่มได้ในภายหลัง แต่โดยปกติแล้วจะปลอดภัยกว่าหากพิสูจน์คุณภาพเนื้อหา การจัดรูปแบบ ความถูกต้องตามแหล่งข้อมูล และสิทธิ์ปลายทางก่อนอนุญาตให้เวิร์กโฟลว์ AI เผยแพร่โดยไม่ต้องตรวจสอบ
แนวทางนี้เหมาะกับคุณหรือไม่?
สถานการณ์ คำแนะนำ เหตุผล
คุณปรับใช้บทความของคุณเองหรือเนื้อหาบริษัทที่อนุมัติแล้ว เหมาะมาก แหล่งข้อมูลมีการควบคุมและเป้าหมายการแปลงรูปแบบสามารถคาดเดาได้ คุณต้องการร่างที่สม่ำเสมอสำหรับหลายช่องทาง เหมาะมาก n8n สามารถจัดการการแปลงรูปแบบเดียวกันซ้ำ ๆ ได้ คุณต้องการ Claude API ที่ฟรีตลอดไป ไม่เหมาะตามที่ระบุ การใช้งาน Claude API คิดค่าใช้จ่ายตามการใช้งาน; แผนแชท Claude ฟรีไม่ได้ทำให้ระบบอัตโนมัติ API ฟรี คุณต้องมีการวิจัยข้อเท็จจริงสดเพิ่มในร่างทุกฉบับ ใช้ขั้นตอนวิจัย/ตรวจสอบแยกต่างหาก การปรับใช้เนื้อหาไม่ควรเปลี่ยนเป็นการสร้างข้อเท็จจริงโดยไม่รู้ตัว คุณกำลังประมวลผลหน้าเว็บที่ไม่เชื่อถือได้หรือเอกสารของบุคคลที่สาม เพิ่มการแยกอินพุตที่เข้มงวดขึ้นและการตรวจสอบ เนื้อหาภายนอกอาจมีคำสั่งที่ไม่ควรควบคุมเวิร์กโฟลว์ คุณต้องการการเลือกเครื่องมือที่ซับซ้อนและการตัดสินใจแบบอิสระ พิจารณา AI Agent Basic LLM Chain ง่ายกว่าเมื่องานเป็นการแปลงข้อความที่คาดเดาได้
สถาปัตยกรรมที่แนะนำ
สำหรับเวอร์ชันแรก อย่าเริ่มด้วยเอเจนต์อิสระ Basic LLM Chain ของ n8n ออกแบบมาเพื่อส่งพรอมต์ไปยังโมเดลภาษาที่เชื่อมต่อและสามารถแนบตัววิเคราะห์ผลลัพธ์ได้ ซึ่งเพียงพอสำหรับเวิร์กโฟลว์แบบกำหนดได้ “อินพุตแหล่งข้อมูล เข้า, ร่างที่จัดรูปแบบแล้ว ออก” ดูที่ เอกสาร Basic LLM Chain ของ n8n
Pipeline ที่สะอาดตาจะมีลักษณะดังนี้:
ทริกเกอร์ → ตรวจสอบอินพุต → ปรับแหล่งข้อมูลให้เป็นมาตรฐาน → Basic LLM Chain → Anthropic Chat Model → Structured Output Parser → จุดตรวจสอบ → บันทึกร่าง
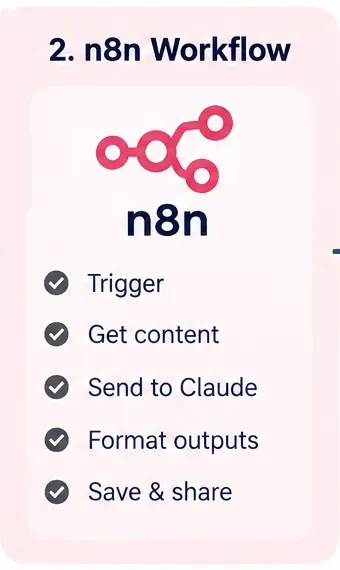
ขั้นตอนที่ 1: โฮสต์ n8n Community Edition ด้วยตนเอง
ภาพประกอบ AI ที่สร้างโดย AI ของขั้นตอนเวิร์กโฟลว์ n8n; ไม่ใช่ภาพหน้าจอ n8n จริง
เอกสารปัจจุบันของ n8n รองรับการทำ Self-hosting ด้วย Docker และอธิบายว่า Community Edition เป็นแบบฟรี Docker เป็นจุดเริ่มต้นที่ดีเพราะทำให้ตัวอย่าง n8n ง่ายต่อการทำซ้ำและให้วอลุ่มถาวรสำหรับข้อมูลเวิร์กโฟลว์และข้อมูลรับรอง
คู่มือ Docker อย่างเป็นทางการสร้างวอลุ่ม n8n_data เปิดพอร์ต 5678 ตั้งค่าตัวแปรสภาพแวดล้อมที่เกี่ยวข้องกับเขตเวลา และเมานต์ไดเรกทอรีข้อมูลถาวร สำหรับ n8n เวอร์ชัน 2.x เอกสารระบุว่า N8N_RUNNERS_ENABLED ถูกเลิกใช้แล้วและไม่จำเป็นต้องตั้งค่าอีกต่อไป ใช้คำสั่งปัจจุบันจาก คู่มือการติดตั้ง n8n ด้วย Docker แทนการคัดลอกคำสั่งเก่าจากบทเรียน
สำหรับการพิสูจน์แนวคิดในเครื่อง การเปิด http://localhost:5678 ก็เพียงพอ สำหรับอินสแตนซ์การผลิตที่เชื่อมต่อกับอินเทอร์เน็ต อย่าเปิดพอร์ตในเครื่องสู่สาธารณะโดยตรง ให้ปฏิบัติตามคำแนะนำด้านโฮสติ้งและความปลอดภัยของ n8n สำหรับ HTTPS การตรวจสอบสิทธิ์ การสำรองข้อมูล และการกำหนดค่า Reverse-proxy
ใช้ขั้นตอนนี้ถ้า: คุณสบายใจกับการดูแลโฮสต์ Docker ของคุณเอง หากคุณไม่ต้องการแพตช์ รักษาความปลอดภัย สำรองข้อมูล และตรวจสอบเซิร์ฟเวอร์ n8n Cloud จะง่ายกว่า แต่ไม่ใช่ตัวเลือกฟรีตลอดไปตามที่อธิบายไว้ที่นี่
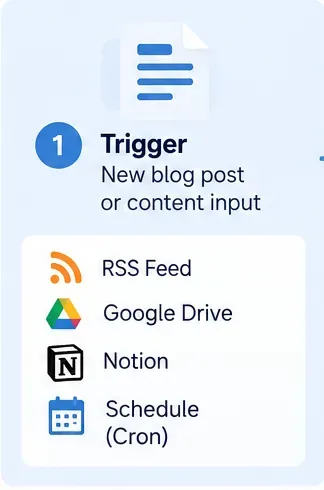
ขั้นตอนที่ 2: เลือกวิธีที่เวิร์กโฟลว์เริ่มต้น
ภาพประกอบ AI ที่สร้างโดย AI ของทริกเกอร์เวิร์กโฟลว์และแหล่งเนื้อหาที่เป็นไปได้; ความพร้อมใช้งานและการกำหนดค่าโหนด n8n จริงควรตรวจสอบในอินสแตนซ์ของคุณ
ใช้ Webhook เมื่อแอปอื่นควรส่งเนื้อหาไปยัง n8n ตามต้องการ ใช้ Schedule Trigger เมื่อ n8n ควรตรวจสอบเนื้อหาในเวลาหรือช่วงเวลาที่กำหนด
โหนด Webhook ของ n8n มี URL สำหรับทดสอบและสำหรับใช้งานจริงแยกกัน URL สำหรับทดสอบออกแบบมาสำหรับการพัฒนา; URL สำหรับใช้งานจริงจะลงทะเบียนเมื่อเผยแพร่เวิร์กโฟลว์ โหนด Webhook ยังรองรับตัวเลือกการตรวจสอบสิทธิ์ รวมถึง Basic auth, Header auth และ JWT auth ดูที่ เอกสาร Webhook ของ n8n
สำหรับการปรับใช้เนื้อหาตามกำหนดการ Schedule Trigger ของ n8n จะทำงานในเวลาหรือช่วงเวลาที่กำหนด และ n8n ระบุว่าเวิร์กโฟลว์ต้องถูกบันทึกและเผยแพร่เพื่อการทริกเกอร์ตามกำหนดการ ดูที่ เอกสาร Schedule Trigger ของ n8n
ตัวอย่าง: หาก CMS ของคุณสามารถเรียก Webhook หลังจากบรรณาธิการอนุมัติบทความ ให้ใช้ Webhook หากคุณเก็บเนื้อหาแหล่งข้อมูลที่อนุมัติแล้วในโฟลเดอร์และต้องการชุดงานทุกเช้าวันธรรมดา ตารางเวลาอาจง่ายกว่า
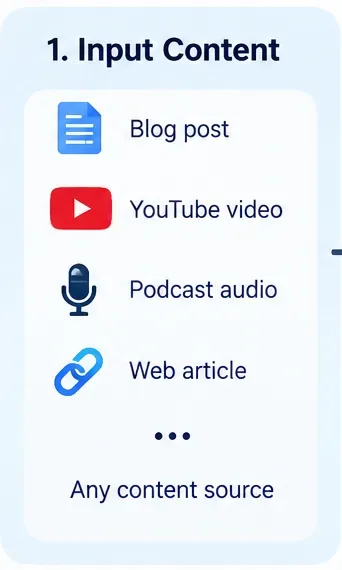
ขั้นตอนที่ 3: กำหนดสัญญาอินพุตที่สะอาดตาหนึ่งชุด
ภาพประกอบ AI ที่สร้างโดย AI ของประเภทเนื้อหาแหล่งข้อมูลที่สามารถป้อนเข้าสู่เวิร์กโฟลว์การปรับใช้; ไม่ได้แสดงหน้าจอ n8n จริง
อย่าปล่อยให้แหล่งข้อมูลทุกแหล่งมาในรูปแบบที่แตกต่างกัน ปรับอินพุตให้เป็นโครงสร้างภายในหนึ่งชุดก่อนเรียก Claude เพย์โหลด JSON ที่ใช้งานจริงคือ:
{
  "source_id": "post-2026-0911-001",
  "title": "Original article title",
  "source_text": "Full approved source text...",
  "source_url": "https://example.com/original",
  "audience": "US small-business owners",
  "brand_voice": "clear, practical, non-hype",
  "outputs": [
    "linkedin_post",
    "short_posts",
    "email_intro",
    "video_script"
  ]
}
ส่งข้อความแหล่งข้อมูลจริง whenever เป็นไปได้ URL เพียงอย่างเดียวไม่เหมือนกับเนื้อหาแหล่งข้อมูลที่ตรวจสอบแล้ว การดึงและวิเคราะห์หน้าเว็บเพิ่มจุดล้มเหลวอีกจุดหนึ่งและอาจนำการนำทาง คุกกี้ โฆษณา หรือข้อความที่ไม่เกี่ยวข้องเข้าสู่พรอมต์
นอกจากนี้ให้แยกคำสั่งออกจากเนื้อหาแหล่งข้อมูล หากคุณนำเข้าหน้าเว็บ อีเมล หรือเอกสารที่อัปโหลดของบุคคลที่สาม ให้ปฏิบัติต่อเนื้อหาเหล่านั้นเป็นข้อมูลที่ไม่น่าเชื่อถือมากกว่าคำสั่งเวิร์กโฟลว์ คำแนะนำด้านความปลอดภัยของ Anthropic อธิบายอย่างชัดเจนเกี่ยวกับการฉีดพรอมต์ทางอ้อมว่าเป็นคำสั่งที่เป็นอันตรายซึ่งฝังอยู่ในเนื้อหาที่โมเดลอ่าน ดูที่ คำแนะนำการลดผลกระทบจากการฉีดพรอมต์ของ Anthropic
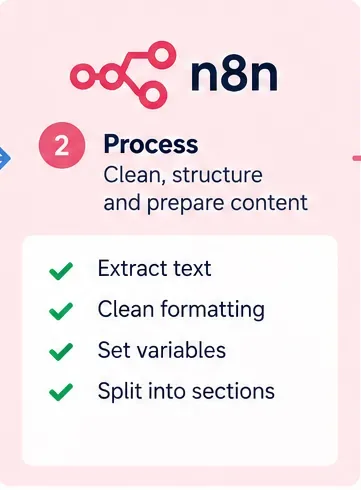
ขั้นตอนที่ 4: ตรวจสอบและปรับให้เป็นมาตรฐานก่อนเรียกโมเดล
ภาพประกอบ AI ที่สร้างโดย AI ของขั้นตอนการประมวลผลล่วงหน้า; ไม่ใช่ภาพหน้าจอเวิร์กโฟลว์ n8n จริง
ก่อนใช้โทเคน ให้ปฏิเสธอินพุตที่ไม่ดี อย่างน้อยที่สุด ให้ตรวจสอบว่า source_id, title และ source_text มีอยู่และว่า source_text ไม่ว่าง ปรับสัญญาณรบกวนการจัดรูปแบบที่ชัดเจนให้เป็นมาตรฐาน แต่รักษาข้อเท็จจริง คำพูด URL หัวข้อ และรายละเอียดแหล่งข้อมูลอื่น ๆ ที่ Claude อาจต้องการ
ขั้นตอนการประมวลผลล่วงหน้าที่มีประโยชน์สามารถ:
ตัดช่องว่างด้านหน้าและด้านหลังออก
แปลงบรรทัดว่างซ้ำ ๆ เป็นรูปแบบที่สม่ำเสมอ
ตั้งค่าค่าเริ่มต้นสำหรับผู้ชมและน้ำเสียง
ปฏิเสธข้อความแหล่งข้อมูลที่ต่ำกว่าความยาวขั้นต่ำที่มีประโยชน์
สร้าง source_id ที่เสถียรสำหรับการกำจัดข้อมูลซ้ำ
บันทึกประเภทผลลัพธ์ที่ขอ
อย่าแบ่งบทความปกติออกเป็นหลายการเรียกโมเดลเว้นแต่คุณจำเป็นต้องทำจริง ๆ หลายการเรียกเพิ่มความซับซ้อนในการจัดการและอาจทำให้น้ำเสียงไม่สม่ำเสมอ สำหรับแหล่งข้อมูลขนาดใหญ่ ให้พิจารณาสรุปหรือแบ่งส่วนอย่างจงใจแทนที่จะตัดอินพุตโดยไม่ได้ตั้งใจ
ขั้นตอนที่ 5: เชื่อมต่อ Claude อย่างถูกต้อง—และเข้าใจต้นทุน
ภาพประกอบ AI ที่สร้างโดย AI ของบทบาทของ Claude ในเวิร์กโฟลว์; ไม่ใช่ภาพหน้าจอ Anthropic Console หรือ n8n
n8n มีโหนด Anthropic Chat Model และข้อมูลรับรอง Anthropic ที่ใช้ API key เอกสารข้อมูลรับรองของ n8n ชี้แนะให้ผู้ใช้สร้างคีย์ใน Anthropic Console และเก็บไว้ในข้อมูลรับรอง n8n แทนที่จะฮาร์ดโค้ดในข้อความเวิร์กโฟลว์ ดูที่ เอกสารข้อมูลรับรอง Anthropic ของ n8n และ เอกสาร Anthropic Chat Model ของ n8n
สำหรับ Pipeline นี้ ให้เชื่อมต่อ Anthropic Chat Model กับ Basic LLM Chain การเลือกโมเดลที่ใช้งานจริงขึ้นอยู่กับเป้าหมายคุณภาพและต้นทุนของคุณ:
การเลือกโมเดล เมื่อใดที่สมเหตุสมผล ราคา API ปัจจุบันที่ตรวจสอบเมื่อ 11 ก.ย. 2026
Claude Haiku 4.5 การเขียนใหม่และร่างแรกที่มีปริมาณสูงและเรียบง่าย $1/MTok อินพุต; $5/MTok เอาต์พุต Claude Sonnet 5 ค่าเริ่มต้นที่แข็งแกร่งกว่าสำหรับการปรับใช้หลายรูปแบบที่มีรายละเอียด $2/MTok อินพุต; $10/MTok เอาต์พุต Claude Opus 5 เฉพาะเมื่องานต้องการการให้เหตุผลที่ลึกซึ้งจริง ๆ $5/MTok อินพุต; $25/MTok เอาต์พุต
ราคาข้างต้นมาจากหน้าราคาปัจจุบันของ Anthropic และอาจเปลี่ยนแปลงได้ นอกจากนี้ หลีกเลี่ยงการคัดลอก ID โมเดลเก่าจากบทเรียนเก่า ๆ Anthropic รักษาหน้าการเลิกใช้โมเดลเพราะโมเดลถูกเลิกใช้และปลดระวางเป็นระยะ ตรวจสอบ เอกสารการเลิกใช้โมเดลของ Anthropic ก่อนฮาร์ดโค้ดชื่อโมเดล
ขั้นตอนที่ 6: ใช้พรอมต์เดียวที่รักษาความถูกต้องตามแหล่งข้อมูล
ภาพประกอบ AI ที่สร้างโดย AI ของการสร้างเนื้อหาหลายรูปแบบ; ผลลัพธ์ที่ระบุเป็นตัวอย่าง ไม่ใช่คุณสมบัติผลิตภัณฑ์ที่รับประกัน
พรอมต์ควรทำให้ขอบเขตการแปลงรูปแบบชัดเจน: Claude อาจปรับกรอบและย่อแหล่งข้อมูล แต่ไม่ควรสร้างข้อเท็จจริงที่ไม่มีอยู่ คำแนะนำการเขียนพรอมต์ปัจจุบันของ Anthropic แนะนำให้มีคำสั่งที่ชัดเจนและแท็กที่มีโครงสร้างสำหรับอินพุตที่ซับซ้อน ดูที่ เอกสารแนวปฏิบัติที่ดีที่สุดในการเขียนพรอมต์ของ Anthropic
ข้อความระบบที่ใช้งานจริงคือ:
You are a content repurposing editor.
Use only factual claims supported by the supplied source.
Do not invent statistics, quotes, customer results, dates, or product capabilities.
Preserve the original meaning while adapting format and tone.
If an output requires information not present in the source, set needs_review to true
and explain the missing information in review_notes.
Return the requested structured fields only.
จากนั้นสร้างข้อความผู้ใช้จากนิพจน์ n8n:
<source>
<title>{ $json.title }</title>
<text>{ $json.source_text }</text>
<source_url>{ $json.source_url }</source_url>
</source>

<requirements>
Audience: { $json.audience }
Voice: { $json.brand_voice }
Create only the requested formats: { JSON.stringify($json.outputs) }
</requirements>
ตัวอย่าง: หากแหล่งข้อมูลระบุว่าผลิตภัณฑ์เปิดตัวในเดือนพฤษภาคมแต่ไม่เคยให้ตัวเลขลูกค้า Claude อาจเปลี่ยนข้อเท็จจริงการเปิดตัวเป็นโพสต์ที่สั้นลง แต่ไม่ควรเพิ่ม “ลูกค้า 10,000 ราย” เพื่อให้โพสต์ดูแข็งแกร่งขึ้น
ขั้นตอนที่ 7: บังคับผลลัพธ์ที่มีโครงสร้างแทนการวิเคราะห์ข้อความ
ภาพประกอบ AI ที่สร้างโดย AI ของผลลัพธ์เนื้อหาที่มีโครงสร้าง; ไม่ใช่ภาพหน้าจอการตอบสนอง API ของ Claude
ข้อความอิสระจัดการเส้นทางได้ยาก หาก Claude ส่งคืนหัวข้อที่เปลี่ยนจากการดำเนินการหนึ่งไปยังอีกการดำเนินการหนึ่ง โหนดปลายทางจะเปราะบาง Structured Output Parser ของ n8n สามารถส่งคืนฟิลด์ตาม JSON Schema และ Basic LLM Chain สามารถกำหนดรูปแบบผลลัพธ์เฉพาะได้ ดูที่ เอกสาร Structured Output Parser ของ n8n
ใช้สคีมาเช่น:
{
  "type": "object",
  "properties": {
    "linkedin_post": { "type": "string" },
    "short_posts": {
      "type": "array",
      "items": { "type": "string" },
      "minItems": 3,
      "maxItems": 3
    },
    "email_subject": { "type": "string" },
    "email_intro": { "type": "string" },
    "video_hook": { "type": "string" },
    "video_script": { "type": "string" },
    "key_takeaways": {
      "type": "array",
      "items": { "type": "string" }
    },
    "needs_review": { "type": "boolean" },
    "review_notes": {
      "type": "array",
      "items": { "type": "string" }
    }
  },
  "required": [
    "linkedin_post",
    "short_posts",
    "email_subject",
    "email_intro",
    "video_hook",
    "video_script",
    "key_takeaways",
    "needs_review",
    "review_notes"
  ],
  "additionalProperties": false
}
หากคุณเลือกเรียก Claude Messages API โดยตรงด้วยโหนด HTTP Request ของ n8n แทนการใช้การรวม Anthropic Chat Model Anthropic ยังรองรับผลลัพธ์ที่มีโครงสร้างแบบเนทีฟผ่าน output_config.format บนโมเดลที่รองรับ ดูที่ เอกสาร Structured Outputs ของ Anthropic และ อ้างอิง Claude Messages API
ขั้นตอนที่ 8: บันทึกร่าง ตรวจสอบ จากนั้นจึงทำให้การเผยแพร่เป็นอัตโนมัติ
ภาพประกอบ AI ที่สร้างโดย AI ของปลายทางร่าง; ไม่ใช่ภาพหน้าจอของการเชื่อมต่อแบบเรียลไทม์หรือหลักฐานว่าบัญชีใด ๆ เชื่อมต่ออยู่
สำหรับเวอร์ชันการผลิตแรก ให้เก็บฟิลด์ที่สร้างขึ้นในตำแหน่งตรวจสอบแทนที่จะส่งไปยังช่องทางสาธารณะโดยตรง ปลายทางทั่วไปรวมถึงฐานข้อมูล Google Drive Google Sheets Notion ร่าง CMS หรือข้อความตรวจสอบภายใน
ใช้ needs_review เป็นจุดตรวจสอบที่เข้มงวด นอกจากนี้ให้พิจารณาขั้นตอนการตรวจสอบโดยมนุษย์สำหรับสิ่งใดก็ตามที่ส่งข้อความภายนอกหรือเปลี่ยนระบบการผลิต n8n รองรับปัจจุบันสำหรับการอนุมัติแบบมีมนุษย์ในลูปสำหรับการเรียกเครื่องมือ AI ซึ่งผู้ตรวจสอบสามารถอนุมัติหรือปฏิเสธการกระทำที่เลือกได้ ดูที่ เอกสาร human-in-the-loop ของ n8n
การเปิดตัวที่แนะนำ:
สัปดาห์ที่ 1: สร้างร่างเท่านั้น
สัปดาห์ที่ 2: เปรียบเทียบผลลัพธ์กับแหล่งข้อมูลและแก้ไขความล้มเหลวของพรอมต์/สคีมา
สัปดาห์ที่ 3: อนุญาตให้ร่างที่อนุมัติแล้วเคลื่อนย้ายไปยังโฟลเดอร์ร่างปลายทางโดยอัตโนมัติ
หลังจากเวิร์กโฟลว์เสถียรเท่านั้น: พิจารณาการเผยแพร่โดยอัตโนมัติสำหรับรูปแบบที่มีความเสี่ยงต่ำ
เวิร์กโฟลว์ n8n แบบครบวงจรที่เป็นรูปธรรม
สำหรับเวอร์ชันที่ขับเคลื่อนด้วย Webhook อย่างง่าย ให้สร้างโหนดเหล่านี้ตามลำดับ:
# โหนด วัตถุประสงค์
1 Webhook รับรายการแหล่งข้อมูลที่อนุมัติแล้ว 2 Edit Fields / Code ปรับชื่อฟิลด์และค่าเริ่มต้นให้เป็นมาตรฐาน 3 If ปฏิเสธข้อความแหล่งข้อมูลที่ขาดหายหรือว่างเปล่า 4 Basic LLM Chain เก็บคำแนะนำการปรับใช้และเนื้อหาแหล่งข้อมูลแบบไดนามิก 5 Anthropic Chat Model สร้างร่างที่ปรับใช้แล้ว 6 Structured Output Parser บังคับใช้ฟิลด์ JSON ที่เสถียร 7 If ส่งเส้นทาง needs_review=true ไปยังการตรวจสอบด้วยตนเอง 8 โหนดปลายทาง บันทึกผลลัพธ์ที่อนุมัติแล้วเป็นร่าง 9 Respond to Webhook ส่งคืนสถานะและ ID บันทึกที่สร้างขึ้นไปยังผู้เรียก
หากคุณชอบ Pipeline แบบกำหนดการ ให้แทนที่ Webhook ด้วย Schedule Trigger และเพิ่มโหนดแหล่งข้อมูลที่ดึงรายการที่อนุมัติแล้วและยังไม่ประมวลผล
วิธีหลีกเลี่ยงการปรับใช้แหล่งข้อมูลเดียวกันสองครั้ง
เพิ่ม source_id ที่ไม่สามารถแก้ไขได้ลงในทุกรายการและเก็บ ID ที่ประมวลผลแล้ว ก่อนที่ Claude จะทำงาน ให้ตรวจสอบว่า ID นั้นเสร็จสมบูรณ์เรียบร้อยแล้วหรือไม่ นี่คือ Idempotency พื้นฐาน: การทำทริกเกอร์ซ้ำไม่ควรสร้างร่างซ้ำเว้นแต่คุณขอเวอร์ชันใหม่อย่างชัดเจน
สำหรับการแก้ไข ให้ใช้คีย์ผสมเช่น source_id + source_revision ซึ่งช่วยให้เวอร์ชัน 2 ของบทความสร้างร่างใหม่ได้โดยไม่แกล้งทำว่าเป็นแหล่งข้อมูลเดียวกับเวอร์ชัน 1
วิธีลดต้นทุน Claude API
การเลือกโมเดลเป็นเพียงคันโยกหนึ่งตัว ต้นทุนที่หลีกเลี่ยงได้มากที่สุดมักเป็นการส่งข้อความที่ไม่จำเป็นหรือสร้างผลลัพธ์ที่ยาวเกินจำเป็น
ลบการนำทาง ข้อความมาตรฐาน และ HTML ที่ไม่เกี่ยวข้องก่อนเรียกโมเดล
ขอเฉพาะรูปแบบที่คุณต้องการจริง ๆ
ตั้งข้อจำกัดความยาวผลลัพธ์ที่สมเหตุสมผลในพรอมต์
ใช้ Haiku 4.5 สำหรับการแปลงที่มีปริมาณสูงและเรียบง่ายเมื่อคุณภาพเพียงพอ
ใช้ Sonnet 5 เมื่อแหล่งข้อมูลต้องการรายละเอียดมากขึ้นหรือการปรับตัวข้ามรูปแบบที่แข็งแกร่งขึ้น
อย่าส่งคู่มือแบรนด์ยาว ๆ เดิมในทุกการเรียกหากคุณสามารถแสดงด้วยคำสั่งที่กระชับและเสถียร
วัดการใช้งานโทเคนและต้นทุนแทนที่จะสมมติว่าเวิร์กโฟลว์สั้น ๆ มีราคาถูก
Anthropic ยังเสนอการแคชพรอมต์และการประมวลผลแบบแบทช์สำหรับเวิร์กโหลดที่ใช้ได้ แต่ฟีเจอร์เหล่านี้มีข้อกำหนดและราคาของตัวเอง อย่าเพิ่มลงในเวิร์กโฟลว์แรกเว้นแต่บริบทที่ซ้ำกันหรือการประมวลผลที่มีปริมาณสูงและไม่เร่งด่วนทำให้ความซับซ้อนเพิ่มเติมคุ้มค่า
โหมดความล้มเหลวสามประการที่ต้องทดสอบก่อนเผยแพร่
1. ข้อเท็จจริงที่ถูกสร้างขึ้นมา (Hallucinated facts)
ป้อนเวิร์กโฟลว์ด้วยแหล่งข้อมูลที่จงใจละเว้นสถิติ พฤติกรรมที่คาดหวังคือผลลัพธ์ไม่สร้างสถิติขึ้นมา หากมันสร้าง ให้เสริมคำแนะนำความถูกต้องตามแหล่งข้อมูลและจุดตรวจสอบ
2. ผลลัพธ์ที่มีโครงสร้างเสียหาย
ทดสอบทุกฟิลด์ที่จำเป็น อาร์เรย์ว่าง ข้อความแหล่งข้อมูลที่ผิดปกติยาว และอักขระพิเศษ Pipeline ไม่เชื่อถือได้เพียงเพราะผลลัพธ์เดโมที่ดึงดูดใจหนึ่งชิ้นดูเหมือนถูกต้อง
3. การดำเนินการซ้ำ
ส่ง source_id เดิมสองครั้ง การรันครั้งที่สองควรหยุด อัปเดตบันทึกที่มีอยู่ หรือสร้างการแก้ไขอย่างจงใจตามการออกแบบของคุณ—ไม่ใช่ทำซ้ำร่างทั้งหมดโดยไม่รู้ตัว
คุณต้องการ AI Agent สำหรับสิ่งนี้หรือไม่?
โดยปกติแล้ว ไม่ AI Agent มีประโยชน์เมื่อโมเดลต้องตัดสินใจว่าจะเรียกเครื่องมือใดหรือดำเนินการต่าง ๆ ตามวัตถุประสงค์ที่เปิดกว้าง การปรับใช้เนื้อหาโดยปกติเป็นการแปลงรูปแบบที่คาดเดาได้ ดังนั้นเชนจึงง่ายต่อการตรวจสอบ ทดสอบ และควบคุม
เปลี่ยนไปใช้เอเจนต์เมื่อคุณมีความต้องการที่เป็นรูปธรรมเช่นการเลือกเครื่องมือวิจัยแบบไดนามิก การตัดสินใจว่าปลายทางใดได้รับร่าง หรือการถามมนุษย์สำหรับข้อมูลที่ขาดหาย แม้ในกรณีนั้น ให้เก็บการดำเนินการเผยแพร่ที่ไม่สามารถย้อนกลับไว้เบื้องหลังการตรวจสอบอย่างชัดเจนจนกว่าเวิร์กโฟลว์จะทดสอบอย่างดี
รายการตรวจสอบการสร้างขั้นสุดท้าย
โฮสต์ n8n Community Edition ด้วยตนเองหากคุณต้องการให้ชั้นซอฟต์แวร์ n8n ยังคงฟรี
อย่าอธิบายการใช้งาน Claude API ว่าฟรีตลอดไป
ใช้ Webhook สำหรับการประมวลผลตามต้องการหรือ Schedule Trigger สำหรับแบทช์ตามเวลา
ปรับแหล่งข้อมูลทุกแหล่งให้เป็นสัญญาอินพุตหนึ่งชุด
ส่งข้อความแหล่งข้อมูล ไม่ใช่แค่ URL
เก็บ Anthropic API key ในข้อมูลรับรอง n8n
ใช้โมเดล Claude ที่ใช้งานอยู่และตรวจสอบหน้าการเลิกใช้เป็นระยะ
ใช้ Basic LLM Chain สำหรับการปรับใช้ที่คาดเดาได้
กำหนดให้ต้องมีสคีมาผลลัพธ์ที่มีโครงสร้าง
เพิ่ม needs_review และหมายเหตุการตรวจสอบลงในสคีมา
กำจัดข้อมูลซ้ำด้วย ID แหล่งข้อมูลที่เสถียร
บันทึกร่างก่อนเปิดใช้งานการเผยแพร่โดยอัตโนมัติ
ทดสอบการสร้างข้อเท็จจริง อินพุตที่ไม่ถูกต้อง ทริกเกอร์ซ้ำ และเส้นทางความล้มเหลว
ตรวจสอบการใช้งานโทเคนและต้นทุนบริการภายนอก
เวอร์ชันแรกที่ดีที่สุดนั้นน่าเบื่อโดยเจตนา: อินพุตสะอาดหนึ่งชุด การเรียก Claude ที่ควบคุมหนึ่งครั้ง การตอบสนอง JSON ที่ตรวจสอบแล้วหนึ่งครั้ง และปลายทางร่างหนึ่งชุด สถาปัตยกรรมนั้นง่ายต่อการดีบักและดำเนินการได้ราคาถูก เมื่อมันทำงานได้อย่างเชื่อถือได้บนเนื้อหาแหล่งข้อมูลจริง คุณสามารถเพิ่มช่องทาง การกำหนดการ อนุมัติโดยมนุษย์ การวิเคราะห์ หรือการรวมการเผยแพร่ได้โดยไม่ต้องสร้าง Pipeline หลักใหม่