ใช่—you สามารถรัน DeepSeek แบบออฟไลน์ได้อย่างสมบูรณ์บน Windows 11 ด้วย LM Studio แต่คุณต้องทำการตั้งค่าออนไลน์หนึ่งครั้งก่อน ติดตั้ง LM Studio ดาวน์โหลดโมเดล DeepSeek ที่รองรับและรันไทม์ที่จำเป็น โหลดโมเดลหนึ่งครั้ง จากนั้นคุณจึงสามารถตัดการเชื่อมต่ออินเทอร์เน็ตได้ เอกสารทางการของ LM Studio ระบุว่า การแชทกับโมเดลที่ดาวน์โหลดแล้ว การแชทกับเอกสารโลคัล และการรันเซิร์ฟเวอร์โลคัล ไม่จำเป็นต้องมีการเชื่อมต่ออินเทอร์เน็ต
สำหรับพีซี Windows 11 ทั่วไป จุดเริ่มต้นที่ใช้งานได้จริงที่สุดไม่ใช่โมเดล DeepSeek ที่ใหญ่ที่สุดในปัจจุบัน โมเดล GGUF ที่มีขนาดเล็กกว่า เช่น DeepSeek-R1-0528-Qwen3-8B ใช้งานแบบโลคัลได้ง่ายกว่ามาก LM Studio ได้ประกาศรองรับโมเดลกลั่นขนาด 8B นี้ในเดือนพฤษภาคม 2025 และระบุว่าทำงานในรูปแบบ GGUF กับ LM Studio เวอร์ชัน 0.3.16 ขึ้นไป ในทางตรงกันข้าม แนวทางของ LM Studio ในเดือนสิงหาคม 2026 สำหรับ DeepSeek V4 Flash ระบุว่าการใช้งานแบบโลคัลต้องใช้ หน่วยความจำระบบประมาณ 156GB ซึ่งทำให้ V4 Flash เป็นตัวเลือกที่ไม่ดีสำหรับเครื่อง Windows ส่วนใหญ่ของผู้บริโภค แม้ว่าจะใหม่กว่าและมีความสามารถมากกว่าก็ตาม
คู่มือนี้ได้รับการตรวจสอบเมื่อวันที่ 11 กันยายน 2026 บันทึกการเปลี่ยนแปลงของ LM Studio ระบุเวอร์ชัน 0.4.24 ลงวันที่ 9 กันยายน 2026 เนื่องจากอินเทอร์เฟซของ LM Studio มีการพัฒนา ปุ่มอาจเคลื่อนที่เล็กน้อยระหว่างเวอร์ชัน แต่ขั้นตอนการทำงานหลัก—ดาวน์โหลดโมเดล โหลดโมเดล แชทแบบโลคัล และเปิดใช้ API บน localhost (ถ้าต้องการ)—ยังคงได้รับการบันทึกโดย LM Studio
ก่อนเริ่ม: พีซี Windows 11 ของคุณเหมาะสมหรือไม่?
LM Studio รองรับทั้งพีซี Windows แบบ x64 และระบบ Windows แบบ ARM สำหรับ x64 โปรเซสเซอร์ต้องรองรับ AVX2 LM Studio แนะนำให้มี RAM อย่างน้อย 16GB และ VRAM แบบเฉพาะอย่างน้อย 4GB คำแนะนำเหล่านี้เป็นระดับแอปพลิเคชัน ไม่ใช่คำรับประกันว่าทุกโมเดลจะพอดี ขนาดโมเดล การควอนไทซ์ ความยาวบริบท และการโอนโหลดไปยัง GPU ล้วนส่งผลต่อการใช้หน่วยความจำ
สิ่งที่คุณมี
คำแนะนำที่ใช้งานได้จริง
เหตุผล
RAM 16GB, GPU ระดับกลางหรือกราฟิกแบบรวม
เริ่มด้วยโมเดล DeepSeek กลั่นขนาด 8B หรือเล็กกว่าในรูปแบบ GGUF แบบ 4-bit
ช่วยให้ขนาดโมเดลจัดการได้ง่ายขึ้นในขณะที่ยังคงความสามารถในการให้เหตุผลที่มีประโยชน์ไว้ได้
RAM มากกว่าและ GPU ที่ทรงพลังกว่า
ลองใช้เวอร์ชันกลั่นที่ใหญ่ขึ้นหลังจากตรวจสอบการประมาณความพอดีของอุปกรณ์ใน LM Studio แล้วเท่านั้น
โมเดลที่ใหญ่ขึ้นอาจปรับปรุงคุณภาพแต่ใช้หน่วยความจำมากขึ้นอย่างมากและอาจช้ากว่ามาก
พีซีเกมมิ่งหรือแล็ปท็อปทั่วไป
อย่าเริ่มด้วย DeepSeek V4 Flash
LM Studio ระบุว่าโมเดล V4 Flash แบบโลคัลต้องใช้หน่วยความจำระบบอย่างน้อย 156GB
เอกสารการดาวน์โหลดโมเดลของ LM Studio อธิบายว่าการสร้างแบบควอนไทซ์แลกเปลี่ยนความถูกต้องบางส่วนเพื่อไฟล์ที่เล็กลงและแรงกดดันต่อหน่วยความจำที่ลดลง คำแนะนำทั่วไปคือให้เลือก ตัวเลือก 4-bit ขึ้นไป เมื่อฮาร์ดแวร์ของคุณรองรับได้ หากคุณไม่แน่ใจ เวอร์ชัน GGUF แบบ 4-bit เป็นการทดสอบแรกที่เหมาะสม
อ้างอิงทางการ: ข้อกำหนดระบบของ LM Studio , คู่มือการดาวน์โหลดโมเดลของ LM Studio และ บันทึกการเปลี่ยนแปลงของ LM Studio
ขั้นตอนที่ 1: ติดตั้ง LM Studio บน Windows 11
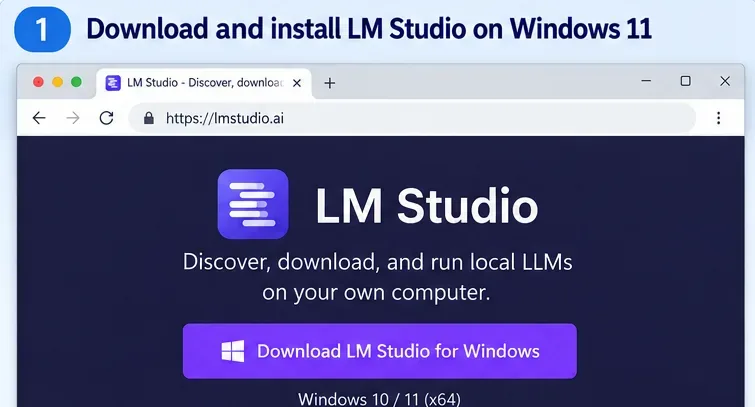
ดาวน์โหลดเวอร์ชันเสถียรปัจจุบันสำหรับ Windows จาก หน้าดาวน์โหลด LM Studio อย่างเป็นทางการ ใช้ตัวติดตั้งที่ตรงกับสถาปัตยกรรม Windows ของคุณ บนพีซี x64 ตรวจสอบให้แน่ใจว่าโปรเซสเซอร์ของคุณรองรับ AVX2 ก่อนที่จะแก้ไขปัญหาการโหลดโมเดลในภายหลัง
มุมมองการดาวน์โหลดสำหรับ Windows ของ LM Studio เลือกตัวติดตั้งที่ตรงกับระบบ Windows 11 ของคุณก่อนดำเนินการต่อสู่การดาวน์โหลดโมเดล
เปิดใช้งาน LM Studio ขณะที่ยังมีการเชื่อมต่ออินเทอร์เน็ต สิ่งนี้สำคัญเพราะแอปอาจต้องดาวน์โหลดหรืออัปเดต LM Runtime LM Studio อธิบายรันไทม์ว่าเป็นเอนจินการอนุมานแบบแพ็กเกจ เช่น รันไทม์ที่อิงจาก llama.cpp สำหรับโมเดล GGUF การดาวน์โหลดรันไทม์ต้องมีการเชื่อมต่อแม้ว่าการอนุมานจะทำงานแบบออฟไลน์ได้หลังจากนั้น
ขั้นตอนที่ 2: ดาวน์โหลดโมเดล DeepSeek ที่เหมาะกับพีซีของคุณ
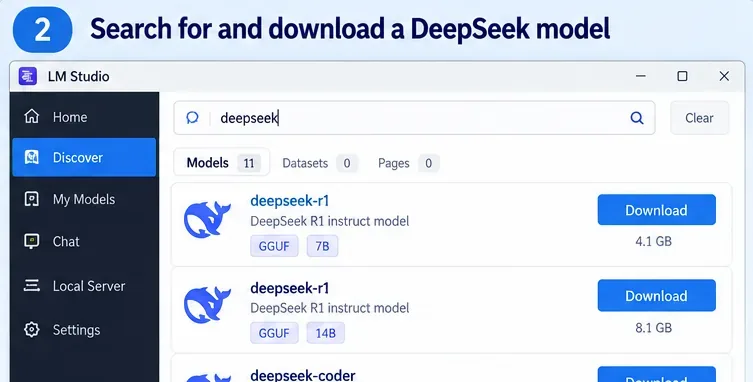
เปิดพื้นที่ Discover ใน LM Studio และค้นหา DeepSeek LM Studio สามารถค้นหาโมเดล Hugging Face ที่รองรับตามคำสำคัญ ตามตัวระบุ user/model หรือแม้แต่ URL Hugging Face แบบเต็ม
ค้นหา DeepSeek ใน Discover จากนั้นเลือกโมเดลและการควอนไทซ์ที่เหมาะสมกับฮาร์ดแวร์ของคุณ รายการแคตตาล็อกที่แน่นอนและขนาดไฟล์เปลี่ยนแปลงไปตามเวลา
คุณควรเลือกโมเดล DeepSeek ตัวไหน?
สำหรับคนส่วนใหญ่ที่ปฏิบัติตามคู่มือนี้ ให้เริ่มด้วย DeepSeek-R1-0528-Qwen3-8B LM Studio ระบุว่าโมเดลกลั่นขนาด 8B นี้รองรับการให้เหตุผลและการใช้เครื่องมือ มีให้ในรูปแบบ GGUF และสามารถใช้หน่วยความจำน้อยกว่าโมเดล DeepSeek รุ่นเรือธงมาก แนวทางของ LM Studio สำหรับ Windows ยังคงแนะนำให้มี RAM 16GB สำหรับแอปพลิเคชันโดยรวม ดังนั้นอย่าถือว่าข้ออ้างเรื่องหน่วยความจำต่ำเฉพาะโมเดลเป็นเป้าหมายที่สบายใจสำหรับทั้งระบบ
DeepSeek ยังได้ปล่อยเวอร์ชันกลั่น R1 ก่อนหน้าที่มีพารามิเตอร์ 1.5B, 7B, 8B, 14B, 32B และ 70B สิ่งเหล่านี้ให้พื้นที่ในการแลกเปลี่ยนความเร็วและการใช้หน่วยความจำกับความสามารถ ดู ที่เก็บ DeepSeek-R1 อย่างเป็นทางการ สำหรับรายละเอียดตระกูลโมเดลและใบอนุญาต และ บันทึกการรัน DeepSeek-R1-0528 แบบโลคัลของ LM Studio สำหรับตัวเลือก 8B
หากคุณถูกล่อลวงด้วย DeepSeek V4 Flash เพราะมันใหม่กว่า ให้ตรวจสอบข้อกำหนดฮาร์ดแวร์ก่อน บทความ V4 Flash อย่างเป็นทางการของ LM Studio ระบุว่าโมเดล Mixture-of-Experts ขนาด 284B ต้องใช้หน่วยความจำระบบอย่างน้อย 156GB สำหรับการใช่งานแบบโลคัล มันใช้งานได้ในเวิร์กสเตชันหน่วยความจำสูง ไม่ใช่แล็ปท็อป Windows ทั่วไป
ขั้นตอนที่ 3: โหลดโมเดลเข้าสู่หน่วยความจำ
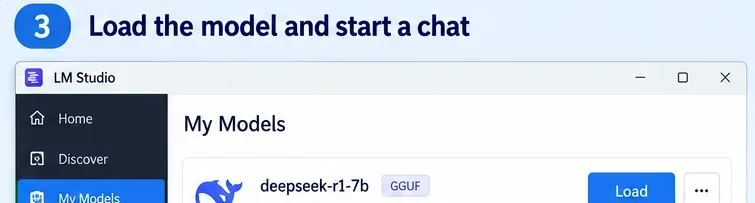
หลังจากดาวน์โหลดเสร็จสิ้น ไปที่โมเดลที่ดาวน์โหลดแล้วของคุณหรือเปิดตัวโหลดโมเดลจาก Chat เลือกโมเดล DeepSeek และโหลดมัน LM Studio อธิบายว่าการโหลดโมเดลจะจัดสรรหน่วยความจำสำหรับน้ำหนักโมเดลและสถานะรันไทม์ที่เกี่ยวข้อง
โมเดล DeepSeek GGUF ที่ดาวน์โหลดแล้วพร้อมโหลด หากการโหลดล้มเหลว ให้ลองใช้โมเดลที่เล็กกว่าหรือการควอนไทซ์ที่ใช้หน่วยความจำน้อยลงก่อนเปลี่ยนการตั้งค่าขั้นสูง
สำหรับการรันครั้งแรก ให้คงการตั้งค่าการโหลดไว้แบบอนุรักษ์นิยม หน้าต่างบริบทที่ใหญ่เกินไปอาจใช้หน่วยความจำเพิ่มเติมอย่างมาก ดังนั้นจึงมีเหตุผลน้อยมากที่จะเพิ่มขนาดบริบทให้สูงสุดทันที โหลดโมเดลด้วยบริบทที่พอประมาณ ตรวจสอบว่าทำงานได้ และขยายเฉพาะเมื่อภาระงานของคุณต้องการ
หาก LM Studio รายงานว่าโมเดลไม่พอดี วิธีแก้ไขที่เชื่อถือได้ที่สุดมักจะเป็นการเลือกโมเดลที่เล็กกว่าหรือการควอนไทซ์ที่กะทัดรัดกว่า การปิดแอปพลิเคชันที่ใช้หน่วยความจำมากอาจช่วยได้ แต่ไม่ได้เปลี่ยนขนาดพื้นฐานของโมเดล
ขั้นตอนที่ 4: ตัดการเชื่อมต่ออินเทอร์เน็ตและตรวจสอบว่า DeepSeek ทำงานแบบออฟไลน์จริงหรือไม่
นี่คือขั้นตอนที่แยกความแตกต่างระหว่าง “โมเดลโลคัล” กับเพียง “การใช้ไคลเอนต์เดสก์ท็อป” เมื่อโมเดลและรันไทม์ของมันติดตั้งแล้ว ให้ปิด Wi-Fi และตัดการเชื่อมต่อ Ethernet จากนั้นเริ่มแชทใหม่และส่งพรอมป์ง่ายๆ เช่น:
Explain the difference between RAM and VRAM in five bullet points.หากโมเดลตอบสนองขณะที่พีซีไม่มีการเชื่อมต่อเครือข่าย การอนุมานจะเป็นแบบโลคัล LM Studio ระบุว่าเมื่อ LLM อยู่ในเครื่องของคุณแล้ว มันสามารถทำงานแบบออฟไลน์ได้อย่างสมบูรณ์ และข้อความที่ป้อนในการแชท LLM โลคัลจะไม่ออกจากอุปกรณ์ของคุณ เอกสารออฟไลน์ของ LM Studio ยังระบุว่าการประมวลผลเอกสารโลคัลและ RAG ยังคงอยู่ในเครื่อง
โมเดล DeepSeek ที่โหลดแล้วกำลังตอบสนองใน LM Studio Chat เพื่อตรวจสอบการทำงานแบบออฟไลน์ด้วยตัวเอง ให้ตัดการเชื่อมต่อเครือข่ายหลังจากโมเดลและรันไทม์ดาวน์โหลดเสร็จสมบูรณ์และทำซ้ำพรอมป์ง่ายๆ
มีขอบเขตสำคัญ: การค้นหาโมเดล การดาวน์โหลดโมเดลใหม่ การดาวน์โหลดรันไทม์ และการตรวจสอบการอัปเดตแอป จำเป็นต้องมีการเชื่อมต่ออินเทอร์เน็ต หากคุณเพิ่มโมเดลคลาวด์ เซิร์ฟเวอร์ MCP ระยะไกล เครื่องมือเว็บ หรือการรวมระบบเครือข่ายอื่นๆ ในภายหลัง ฟีเจอร์เหล่านี้อาจต้องมีการเชื่อมต่อเช่นกัน ข้อกล่าวอ้างเรื่องความเป็นส่วนตัวแบบออฟไลน์ใช้กับขั้นตอนการทำงานแบบโลคัล ไม่ใช่บริการที่คุณเชื่อมต่อโดยตั้งใจในภายหลัง
LM Studio บันทึกขอบเขตเหล่านี้ใน คู่มือการทำงานแบบออฟไลน์อย่างเป็นทางการ
ขั้นตอนที่ 5: ทางเลือก—ใช้ DeepSeek ผ่าน API โลคัล
หากคุณต้องการให้แอปพลิเคชัน Windows อื่น สคริปต์ ส่วนขยาย IDE หรือเครื่องมือภายในเรียกใช้โมเดล DeepSeek โลคัลของคุณ LM Studio สามารถรันเซิร์ฟเวอร์โลคัลได้ เอกสารนักพัฒนาปัจจุบันระบุว่าคุณสามารถเริ่มมันจากหน้า Developer หรือด้วย:
lms server startโดยค่าเริ่มต้น เซิร์ฟเวอร์จะพร้อมใช้งานที่ http://localhost:1234 LM Studio ให้จุดสิ้นสุด REST แบบเนทีฟและจุดสิ้นสุดที่เข้ากันได้กับ OpenAI ตัวเซิร์ฟเวอร์เองสามารถทำงานแบบออฟไลน์ได้ตราบใดที่โมเดลและรันไทม์อยู่ในเครื่องแล้ว อย่างไรก็ตาม หากคุณเปิดเซิร์ฟเวอร์ให้เข้าถึงได้เกินกว่า localhost ให้ตรวจสอบการตั้งค่าการตรวจสอบสิทธิ์และการเข้าถึงเครือข่ายก่อน
ดู คู่มือเริ่มต้นใช้งาน REST API ของ LM Studio อย่างเป็นทางการ สำหรับรายละเอียดจุดสิ้นสุดและการตรวจสอบสิทธิ์ปัจจุบัน
ปัญหาที่พบบ่อยและการแก้ไขที่เร็วที่สุด
ปัญหา
สาเหตุที่เป็นไปได้
สิ่งที่ต้องทำ
โมเดลไม่โหลด
RAM/VRAM ไม่เพียงพอ บริบทใหญ่เกินไป หรือ CPU/รันไทม์ไม่รองรับ
ลองใช้โมเดล DeepSeek ที่เล็กกว่า การควอนไทซ์ที่เล็กกว่า หรือความยาวบริบทที่ต่ำลง บน Windows x64 ให้ตรวจสอบการรองรับ AVX2
LM Studio ทำงานออนไลน์แต่ไม่ทำงานหลังจากตัดการเชื่อมต่อ
โมเดลหรือรันไทม์ที่จำเป็นไม่ได้ดาวน์โหลดเสร็จสมบูรณ์
เชื่อมต่ออีกครั้ง เสร็จสิ้นการดาวน์โหลดโมเดล/รันไทม์ทั้งหมด โหลดโมเดลให้สำเร็จ จากนั้นทำซ้ำการทดสอบออฟไลน์
การสร้างช้ามาก
โมเดลใหญ่เกินไปสำหรับการเร่งความเร็ว GPU ที่มีอยู่และพึ่งพา CPU/หน่วยความจำระบบอย่างมาก
เลือกโมเดลหรือการควอนไทซ์ที่เล็กกว่า โมเดลที่ใหญ่กว่าไม่มีประโยชน์หากความหน่วงทำให้ขั้นตอนการทำงานไม่สะดวก
คุณหาโมเดลไม่พบขณะออฟไลน์
การค้นหาใน Discover ต้องมีการเชื่อมต่อเครือข่าย
ดาวน์โหลดโมเดลก่อนจะออฟไลน์ หรือโหลดโมเดลแบบ sideload จากไฟล์ที่ได้รับผ่านกระบวนการควบคุมอื่น
คุณคาดหวังให้ V4 Flash ทำงานบนแล็ปท็อปทั่วไป
ข้อกำหนดหน่วยความจำโลคัลของมันอยู่ในระดับเวิร์กสเตชัน
ใช้โมเดลกลั่น R1 แทน เว้นแต่เครื่องของคุณจะมีหน่วยความจำระบบประมาณ 156GB ขึ้นไป
เมื่อใดที่การตั้งค่านี้เหมาะสม
การรัน DeepSeek แบบออฟไลน์ด้วย LM Studio เหมาะสมอย่างยิ่งเมื่อคุณต้องการการอนุมานแบบโลคัลที่เป็นส่วนตัว ค่าใช้จ่ายที่คาดการณ์ได้หลังจากดาวน์โหลดโมเดล การทดลองโดยไม่มีคีย์ API หรือ API บน localhost สำหรับการพัฒนามันยังมีประโยชน์เมื่อเครื่องของคุณต้องทำงานต่อได้โดยไม่มีการเชื่อมต่ออินเทอร์เน็ต
มันเหมาะสมน้อยกว่าเมื่อคุณต้องการโมเดล DeepSeek ที่ทรงพลังที่สุดที่มีอยู่แต่มีเพียงฮาร์ดแวร์สำหรับผู้บริโภค เมื่อคุณต้องการปริมาณงานที่สูงมาก หรือเมื่อภาระงานของคุณขึ้นอยู่กับข้อมูลเว็บแบบเรียลไทม์ โมเดลโลคัลรู้เฉพาะสิ่งที่อยู่ในน้ำหนักของมันและบริบทที่คุณให้ เว้นแต่คุณจะเชื่อมต่อเครื่องมือภายนอกหรือแหล่งข้อมูลโดยตั้งใจ
เช็คลิสต์อย่างรวดเร็ว
ใช้ระบบ Windows 11 ที่ตรงตามข้อกำหนดของ LM Studio; CPU แบบ x64 ต้องมี AVX2
คงการเชื่อมต่ออินเทอร์เน็ตไว้สำหรับการดาวน์โหลด LM Studio รันไทม์ และโมเดลในครั้งแรก
เริ่มด้วยโมเดล DeepSeek GGUF ที่เล็กกว่า โดยเฉพาะโมเดลกลั่นระดับ 8B
เลือกการควอนไทซ์ 4-bit ขึ้นไปหากฮาร์ดแวร์ของคุณรองรับได้
โหลดโมเดลให้สำเร็จก่อนตัดการเชื่อมต่อเครือข่าย
ปิด Wi-Fi/Ethernet และรันพรอมป์ใหม่เพื่อตรวจสอบการอนุมานแบบออฟไลน์
ลดขนาดโมเดลหรือความยาวบริบทหากคุณพบข้อผิดพลาดด้านหน่วยความจำ
ใช้เซิร์ฟเวอร์ localhost ของ LM Studio เฉพาะเมื่อคุณต้องการการเข้าถึง API โลคัล
บทสรุป
วิธีที่ง่ายที่สุดในการรัน DeepSeek แบบออฟไลน์บน Windows 11 คือการจับคู่ LM Studio กับโมเดล DeepSeek GGUF ที่มีขนาดเล็กกว่าซึ่งพอดีกับฮาร์ดแวร์ของคุณจริงๆ สำหรับพีซีทั่วไป โมเดลกลั่น R1 ระดับ 8B เป็นจุดเริ่มต้นที่สมจริงกว่ามากเมื่อเทียบกับ DeepSeek V4 Flash เสร็จสิ้นการดาวน์โหลดขณะออนไลน์ โหลดโมเดล ตัดการเชื่อมต่อเครือข่าย และตรวจสอบว่าแชทใหม่ยังคงตอบสนอง เมื่อสิ่งนั้นทำงานได้ คุณมีการตั้งค่า DeepSeek แบบโลคัลอย่างแท้จริง ไม่ใช่เพียงตัวห่อหุ้มเดสก์ท็อปสำหรับ API คลาวด์