การลดบิล API ของ LLM ลง 50% เป็นไปได้ในหลายเวิร์กโหลด แต่ไม่ใช่การรับประกันสากล ผลลัพธ์ขึ้นอยู่กับแหล่งที่มาของการใช้จ่ายของคุณ: input tokens ที่ไม่ได้แคช, input tokens ที่แคชแล้ว, output tokens, reasoning tokens, การเรียกใช้เครื่องมือ (tool calls) หรือการลองใหม่ (retries) การบีบอัด Prompt ได้ผลดีที่สุดเมื่อ input ที่ยาวหรือซ้ำซ้อนเป็นส่วนสำคัญในบิล ดังนั้นเป้าหมายในทางปฏิบัติจึงไม่ใช่ "ทำให้ทุก prompt สั้นลงครึ่งหนึ่ง" แต่คือ "ลบ token ที่ไม่เปลี่ยนคำตอบ รักษา token ที่เปลี่ยนคำตอบ และตรวจสอบการประหยัดจากการใช้งานจริง"
คู่มือนี้ใช้ขั้นตอนการนำไปใช้ 4 ขั้นตอน: วัดค่าพื้นฐาน, ลบ input ที่ซ้ำซ้อน, จัดระเบียบ prompt เพื่อใช้ cache ซ้ำ และย้ายคำอธิบายผลลัพธ์ที่ยาวเหยียดไปเป็นการควบคุมแบบมีโครงสร้าง (structured controls) เมื่อ API รองรับ ตัวอย่างเหล่านี้เป็นเพียงภาพประกอบ ไม่ใช่ข้ออ้างจากการทดสอบมาตรฐาน ราคาของผู้ให้บริการและพฤติกรรมของ cache เปลี่ยนแปลงไปตามเวลา ดังนั้นควรตรวจสอบอัตราปัจจุบันก่อนประมาณการสำหรับการใช้งานจริง
การลดต้นทุน API ลง 50% ต้องทำอะไรบ้างจริงๆ?
เริ่มจากสมการการเรียกเก็บเงินสำหรับโมเดลของคุณ สำหรับเวิร์กโหลดข้อความง่ายๆ ต้นทุนคำขอรวมจะประมาณเท่ากับต้นทุนของ input ที่ไม่ได้แคช บวกกับ input ที่แคชแล้ว บวกกับ output บางโมเดลหรือฟีเจอร์อาจเพิ่มหมวดหมู่ที่ต้องชำระอื่นๆ การตอบสนองของ API ปัจจุบันของ OpenAI เผยแพร่การใช้ token input และ output รวมถึงรายละเอียดของ token ที่แคช และหน้าโมเดลของพวกเขาราคาแยกต่างหากสำหรับ input, input ที่แคชแล้ว และ output
| เวิร์กโหลดตัวอย่าง | Input tokens | Output tokens | ผลลัพธ์สัมพัทธ์ |
|---|
| คำขอพื้นฐาน | 10,000 | 1,000 | 100% ของต้นทุนพื้นฐาน |
| ตัด input ลงครึ่งเดียว | 5,000 | 1,000 | ประหยัดรวมได้น้อยกว่า 50% เมื่อ output ไม่เปลี่ยนแปลง |
| ตัดทั้ง input และ output ลงครึ่งหนึ่ง | 5,000 | 500 | ต้นทุนตาม token ต่ำลงประมาณ 50% เมื่ออัตราไม่เปลี่ยนแปลง |
สำหรับตัวอย่างปัจจุบันที่เป็นรูปธรรม หน้าโมเดล GPT-5.6 Sol อย่างเป็นทางการระบุไว้เมื่อวันที่ 11 กันยายน 2026 ว่า $4 ต่อล้าน input tokens, $0.40 ต่อล้าน cached input tokens และ $20 ต่อล้าน output tokens ที่อัตรานั้น คำขอที่มี input 10,000 และ output 1,000 มีค่าใช้จ่ายประมาณ $0.06 ก่อนค่าธรรมเนียมอื่นๆ การตัด input เหลือเพียง 5,000 tokens ทำให้ตัวอย่างนี้เหลือประมาณ $0.04 ซึ่งลดลง 33% การตัดทั้ง input และ output ลงครึ่งหนึ่งทำให้เหลือประมาณ $0.03 ซึ่งลดลง 50% ราคาเหล่านี้สามารถเปลี่ยนแปลงได้ ดังนั้นให้ถือว่าการคำนวณนี้เป็นวิธีการ ไม่ใช่ราคาถาวร ดูหน้าโมเดล GPT-5.6 Sol อย่างเป็นทางการสำหรับราคาปัจจุบัน
อ้างอิงด่วน: 4 การเคลื่อนไหวที่มีมูลค่าสูงสุด
| เทคนิค | เหมาะที่สุดสำหรับ | ความเสี่ยงหลัก | สิ่งที่ต้องวัด |
|---|
| การตรวจสอบ Token | เวิร์กโหลดการผลิตใดๆ | การเพิ่มประสิทธิภาพส่วนประกอบที่ผิด | Input, cached input, output, retries, ต้นทุนต่อภารกิจที่สำเร็จ |
| การลบความซ้ำซ้อน | System prompts ยาว, นโยบายซ้ำๆ, ตัวอย่างที่เยิ่นเย้อ | การลบข้อจำกัดที่สำคัญจริงๆ | ความสำเร็จของภารกิจและความเท่าเทียมในการปฏิบัติตามคำสั่ง |
| การจัดวางที่เอื้อต่อ Cache | คำขอซ้ำๆ ที่แชร์คำสั่งหรือบริบทที่เสถียร | การใช้ cache ซ้ำต่ำเพราะข้อความแบบไดนามิกปรากฏเร็วเกินไป | อัตราส่วน cached-token และ latency |
| การควบคุมผลลัพธ์แบบมีโครงสร้าง | การแยกข้อมูล JSON, การจำแนกประเภท, รูปแบบการตอบกลับที่ตายตัว | Schema แข็งทื่อเกินไปสำหรับภารกิจ | Output tokens, ความล้มเหลวในการวิเคราะห์, retries |
ขั้นตอนที่ 1: วัดค่าพื้นฐาน Token จริงก่อนเปลี่ยน Prompt
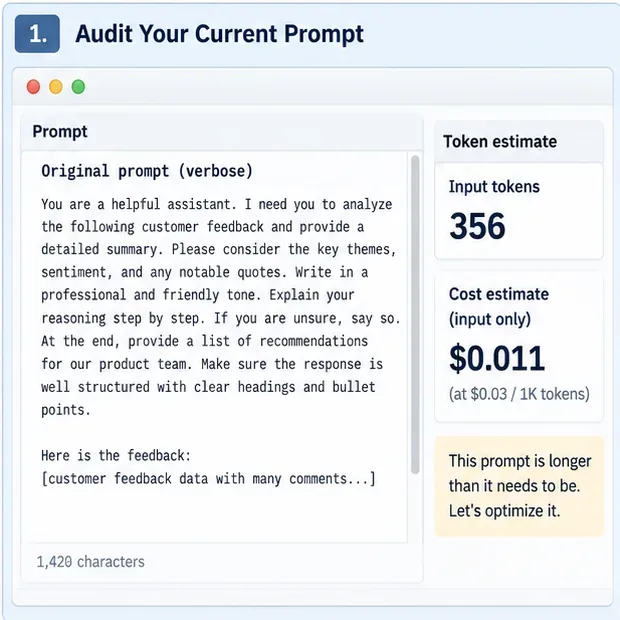
คำบรรยาย: อินเทอร์เฟซการตรวจสอบ token ตัวอย่างบันทึกขนาด prompt เดิมและประมาณการต้นทุนตัวอย่างก่อนการบีบอัด ตัวเลขเหล่านี้ไม่ใช่ราคาปัจจุบันของผู้ให้บริการ
รวบรวมตัวอย่างคำขอในการผลิตที่เป็นตัวแทน แทนที่จะเพิ่มประสิทธิภาพ prompt ที่เลือกด้วยมือเพียงอันเดียว อย่างน้อยที่สุด ให้บันทึก input tokens, cached input tokens เมื่อมีให้, output tokens, ชื่อโมเดล, latency, retries และว่าคำตอบสุดท้ายผ่านการตรวจสอบคุณภาพทางธุรกิจของคุณหรือไม่ หากผู้ให้บริการของคุณมีจุดสิ้นสุดการนับ input-token ให้ใช้ก่อนส่งคำขอเมื่อคุณต้องการงบประมาณที่แน่นอน OpenAI ปัจจุบันบันทึกจุดสิ้นสุดการนับ input-token ของ Responses ไว้ในอ้างอิง API อย่างเป็นทางการ
คำนวณต้นทุนต่อภารกิจที่สำเร็จ ไม่ใช่แค่ต้นทุนต่อ API call Prompt ที่บีบอัดซึ่งทำให้เกิด retries มากขึ้นอาจมีราคาแพงกว่าแม้ว่าแต่ละคำขอจะสั้นลงก็ตาม แบ่งส่วนค่าพื้นฐานตามประเภทภารกิจด้วย: การสรุป, การแยกข้อมูล, การตอบคำถาม RAG, การใช้เครื่องมือแบบเอเจนต์ และการสนทนายาวๆ มักมีโปรไฟล์ token ที่แตกต่างกัน
ขั้นตอนที่ 2: ลบความซ้ำซ้อนโดยไม่ลบข้อมูลที่สำคัญต่อการตัดสินใจ

คำบรรยาย: Prompt ก่อนและหลังตัวอย่างยังคงผลลัพธ์ที่ขอไว้เหมือนเดิมโดยลบคำพูดที่ซ้ำกันและคำแนะนำกระบวนการที่ไม่จำเป็น
การบีบอัดครั้งแรกที่ปลอดภัยที่สุดคือการกำจัดความซ้ำซ้อนทางความหมาย (semantic deduplication) ลบคำอธิบายบทบาทที่ซ้ำกัน, ข้อจำกัดที่ซ้ำกัน, คำเติมสุภาพ, คำอธิบายรูปแบบที่ชัดเจน และตัวอย่างที่สอนรูปแบบเดียวกันมากกว่าหนึ่งครั้ง รวมกฎที่ทับซ้อนกันเป็นคำสั่งเดียว ชอบประโยคที่แม่นยำหนึ่งประโยคมากกว่าหลายประโยคที่กล่าวถึงข้อกำหนดเดียวกันซ้ำๆ
ก่อน
You are a helpful assistant who is an expert in product analysis.
I need you to analyze the following customer feedback and provide
a detailed summary. Please identify the key themes, overall sentiment,
notable quotes, and recommendations for our product team. Make sure
your response is professional, clear, concise, and well structured.
หลัง
Analyze the customer feedback.
Return: key themes, overall sentiment, notable quotes, and product recommendations.
Be concise and factual.
อย่าบีบอัดข้อยกเว้น, ขอบเขตนโยบาย, นิยามโดเมน, กฎความปลอดภัยของเครื่องมือ หรือข้อกำหนดหลักฐาน เพียงเพราะมันยาว สิ่งเหล่านั้นมักเป็น token ที่มีมูลค่าสูง การทดสอบที่มีประโยชน์คือถามว่า: "ถ้าฉันลบประโยคนี้ ผลลัพธ์ที่ยอมรับได้สามารถเปลี่ยนแปลงได้หรือไม่" ถ้าใช่ ให้เก็บไว้เว้นแต่การควบคุม API หรือ schema จะสามารถบังคับพฤติกรรมเดียวกันได้อย่างเชื่อถือได้มากกว่า
ขั้นตอนที่ 3: วางเนื้อหาที่เสถียรไว้ก่อนและเนื้อหาแบบไดนามิกไว้หลัง
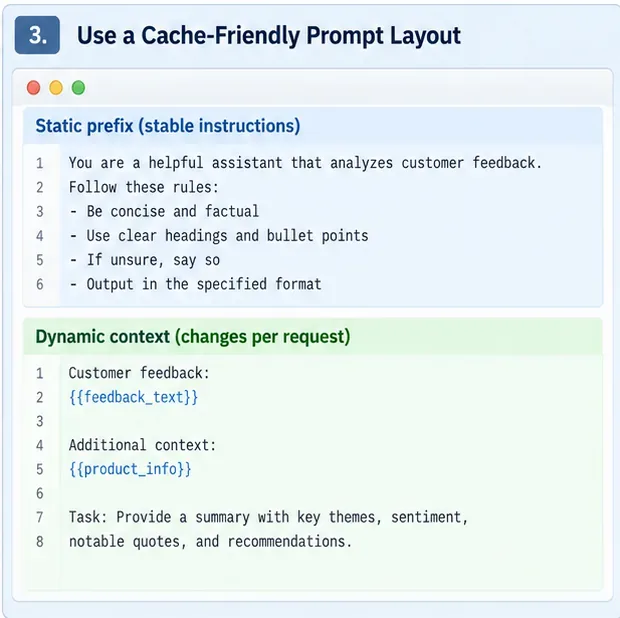
คำบรรยาย: การจัดวาง prompt ตัวอย่างวางคำสั่งที่เสถียรไว้ใน prefix ที่นำกลับมาใช้ใหม่ได้และต่อท้ายบริบทเฉพาะคำขอในภายหลัง
Prompt caching ไม่ได้ลดจำนวน token ดิบ แต่สามารถลดจำนวนที่เรียกเก็บในอัตรา input ปกติและลด latency ในการประมวลผล prompt ได้ สิ่งนี้ทำให้การจัดวาง prompt เป็นส่วนหนึ่งของการเพิ่มประสิทธิภาพต้นทุน รวมคำสั่งระบบ, ตัวอย่างที่แชร์, คำแนะนำเครื่องมือ และเนื้อหาที่เสถียรอื่นๆ ไว้ด้วยกัน วางข้อเท็จจริงเฉพาะคำขอ, ข้อความที่ดึงมา, ข้อมูลผู้ใช้ และคำถามปัจจุบันไว้ภายหลัง
คำแนะนำโมเดลของ OpenAI แนะนำอย่างชัดเจนให้วางเนื้อหาแบบคงที่ไว้ก่อนและเนื้อหาแบบไดนามิกไว้หลังเพื่อปรับปรุงการใช้ prompt-cache ซ้ำ และอ็อบเจกต์การใช้ response ของมันเผยแพร่ข้อมูล cached-token สำหรับการวัดผล ดูคำแนะนำโมเดลอย่างเป็นทางการและอ้างอิง Responses API
หลีกเลี่ยงการเปลี่ยนช่องว่างที่ไร้พิษภัย, ลำดับตัวอย่าง, เวลาประทับ, ID สุ่ม หรือข้อความต่อผู้ใช้ภายใน prefix ที่นำกลับมาใช้ใหม่ได้ เว้นแต่ความหมายของ cache ของผู้ให้บริการจะระบุว่า การเปลี่ยนแปลงเหล่านั้นปลอดภัย วัด cache hits จาก response ของ API แทนที่จะสมมติว่า prompt กำลังถูกนำกลับมาใช้ใหม่
ขั้นตอนที่ 4: แทนที่ข้อความเกี่ยวกับรูปแบบด้วยการควบคุมผลลัพธ์แบบมีโครงสร้าง
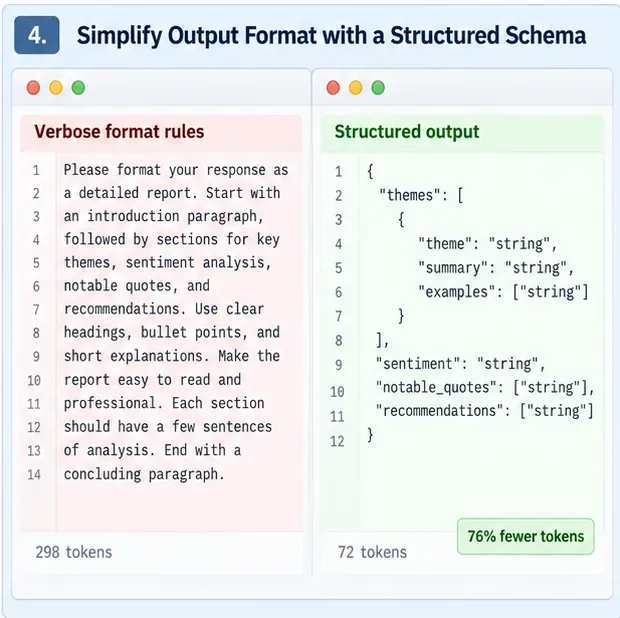
คำบรรยาย: มุมมองผลลัพธ์แบบมีโครงสร้างตัวอย่างแสดงว่า schema สามารถแทนที่ข้อความหลายบรรทัดที่อธิบายรูปร่างการตอบกลับเดียวกันซ้ำๆ ได้อย่างไร
Prompt สำหรับการแยกข้อมูลและการจำแนกประเภทมักเสีย token ไปกับการอธิบายฟิลด์ JSON, ค่าที่อนุญาต, การซ้อนกัน, ลำดับ และกฎการตรวจสอบในภาษาธรรมชาติ เมื่อ API รองรับผลลัพธ์แบบมีโครงสร้างหรืออาร์กิวเมนต์เครื่องมือแบบมีประเภท ให้ย้ายสัญญาส่วนใหญ่นั้นไปยังอินเทอร์เฟซแบบมีโครงสร้างและคงคำแนะนำภาษาธรรมชาติให้เน้นที่ความหมาย
คำแนะนำปัจจุบันของ OpenAI แนะนำโดยเฉพาะให้ลบคำนิยาม output-schema จาก prompt เมื่อเป็นไปได้และใช้ Structured Outputs แทน สิ่งนี้สามารถลดข้อความ prompt และลด retries ของผลลัพธ์ที่ผิดรูปแบบได้ กลไกที่แน่นอนแตกต่างกันไปตามผู้ให้บริการ ดังนั้นอย่าคัดลอกรูปแบบคำขอเฉพาะของ OpenAI ไปยัง API อื่นโดยไม่ตรวจสอบเอกสารของผู้ให้บริการนั้น
การบีบอัดขั้นสูงสำหรับ RAG, เอกสารยาว และการสนทนา
หลังจากขั้นตอนพื้นฐาน 4 ขั้นตอนเสถียรแล้ว การประหยัดที่ใหญ่กว่ามักมาจากการลดบริบทมากกว่าการขัดเกลาถ้อยคำประโยค ในระบบ RAG ให้ดึงข้อความ fewer but more relevant passages, กำจัดความซ้ำซ้อนของ chunks ที่เกือบเหมือนกัน และหลีกเลี่ยงการแนบเอกสารที่ไม่สามารถเปลี่ยนคำตอบได้ สำหรับการสนทนายาวๆ ให้เก็บข้อเท็จจริงถาวรและการตัดสินใจที่ยังไม่แก้ไข แต่สรุปหรือทิ้งรอบการสนทนาที่ไม่มีอิทธิพลต่อภารกิจปัจจุบันอีกต่อไป สำหรับระบบเอเจนต์ ให้เปิดเผยเฉพาะเครื่องมือและคำอธิบายเครื่องมือที่เกี่ยวข้องกับขั้นตอนปัจจุบันเมื่อสถาปัตยกรรมของคุณอนุญาตอย่างปลอดภัย
ตัวบีบอัด prompt ที่เรียนรู้ได้เป็นอีกตัวเลือกหนึ่งสำหรับบริบทที่ยาวมาก โปรเจกต์โอเพนซอร์สของ Microsoft LLMLingua นำเสนอการบีบอัด prompt ระดับ token เอกสาร LLMLingua เดิมรายงานอัตราส่วนการบีบอัดสูงถึง 20 เท่าพร้อมการลดลงของ benchmark ที่จำกัดในการตั้งค่าที่ประเมิน LongLLMLingua มุ่งเน้นภารกิจบริบทยาว ในขณะที่ LLMLingua-2 ใช้ตัวบีบอัดที่เรียนรู้ได้แบบไม่ขึ้นกับภารกิจ สิ่งเหล่านี้เป็นผลจากการวิจัย ไม่ใช่คำสัญญาว่าอัตราส่วนเดียวกันจะรักษาคุณภาพในข้อมูลของคุณ ให้ทดสอบ benchmark ภารกิจ, ภาษา, โมเดล และประเภท prompt ของคุณเองก่อนนำไปใช้การบีบอัดที่รุนแรง
วิธีพิสูจน์ว่าการเพิ่มประสิทธิภาพดีกว่าจริงๆ
ดำเนินการประเมินแบบ A/B บนคำขอที่เป็นตัวแทนเดียวกัน เวอร์ชันพื้นฐานและเวอร์ชันบีบอัดควรใช้โมเดล, การตั้งค่าการให้เหตุผล, เครื่องมือ, อินพุตการดึงข้อมูล และเกณฑ์ความสำเร็จเดียวกัน เปลี่ยนเทคนิคการบีบอัดทีละอย่างเมื่อเป็นไปได้เพื่อให้คุณสามารถระบุสิ่งที่ทำให้เกิดการถดถอย
| เมตริก | ทำไมจึงสำคัญ | การตีความที่แนะนำ |
|---|
| การลด Input-token | แสดงการหดตัวของ prompt ดิบ | มีประโยชน์ แต่ไม่เพียงพอเพียงอย่างเดียว |
| อัตราส่วน Cached-token | แสดงว่า prefix ที่เสถียรถูกนำกลับมาใช้ใหม่หรือไม่ | สูงกว่ามักดีกว่าเมื่อคุณภาพไม่เปลี่ยนแปลง |
| การลด Output-token | สามารถเปลี่ยนต้นทุนรวมได้อย่างมีนัยสำคัญ | ตรวจสอบว่าผลลัพธ์ที่กระชับยังคงทำภารกิจสำเร็จ |
| ต้นทุนต่อภารกิจที่สำเร็จ | รวม retries และความล้มเหลว | นี่คือเมตริกทางธุรกิจหลัก |
| ความสำเร็จของภารกิจ / ความแม่นยำ | ตรวจจับการสูญเสียข้อมูล | กำหนดเกณฑ์ความไม่ด้อยกว่าที่ยอมรับได้ก่อนการทดสอบ |
| latency p50 และ p95 | แสดงผลกระทบจริงต่อผู้ใช้ | การประมวลผลล่วงหน้าของการบีบอัดสามารถชดเชยการประหยัดการอนุมานได้ |
อย่าประกาศชัยชนะเพราะ prompt สั้นลง 50% เงื่อนไขการยอมรับที่แข็งแกร่งกว่าคือ: การกำหนดค่าที่บีบอัดลดต้นทุนที่วัดได้โดยประมาณตามเป้าหมายของคุณ ในขณะที่อยู่ในความทนทานต่อคุณภาพ, latency และความน่าเชื่อถือที่กำหนดไว้ล่วงหน้า
เมื่อใดควรหยุดบีบอัด?
หยุดหรือถอยกลับเมื่อการลดครั้งถัดไปลบข้อเท็จจริงที่จำเป็นสำหรับการตัดสินใจที่ถูกต้อง, เพิ่มอาการหลอน (hallucinations), ทำให้เกิดข้อผิดพลาดในการเรียกใช้เครื่องมือ, ทำให้อ่อนแอลงในการปฏิบัติตามนโยบาย หรือเพิ่ม retries มากพอที่จะลบการประหยัด การบีบอัดยังสามารถเพิ่ม latency หากคุณรันโมเดลแยกต่างหากเพื่อบีบอัดแต่ละ prompt การศึกษาปี 2026 เกี่ยวกับการบีบอัด prompt ในการตั้งค่าการอนุมานจริง พบว่าโอเวอร์เฮดของการประมวลผลล่วงหน้าสามารถยกเลิกการ gains จากการอนุมานนอกเหนือจาก regimes ความยาว prompt และฮาร์ดแวร์ที่เอื้ออำนวย ซึ่งเป็นอีกเหตุผลหนึ่งในการวัดประสิทธิภาพแบบ end-to-end แทนที่จะเป็นจำนวน token เพียงอย่างเดียว
สำหรับ prompt ขนาดเล็ก การทำความสะอาดด้วยตนเองและการจัดระเบียบที่เอื้อต่อ cache มักจะสมเหตุสมผลกว่าการเพิ่มโมเดลบีบอัดเฉพาะ สำหรับ payload RAG ขนาดใหญ่หรือเวิร์กโฟลว์หลายเอกสาร การเลือกบริบทและการบีบอัดที่เรียนรู้ได้กลายเป็นน่าสนใจมากขึ้นเพราะปริมาณ token ที่ลบออกได้มีมากกว่ามาก
รายการตรวจสอบการนำไปใช้ด่วน
- จับค่าพื้นฐานในการผลิตพร้อม input, cached input, output, latency, retries และความสำเร็จของภารกิจ
- ลบคำสั่งที่ซ้ำกัน, ข้อความที่มีมูลค่าต่ำ และตัวอย่างที่ซ้ำซ้อนก่อน
- รักษานิยามโดเมน, ข้อยกเว้น, ข้อกำหนดหลักฐาน และข้อจำกัดความปลอดภัย
- วางเนื้อหา prompt ที่เสถียรก่อนเนื้อหาแบบไดนามิกเฉพาะคำขอ เมื่อความหมายของ cache ให้รางวัลกับ prefix ที่นำกลับมาใช้ใหม่ได้
- ใช้ผลลัพธ์แบบมีโครงสร้างหรือ schemas เครื่องมือ แทนการอธิบายรูปแบบการตอบกลับที่ตายตัวซ้ำๆ ในข้อความ
- สำหรับ RAG ลดบริบทที่ไม่เกี่ยวข้องและซ้ำซ้อนก่อนลองการบีบอัดระดับ token
- จำกัดความยาวผลลัพธ์เฉพาะเมื่อภารกิจยังคงทำสำเร็จได้อย่างถูกต้อง
- เปรียบเทียบต้นทุนต่อภารกิจที่สำเร็จ ไม่ใช่แค่จำนวน token ของ prompt
- รันการทดสอบถดถอยก่อนและหลังการเปลี่ยนแปลงการบีบอัดที่มีความหมายทุกครั้ง
- ตรวจสอบราคาของผู้ให้บริการและกฎ cache ใหม่ทุกครั้งที่เปลี่ยนโมเดลหรือเวอร์ชัน API
บทสรุป
การลดลง 50% เป็นเป้าหมายทางวิศวกรรมที่สมเหตุสมผลสำหรับเวิร์กโหลดบางประเภทที่เยิ่นเย้อและเน้นบริบท แต่ควรได้รับการปฏิบัติในฐานะผลลัพธ์ที่ต้องตรวจสอบ ไม่ใช่ความคาดหวังเริ่มต้น เส้นทางที่เชื่อถือได้ที่สุดคือการวัดก่อน, ลบข้อความที่ซ้ำซ้อนทางความหมาย, เพิ่มการใช้ cache ซ้ำอย่างปลอดภัย, สั้นลงสัญญาผลลัพธ์ด้วยการควบคุมแบบมีโครงสร้าง จากนั้นโจมตีบล็อกบริบทที่เหลือที่ใหญ่ที่สุดด้วยการตัดแต่งการดึงข้อมูล, การสรุป หรือตัวบีบอัด prompt ที่ทดสอบแล้ว หากต้นทุนสุดท้ายต่อภารกิจที่สำเร็จลดลงในขณะที่คุณภาพยังคงอยู่ในแถบการยอมรับของคุณ การบีบอัดกำลังทำงาน หากคุณภาพหรือ retries แย่ลง ให้กู้คืนข้อมูลที่หายไปและเพิ่มประสิทธิภาพส่วนอื่นของคำขอ
อ้างอิงหลัก








